Cloud vs. lokal
Entscheidungskriterien für Datenhoheit, Kosten und Latenz.
Entscheidungskriterien für Datenhoheit, Kosten und Latenz. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
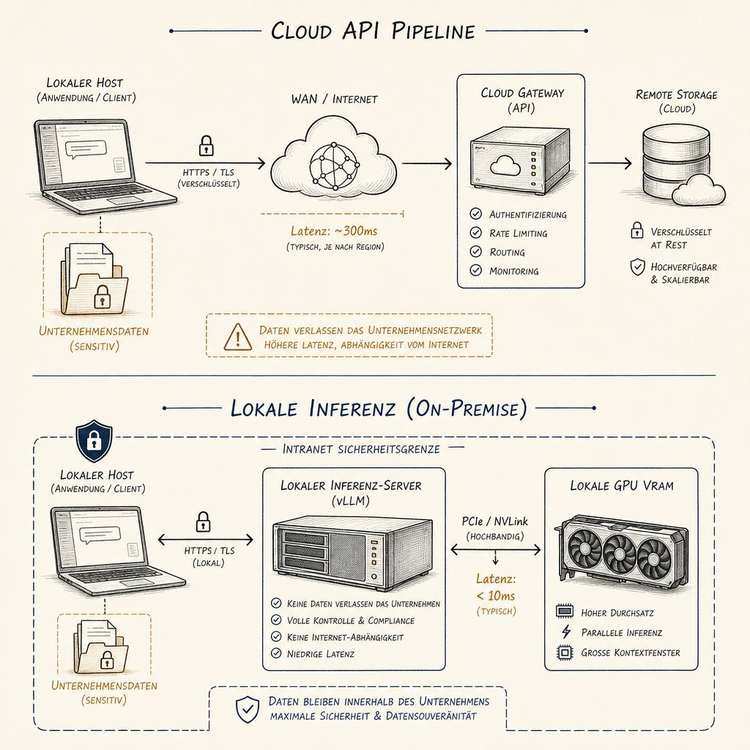
Kapitel 1: Cloud vs. Lokal – Strategische und Technische Entscheidungskriterien
Die Architektur-Entscheidung zwischen cloudbasierten Large Language Model (LLM) APIs und selbst gehosteter lokaler Inferenzinfrastruktur bestimmt grundlegend die Datensicherheitsgrenzen, Kostenkurven, Latenzcharakteristiken und funktionale Autonomie eines Unternehmens. Die Integration externer KI-Endpunkte verlagert Datenflüsse über ungesicherte Vertrauensgrenzen, während On-Premise- und Edge-Systeme deterministische Kontrolle über Speicherzustände, Ausführungslogik und Betriebskosten ermöglichen.
+-------------------------------------------------------------------------------+
|                             DATENFLUSS-VERGLEICH                              |
+-------------------------------------------------------------------------------+

[Cloud API Architektur]
+--------------+     HTTPS / WAN      +------------------+     Prozessspeicher  +-------------------+
| Lokaler Host | -------------------> | Cloud Gateway    | -------------------> | Multi-Tenant GPU  |
|  (Sensible   |   (Latenz 120-600ms) | (Logging, Filter)|                      | (US/EU Datacenter)|
|  Unternehmens| <------------------- | (Rate Limits)    | <------------------- | (Shared Memory)   |
|   Daten)     |     JSON Tokens      +------------------+     Token-Stream     +-------------------+
+--------------+                                                                  | Persistent Logs |
                                                                                  | (Opt-Out/30 Tage) |
                                                                                  +-------------------+

[On-Premise Inferenz Architektur]
+---------------------------------------------------------------------------------------------------+
| Enterprise Intranet / DMZ (Zero External WAN Traffic)                                             |
|                                                                                                   |
| +--------------+     PCIe / NVLink     +---------------------+     SRAM / HBM      +------------+ |
| | Application  | --------------------> | Local Inferenz-Srv  | ------------------> | Lokale GPU | |
| | Service      |   (Latenz < 10ms)     | (vLLM / llama.cpp)  |  (1.0 - 3.3 TB/s)   | VRAM       | |
| | (ERP / CRM)  | <-------------------- | (C++ Engine / CUDA) | <------------------ | (Isolated) | |
| +--------------+      Raw Tokens       +---------------------+     Logit Stream    +------------+ |
+---------------------------------------------------------------------------------------------------+
1.1 Datensouveränität, Datenschutz und Rechtliche Rahmenbedingungen
DSGVO Art. 28 vs. Art. 44 ff.: Das Drittlandübermittlungs-Dilemma
Die Übermittlung von Produktivdaten an externe KI-Dienstleister unterliegt strengen regulatorischen Auflagen nach der Datenschutz-Grundverordnung (DSGVO).
- Art. 28 DSGVO (Auftragsverarbeitung):
Erfordert den Abschluss eines rechtsgültigen Auftragsverarbeitungsvertrags (AVV), der Weisungsgebundenheit, technische und organisatorische Maßnahmen (TOM) sowie Prüfrechte festschreibt. - Art. 44 ff. DSGVO (Drittlandübermittlung):
Wird die Inferenzinfrastruktur durch US-amerikanische Hyperscaler (Microsoft Azure OpenAI, AWS Bedrock, Google Cloud Vertex AI, OpenAI Direct API) bereitgestellt, greift das Drittlandtransfer-Regime.
Die Wahl eines EU-Rechenzentrums beendet eine Drittlandprüfung nicht automatisch. Bei einem Anbieter mit US-Muttergesellschaft können insbesondere Zugriffsmöglichkeiten nach dem US CLOUD Act (18 U.S.C. § 2713) relevant sein; der Act knüpft an Daten in der Verfügungsgewalt des Providers an und bedeutet nicht automatisch, dass jede Verarbeitung rechtswidrig ist. Transfermechanismus, Anbieterrolle, technische Maßnahmen und konkrete Datenkategorien müssen im Einzelfall geprüft werden.
+-------------------------------------------------------------------------------+
|                    RECHTLICHE PRÜFUNG DES DATENTRANSFERS                     |
+-------------------------------------------------------------------------------+
                                      |
             Enthält der Prompt PII oder Geschäftsgeheimnisse?
                         /                         \
                       Ja                          Nein
                       |                             |
     Transferprüfung nach Art. 44 ff.,       Cloud API grundsätzlich möglich;
     AVV/TOM, Anbieterrolle,                   AVV, Löschung, Logging und
     Datenstandort und CLOUD-Act-Risiko       Anbieterbedingungen trotzdem prüfen
                       |
       Hoher Schutzbedarf oder unklare Rechtslage?
                         /                         \
                       Ja                          Nein
                       |                             |
      lokale oder souveräne, vertraglich       dokumentierte Freigabe mit
      und technisch geprüfte Inferenz          technischen Schutzmaßnahmen
+-------------------------------------------------------------------------------+
Das Data Privacy Framework (DPF) als Nachfolger von Privacy Shield und Safe Harbor steht unter anhaltendem rechtlichem Vorbehalt (Risiko eines "Schrems III"-Urteils des EuGH). Für Unternehmen mit hohen Compliance-Anforderungen (KRITIS, Banken gem. DORA, Gesundheitswesen gem. § 203 StGB) stellt die Auslagerung von Klartextdaten in Hyperscaler-APIs ein permanentes Rechts- und Haftungsrisiko dar.
Zero Data Retention (ZDR) APIs vs. Vollständige On-Prem Isolation
Kommerzielle API-Anbieter bieten Enterprise-Verträge mit sogenannten Zero Data Retention (ZDR) Policies an. Die technischen Unterschiede zur lokalen Inferenz sind fundamental:
| Eigenschaft | Cloud API (Standard) | Cloud API (Enterprise ZDR) | Lokale Inferenz (On-Prem) |
|---|---|---|---|
| Trainingsnutzung | Oft Opt-Out nötig | Vertraglich ausgeschlossen | Physikalisch unmöglich |
| Abuse Monitoring Logs | 30 Tage Klartext-Speicherung | 0 Tage (Genehmigungspflichtig) | Vollständig unter interner Kontrolle |
| In-Memory Isolation | Shared Host OS / Virt. GPUs | Shared Host OS / Virt. GPUs | Dedizierte Bare-Metal Hardware |
| Netzwerkpfad | Public Internet / TLS | DirectConnect / ExpressRoute | Lokales PCIe-Subsystem / Isolated LAN |
| Air-Gap Tauglichkeit | Nein (Erfordert WAN) | Nein (Erfordert WAN) | Ja (Vollständig offline betreibbar) |
| Auditierbarkeit | SOC2 Typ II Report (Dritter) | SOC2 Typ II Report (Dritter) | Vollständige Syslog-/Kernel-Audits |
Bei ZDR-APIs verbleiben die Daten während der Inferenz im flüchtigen Speicher (RAM/HBM) des Anbieters. Das Restrisiko von Memory-Dumps, Side-Channel-Angriffen in Multi-Tenant-Virtualisierungen (z. B. vGPU-Leaks) und Fehlkonfigurationen auf Provider-Seite kann nicht durch eigene Sicherheitsmaßnahmen mitigiert werden.
Schutz nach dem Geschäftsgeheimnisgesetz (GeschGehG)
Gemäß § 2 Nr. 1 GeschGehG gilt eine Information nur dann als gesetzlich geschütztes Geschäftsgeheimnis, wenn sie Gegenstand von angemessenen Geheimhaltungsmaßnahmen durch ihren Inhaber ist.
                 +---------------------------------------------------+
                 | Angemessene Geheimhaltungsmaßnahmen nach GeschGehG |
                 +---------------------------------------------------+
                                           |
          +--------------------------------+--------------------------------+
          |                                                                 |
+------------------------------------+            +------------------------------------+
| Unzureichend (Risiko Verlust)      |            | Erfüllt (Rechtsschutz gesichert)   |
+------------------------------------+            +------------------------------------+
| - Unkontrollierte Prompt-Eingabe   |            | - Isolierte On-Prem Inferenz       |
| - Standard Cloud APIs ohne ZDR     |            | - Verschlüsseltes Storage (LUKS)   |
| - Mangelnde RBAC & Logging-Systeme |            | - RBAC auf Modellebene             |
| - Datenübertragung an US-Dritte    |            | - Keine WAN-Verbindungen           |
+------------------------------------+            +------------------------------------+
Werden vertrauliche Daten (Quellcode, CAD-Daten, F&E-Berichte, Fusionspläne) unverschlüsselt an externe Cloud-APIs gesendet, kann dies vor Gericht als grobe Fahrlässigkeit ausgelegt werden. Der Status als "Geschäftsgeheimnis" entfällt rückwirkend, wodurch zivilrechtliche Unterlassungs- und Schadensersatzansprüche bei Datenlecks erlöschen.
1.2 Kostenstruktur, Durchsatz und Latenz
Token-Abrechnung vs. Capex/Opex-TCO
Die Wirtschaftlichkeitsrechnung zwischen API-Konsum und Eigenbetrieb hängt primär vom verarbeiteten Token-Volumen pro Zeiteinheit ab.
Kostenmodell Cloud APIs (illustrative Momentaufnahme; Preise und Modellnamen vor Einsatz beim Anbieter verifizieren)
- Tier-1 Spitzenmodelle (Beispiele zum Redaktionszeitpunkt):
- Input: $2.50 bis $3.00 pro 1.000.000 Token
- Output: $10.00 bis $15.00 pro 1.000.000 Token
- Durchschnittlicher Mischpreis (bei 3:1 Input/Output-Verhältnis): ~$4.50 bis $6.00 pro Mio. Token.
- Tier-2 Standardmodelle (Beispiele zum Redaktionszeitpunkt):
- Input: $0.15 bis $0.25 pro 1.000.000 Token
- Output: $0.60 bis $1.25 pro 1.000.000 Token
- Durchschnittlicher Mischpreis: ~$0.35 pro Mio. Token.
Kostenmodell Lokale Inferenz (Capex & Opex)
Betrachten wir zwei typische Unternehmens-Setups:
-
Dual-GPU Workstation (Entwicklung / Mittelstand):
- Hardware (Capex): 2x NVIDIA GeForce RTX 4090 (48 GB VRAM total), AMD Threadripper/EPYC, 128 GB DDR5 ECC, NVMe PCIe 4.0: ~6.500 €
- Abschreibung: 36 Monate = 180,55 € / Monat
- Leistungsaufnahme Vollast: ~750 W (System total).
- Strompreis: 0,30 € / kWh $\rightarrow$ $0,75\text{ kW} \times 0,30\text{ €/kWh} = 0,225\text{ € / Betriebsstunde}$.
- Bei 24/7 Volllast (720h/Monat): 162,00 € / Monat.
- Opex Total (inkl. Wartung/Klima ~40 €): ~382,55 € / Monat.
-
Enterprise Quad-GPU Server (Produktion / High-Concurrency):
- Hardware (Capex): 4x NVIDIA RTX 6000 Ada (192 GB VRAM) oder 8x RTX 4090: ~35.000 €
- Abschreibung: 36 Monate = 972,22 € / Monat
- Leistungsaufnahme: ~1.800 W Vollast $\rightarrow$ 388,80 € / Monat Stromkosten.
- Opex Total: ~1.500,00 € / Monat.
    Monatliche
    Kosten (€)
        ^
 5.000  |                                                / Cloud API (Tier-1 Spitzenmodelle)
        |                                               /
 4.000  |                                              /
        |                                             /
 3.000  |                                            /
        |                                           /
 2.000  |                         -----------------/---------------- Enterprise Server (4x RTX 6000)
        |                        /                /                  [Break-Even: ~350M Token/Mo]
 1.000  |          -------------/----------------/------------------ Workstation (2x RTX 4090)
        |         /            /                /                    [Break-Even: ~80M Token/Mo]
     0  +--------+------------+----------------+-------------------> Tokenvolumen / Monat
        0       50M          100M             350M             1 Mrd
Break-Even-Berechnung
Für ein Modell der 70B-Klasse (z. B. Llama 3.3 70B Q4_K_M oder DeepSeek-R1-Distill-70B), das auf einer Dual-4090-Workstation mit vLLM / TensorRT-LLM betrieben wird:
- Durchsatz: ~45 Token/s (Generation) bei Continuous Batching bis zu 180 Token/s aggregiert.
- Maximaler Durchsatz pro Monat (24/7):
$$180\text{ Token/s} \times 3600\text{ s/h} \times 720\text{ h} = 466.560.000\text{ Token/Monat}$$ - Entsprechende Kosten bei Tier-1 Cloud API ($5.00 / Mio Token):
$$466{,}56\text{ Mio} \times 5{,}00\text{ $} \times 0{,}92\text{ €/$} \approx 2.146\text{ €/Monat}$$
$$\text{Break-Even-Point (Dual-4090)} = \frac{382{,}55\text{ €}}{0{,}0000046\text{ €/Token}} \approx 83.163.000\text{ Token/Monat}$$
Ergebnis: Bereits ab einem Volumen von ca. 83 Millionen Token pro Monat (entspricht etwa 2,7 Millionen Token oder ca. 5.500 Dokumentenseiten pro Tag) ist die eigene Hardware-Infrastruktur ökonomisch rentabler als Tier-1 Cloud-APIs.
Latenz-Architektur: Time to First Token (TTFT) und Inter-Token Latency (ITL)
Die Inferenzlatenz setzt sich aus zwei orthogonalen Phasen zusammen:
- Prefill Phase (TTFT): Verarbeitung des Eingabe-Prompts ($O(N^2)$ Rechenaufwand bei naivem Attention-Mechanismus, compute-bound).
- Decode Phase (ITL): Autoregressive Generierung der Ausgabetoken ($O(N)$ Rechenaufwand, memory-bandwidth-bound).
+-------------------------------------------------------------------------------+
|                       LATENZ-AUFSCHLÜSSELUNG IM DETAIL                        |
+-------------------------------------------------------------------------------+

Cloud API (WAN):
|<- DNS/TLS ->|<- Queueing ->|<- Remote Prefill ->|<- Decode (WAN Stream) ->|
[  35-80 ms  ] [  50-400 ms ] [    80-300 ms     ] [  25-60 ms pro Token   ]
|                                                 |
+-------------------------------------------------+
| Total Time to First Token (TTFT): 165 - 780 ms  | (Extremer Jitter bei Lastspitzen)

Lokale Inferenz (LAN / PCIe 4.0):
|<- IPC/UNIX Socket ->|<- Local Prefill (FlashAttn) ->|<- Decode (HBM/GDDR6X) ->|
[      < 1 ms        ] [          15-45 ms           ] [     12-25 ms pro Token ]
|                                                     |
+-----------------------------------------------------+
| Total Time to First Token (TTFT): 16 - 46 ms        | (Deterministisch, 0 ms WAN-Jitter)
In interaktiven Systemen (Autocomplete in IDEs, Sprachschnittstellen / Realtime Voice Agents, Robotersteuerungen) kann WAN-Jitter zu spürbaren Rucklern führen. Lokale Inferenz kann sehr niedrige TTFT und stabile Token-Generierungsraten ermöglichen; konkrete Werte hängen jedoch von Modell, Kontextlänge, Hardware, Batching und Implementierung ab.
1.3 Zensur, Alignment und Kontrollverlust
Fremde System-Prompts und Refusals bei legitimen Domänen
Kommerzielle Cloud-APIs implementieren mehrstufige, intransparente Moderationsschichten (RLHF, DPO und vorgeschaltete Klassifikatoren), um Reputations- und Haftungsrisiken des Anbieters zu minimieren. Dies führt zu systematischen Überreaktionen (False Positives) bei fachspezifischen Aufgabenstellungen:
- IT-Sicherheit & Penetration Testing:
Analyse von Exploit-Payloads, Reverse Engineering von Malware-Binaries oder Generierung von Fuzzing-Skripten werden von Cloud-APIs standardmäßig als "Malicious Activity" verweigert (Refusal). - Medizin & Pharmazie:
Klinische Falldiskussionen über Toxikologie, Dosierungen von Betäubungsmitteln oder pathologische Befunde triggern Sicherheitsfilter bezüglich "Self-Harm" oder "Controlled Substances". - Recht & Kriminologie:
Verarbeitung von Gerichtsakten zu Gewalt- oder Sexualdelikten wird durch Inhaltsfilter geblockt.
+-------------------------------------------------------------------+
|                  CLOUD API MODERATION PIPELINE                    |
+-------------------------------------------------------------------+
  User Prompt
      |
      v
  [Layer 1: Input Moderation Classifier] ----> Blocked? ---> Refusal Error
      | (Versteckt, nicht konfigurierbar)
      v
  [Layer 2: Hardcoded System Prompt / Hidden Prefix]
      | ("You are a helpful and harmless assistant...")
      v
  [Layer 3: Aligned LLM Inferenz]
      | (Über-zensiert durch DPO / RLHF)
      v
  [Layer 4: Output Moderation Filter] --------> Blocked? ---> Stream Abort
      |
      v
  Finales Token an Anwender
Bei Open-Weights-Modellen (z. B. Llama 3.3, Qwen 2.5, DeepSeek-V3) liegt die vollständige Kontrolle über die System-Prompts und Sampling-Parameter beim Betreiber.
Stille Modell-Updates und Prompt-Drift
Cloud-Provider optimieren ihre Modelle kontinuierlich im Hintergrund (Quantisierungsanpassungen, Routing-Änderungen in Mixture-of-Experts-Architekturen, Updates der Alignment-Filter), oft unter Beibehaltung desselben Modell-Tags (z. B. gpt-4o-latest).
- Folge: Determinismus in Enterprise-Pipelines geht verloren. Ein Prompt, der am Tag 1 strukturierte JSON-Ausgaben mit 99,8% Validität lieferte, kann an Tag 30 durch geändertes Token-Pruning Syntaxfehler generieren (Prompt Drift).
- Lokaler Vorteil: Das Modell-Gewicht (z. B. SHA256-Hash der GGUF- oder Safetensors-Datei) ist unveränderlich fixiert. Regressionstests und Evaluierungsmetriken bleiben über Jahre reproduzierbar.
Eigene Enterprise Guardrails
Lokale Systeme ersetzen intransparente Fremdfilter durch deterministische, unternehmensspezifische Kontrollmechanismen:
                                PROMPT
                                   |
                                   v
             +-------------------------------------------+
             |         LOKALE GUARDRAIL PIPELINE         |
             +-------------------------------------------+
             |                                           |
             |  1. Regex / PII Masking (Presidio/Regex)  |
             |     - Anonymisiert IBAN, SVN, Namen       |
             |                                           |
             |  2. Semantic Guard (Llama-Guard 3 8B)     |
             |     - Eigene Policy: Coder/Sec/Med        |
             |                                           |
             |  3. NeMo Guardrails / Guidance            |
             |     - Deterministische Zustandsautomaten  |
             |                                           |
             +-------------------------------------------+
                                   |
                                   v
                      +-------------------------+
                      | Lokales Inferenz-Modell |
                      |   (Unzensiert/Fachlich) |
                      +-------------------------+
                                   |
                                   v
             +-------------------------------------------+
             |          OUTPUT VALIDATION ENGINE         |
             +-------------------------------------------+
             |  - JSON-Schema Enforcement (Grammars)     |
             |  - Egress PII Check                       |
             +-------------------------------------------+
                                   |
                                   v
                             VALIDIERTER OUTPUT
Tools wie NeMo Guardrails oder Llama-Guard 3 ermöglichen die präzise Definition von Ausführungsregeln via Colang oder programmatischen Policies, ohne die Domänenkompetenz des Kernmodells zu kastrieren.
1.4 Die Mobilitäts-Analogie: Taxi vs. Eigenes Fahrzeug
Zur strategischen Entscheidungsfindung eignet sich die Gegenüberstellung von Individualverkehr und Fahrdienstleistungen:
+------------------------------------+------------------------------------+
|         CLOUD LLM API              |         LOKALE INFRASTRUKTUR       |
|          ("Das Taxi")              |        ("Das eigene Fahrzeug")     |
+------------------------------------+------------------------------------+
| + Keine Anschaffungskosten (Capex) | - Hohe Anschaffungskosten (Capex)  |
| + Sofortige Verfügbarkeit          | - Erfordert Know-How für Setup     |
| - Hohe Kosten pro gefahrenem KM    | + Nahezu Null Grenzkosten pro KM   |
| - Fahrer bestimmt die Route        | + Volle Kontrolle über Ziel & Weg  |
| - Gepäck/Gespräche nicht privat    | + Vollständige Privatsphäre        |
| - Keine Fahrt bei Streik/Ausfall   | + Funktioniert offline/im Wald     |
+------------------------------------+------------------------------------+
Wann Cloud APIs sinnvoll sind:
- Proof-of-Concepts (PoC): Schnelle Validierung von Use Cases ohne Hardware-Investition.
- Extreme Lastspitzen: Seltene Batches mit extrem hohen Anforderungen an kurzzeitige Skalierung.
- Multi-Billion-Parameter Bedarfe: Aufgaben, die zwingend Frontier-Modelle jenseits von 400B Parametern erfordern, falls keine Server-Cluster bereitstehen.
Wann Lokale Inferenz zwingend ist:
- Regulierte Datenströme: Verarbeitung von Geschäftsgeheimnissen, PII, Patientendaten, Finanzdaten.
- Hohe Grundlast: Kontinuierliche Workloads (> 100 Mio. Token/Monat).
- Echtzeitsysteme: Sub-50ms Anforderungen in LAN, Fertigung oder Robotik.
- Air-Gapped Umgebungen: Militär, Nachrichtendienste, Kraftwerke, Hochsicherheitsnetzwerke ohne WAN-Uplink.
Die Wahl lokaler Inferenz ist keine bloße Kostenoptimierung, sondern eine architektonische Grundsatzentscheidung für Datenhoheit, Systemstabilität und technologische Unabhängigkeit.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.