Modell-Landschaft
Open Weights, Reasoning, Vision und Spezialmodelle.
Open Weights, Reasoning, Vision und Spezialmodelle. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
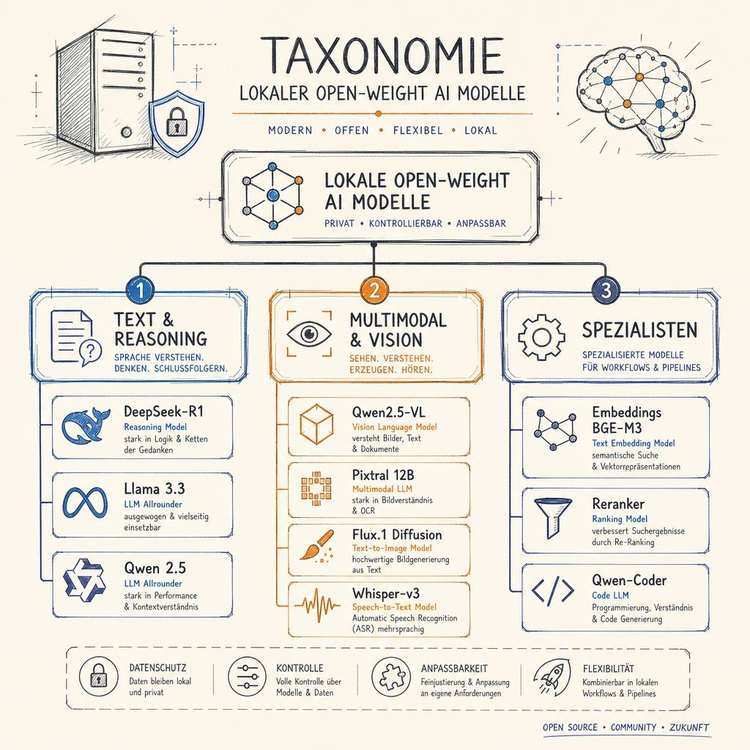
Kapitel 2: Die Modell-Landschaft 2026 – Open Weights von Text bis Multimodal
Die Open-Weights-Landschaft des Jahres 2026 zeichnet sich durch hochspezialisierte Architekturen aus, die proprietären Frontier-Modellen in spezifischen Domänen ebenbürtig oder überlegen sind. Während frühere Generationen auf monolithischen dichten Transformern basierten, dominieren moderne Architekturen mit Sparse Mixture-of-Experts (MoE), Multi-Head Latent Attention (MLA), DeepSeek Reasoning R1-Modellen und hybriden Vision-Sprach-Systemen.
+-----------------------------------------------------------------------------------------------+
|                       OPEN WEIGHTS TAXONOMIE & ÖKOSYSTEM 2026                                 |
+-----------------------------------------------------------------------------------------------+
|                                                                                               |
|  [TEXT & REASONING]           [MULTIMODAL & VISION]              [SPEZIALISTEN]               |
|  +-------------------------+  +-------------------------------+  +--------------------------+ |
|  | - DeepSeek-R1 / V3      |  | - Qwen2-VL / Qwen2.5-VL       |  | - Embeddings:            | |
|  |   (671B MoE / 37B act.) |  |   (Dynamic Resolution VLM)    |  |   BGE-M3, Nomic-Embed    | |
|  | - Llama 3.3 (70B Dense) |  | - Pixtral 12B (Mistral Vision)|  | - Reranker:              | |
|  | - Qwen 2.5 (0.5B - 72B) |  | - Llama 3.2 Vision (11B, 90B) |  |   bge-reranker-large     | |
|  | - Mistral Large 2 (123B)|  | - Diffusion:                  |  | - Code:                  | |
|  | - Gemma 2 (9B, 27B)     |  |   Flux.1 (Dev/Schnell), SDXL  |  |   Qwen 2.5-Coder 32B/72B | |
|  | - Small/Edge:           |  | - Audio:                      |  |   DeepSeek-Coder-V2      | |
|  |   Llama 3.2 1B/3B       |  |   Whisper-v3-turbo, Kokoro    |  |                          | |
|  +-------------------------+  +-------------------------------+  +--------------------------+ |
+-----------------------------------------------------------------------------------------------+
2.1 Text-Modelle (LLMs): Foundation, Instruct und Reasoning
Moderne Textmodelle werden in drei primären Ausprägungsstufen trainiert und ausgeliefert:
- Foundation / Base Models: Reine Next-Token-Prediction auf Terabytes von Web- und Fachkorpora. Ungeeignet für direkte Chat-Interaktion, primär genutzt für weiteres Domain-Pretraining.
- Instruct / Chat Models: Mittels Supervised Fine-Tuning (SFT) und Direct Preference Optimization (DPO) / RLHF auf Befolgung von System-Prompts, Formatvorgaben und Konversationslogik ausgerichtet.
- Reasoning Models (Chain-of-Thought / RL): Modelle wie DeepSeek-R1, die vor der finalen Antwort explizite, unzensierte Denkketten (
<think>...</think>) generieren. Trainiert über Reinforcement Learning (RL) mit Verifizierern (Rule-Based Verifiers) auf mathematische, logische und algorithmische Korrektheit.
DeepSeek-V3 und DeepSeek-R1: Architektur-Durchbruch
DeepSeek-V3 und dessen reasoning-optimierte Variante R1 stellen mit 671 Milliarden Gesamtparametern, von denen pro Token lediglich 37 Milliarden Parameter aktiviert werden (MoE), einen fundamentalen Effizienzsprung dar.
+-------------------------------------------------------------------------------+
|                 DEEPSEEK-V3 / R1 ARCHITEKTUR-MERKMALE                         |
+-------------------------------------------------------------------------------+

1. Multi-Head Latent Attention (MLA):
   Traditioneller KV-Cache pro Token:  [Key 1, Key 2 ... Key H] [Val 1 ... Val H]
   DeepSeek MLA komprimierter Vektor:  [Latent KV Vector c_KV] (Kompressionsfaktor ~6x)
   --> Dramatische Reduktion des VRAM-Bedarfs für lange Kontexte (bis 128k).

2. DeepSeek Sparse MoE:
   Gesamt: 256 geroutete Experten + 1 Shared Experte (konstant aktiv).
   Aktivierung: Top-8 Experten pro Token via Sigmoid-Gating + Normalisierung.
   Aktive Parameter: ~37B von 671B -> Durchsatz einer 37B-Dense-Engine!
DeepSeek-R1 Distillationsserie
Für lokale Umgebungen mit begrenztem VRAM existieren offizielle Distillationen auf dichte Architekturen:
- DeepSeek-R1-Distill-Qwen-1.5B / 7B / 14B / 32B
- DeepSeek-R1-Distill-Llama-8B / 70B
Diese destillierten Modelle kombinieren die Reasoning-Muster der 671B-Originalmodelle mit dem kompakten Footprint etablierter Transformer.
Llama-Familie (Llama 3.1 & Llama 3.3)
Die von Meta veröffentlichten Gewichte der Llama-3-Serie setzen den Standard für dichte Architekturen:
- Llama 3.3 70B: Bietet die Leistungsfähigkeit des früheren Llama 3.1 405B bei einem Bruchteil des Rechenaufwands. Standardmäßig mit Grouped-Query Attention (GQA, 8 KV-Heads) und nativem 128k-Kontextfenster ausgestattet.
- Llama 3.1 8B: Das Standard-Edge-Modell für ressourcenbeschränkte Systeme (Workstations, Embedded-Systeme, On-Device).
- Llama 3.2 1B / 3B: Extrem leichtgewichtige Modelle für lokale Vorfilterung, Classification und Function Calling auf Mobil-CPUs.
Qwen 2.5 Serie: Maximale Sprachenvielfalt und Kontextskalierung
Die von Alibaba entwickelte Qwen-2.5-Serie reicht von 0.5B bis 72B Parametern:
- Qwen 2.5 72B Instruct: Führendes Open-Weights-Modell in mehrsprachigen Benchmarks (inklusive exzellenter deutscher Grammatik- und Fachterminologie-Beherrschung), stark in strukturierter Datenextraktion und Tool-Use.
- Qwen 2.5 14B & 32B: Die idealen "Sweet-Spot"-Modelle für Single-GPU-Workstations (RTX 4090 / RTX 5090 mit 24–32 GB VRAM).
- Unterstützt nativer Kontext bis zu 128k Token mit YARN-Rotary-Embedding-Erweiterungen.
Mistral AI Portfolio
- Mistral Large 2 (123B): Entwickelt für komplexe Enterprise-Reasoning-Workloads mit nativer Code- und Mehrsprachenunterstützung (128k Kontext).
- Mistral NeMo (12B): In Kooperation mit NVIDIA trainiert; zeichnet sich durch den neuen Tekken-Tokenizer (optimiert für Coder und europäische Sprachen) aus.
- Mistral Small 3 (24B): Kompaktes Dense-Modell für Low-Latency Agentensysteme.
2.2 Multimodal & Vision: Sehen, Hören und Generieren
+-------------------------------------------------------------------------------+
|                       MULTIMODALE INFERENZ-PIPELINE                           |
+-------------------------------------------------------------------------------+

[Dokument / Bild] ----> [Vision Encoder / Patch Extraction]
                                  |
                                  v (Projizierte Image Embeddings)
[System / User Prompt] -> [LLM Backbone (Qwen2-VL / Pixtral)] -> [Strukturierter Output]
                                                                    (JSON / Markdown)

[Audio Stream] ---------> [Mel-Spektrogramm] -> [Whisper-v3-turbo] -> [Text Transkript]
                                                                            |
[Text Output] ----------> [Kokoro-82M / StyleTTS2] ------------------> [Audio Stream (WAV)]
Vision-Language Models (VLMs)
Die direkte Extraktion strukturierter Daten aus unstrukturierten visuellen Quellen (gescannte Rechnungen, technische Zeichnungen, Dashboards, GUI-Screenshots) wird von spezialisierten Vision-LLMs übernommen:
- Qwen2-VL / Qwen2.5-VL (7B, 72B):
- Dynamic Resolution: Bilder werden nicht auf fixe 224x224 oder 448x448 Kacheln herunterskaliert, sondern dynamisch in variable Patch-Tokens konvertiert. Dies erhält kleinste Details in Schaltplänen und PDF-Tabellen.
- Video-Verarbeitung: Unterstützt native Video-Streams über zeitlich indizierte Vision-Tokens.
- Pixtral 12B (Mistral AI):
- Nativer 12B-Vision-Transformer mit 128k Kontextfenster. Exzellente Balance aus Bildverarbeitungsgeschwindigkeit und Text-Reasoning.
- Llama 3.2 Vision (11B & 90B):
- Integrierter Vision-Adapter auf Basis vortrainierter Llama-3.1-Gewichte für Document-QA und Image-Captioning.
Bildgenerierung: Diffusion & Flow Matching
Für die lokale Bild- und Grafikgenerierung im Enterprise-Bereich (Marketing-Assets, synthetische Trainingsdaten, Produkt-Mockups):
- Flux.1 (Black Forest Labs):
- Flux.1 Dev: 12B Parameter Flow-Matching Transformer für High-End-Generierung mit fotorealistischer Typografie und Detailtreue.
- Flux.1 Schnell: Destillierte 4-Step-Inferenz für Sub-Sekunden-Generierung auf Consumer-GPUs.
- Stable Diffusion XL (SDXL) / SD 3.5:
- Weiterhin relevant für hochgradig anpassbare Pipelines via ControlNet, IP-Adapter und LoRA-Ökosysteme.
Audio: Transkription und Sprachsynthese
- Spracherkennung (ASR):
- Whisper large-v3-turbo: Von OpenAI optimierte Version mit 4 Decoder-Layern (statt 32 in Large-V3). Bietet ca. 4x schnellere Inferenz bei vernachlässigbarem Word Error Rate (WER) Anstieg.
- Faster-Whisper (CTranslate2): Bis zu 8x schneller als Standard-PyTorch-Implementierungen durch optimierte INT8/FP16 CUDA-Kernel.
- Sprachsynthese (TTS):
- Kokoro-82M: Extrem leichtgewichtiges TTS-Modell (82M Parameter), liefert hochqualitative Sprachausgabe mit 20–30x Echtzeit-Geschwindigkeit auf Standard-CPUs.
2.3 Spezialisten: Embeddings, Reranker und Code-Modelle
Für Enterprise RAG (Retrieval-Augmented Generation) und Software-Engineering-Automatisierung sind General-Purpose-LLMs ineffizient und teuer. Spezialisierte Modelle übernehmen Teilaufgaben mit maximaler Präzision.
+-------------------------------------------------------------------------------+
|                      ENTERPRISE RAG PIPELINE TOPOLOGIE                        |
+-------------------------------------------------------------------------------+

Dokument-Korpus (PDF, Confluence, SQL)
      |
      v
[Embedding-Modell: BGE-M3 / Nomic] ----> Dense/Sparse Vektoren ----> [Vektordatenbank]
                                                                            |
Suchanfrage (User Query)                                                    |
      |                                                                     v
[Query Embedding] ----------------------------------------------> Top-100 Matches (Bi-Encoder)
                                                                            |
                                                                            v
[Cross-Encoder Reranker: BGE-Reranker-Large] -------------------> Top-5 Relevante Chunks
                                                                            |
                                                                            v
[LLM Context: Qwen 2.5-Coder / Llama 3.3] ----------------------> Faktenbasierte Antwort
Embedding-Modelle (Bi-Encoder)
Bi-Encoder transformieren Textsegmente in hochdimensionale dichte Vektoren ($d \in [768, 1024, 4096]$).
- BGE-M3 (BAAI):
- Unterstützt Multi-Lingualität (>100 Sprachen), Multi-Functionality (Dense Retrieval, Sparse Lexical Matching wie BM25 und Multi-Vector ColBERT) und lange Kontexte bis 8.192 Token.
- Nomic-Embed-Text-v1.5:
- Open-Weights Embedding-Modell mit Matryoshka-Representation Learning (Dimensionsanpassung von 64 bis 768 Dimensionen ohne massiven Qualitätsverlust zur Speicheroptimierung).
- E5-Mistral-7B-Instruct:
- LLM-basiertes Embedding-Modell für komplexe semantische Retrieval-Szenarien.
Cross-Encoder Reranker
Während Bi-Encoder Dokumente isoliert einbetten, berechnen Cross-Encoder die volle Self-Attention zwischen Query $q$ und Dokument $d$ ($[q; d]$) gemeinsam:
$$\text{Score} = \sigma\left(W \cdot \text{Transformer}([q; d])\right)$$
- BGE-Reranker-Large / BGE-Reranker-v2-M3:
- Unverzichtbar für Enterprise RAG. Filtert die Top-100 Ergebnisse des initialen Vektor-Retrievals auf die Top-3 bis Top-5 Chunks herunter und eliminiert False Positives drastisch.
Code-Spezialisten (Coder LLMs)
- Qwen 2.5-Coder (32B & 72B):
- Weltweit führendes Open-Weights-Modell für Softwareentwicklung. Übertrifft in Standard-Benchmarks (HumanEval, EvalPlus, MBPP) proprietäre Modelle wie GPT-4o im Generieren syntaktisch korrekten Codes, Debugging, Repository-Level Reasoning und FIM (Fill-in-the-Middle).
- DeepSeek-Coder-V2 (16B / 236B MoE):
- Unterstützt über 300 Programmiersprachen, Git-Diff-Verarbeitung und 128k Kontextfenster für vollständige Repository-Analysen.
2.4 Modell-Vergleichsmatrix (Stand 2026)
| Modell | Architektur | Parameter (Total / Aktiv) | Kontext | Min. VRAM (FP16) | Min. VRAM (Q4_K_M) | Primärer Einsatzzweck |
|---|---|---|---|---|---|---|
| DeepSeek-R1 | MoE + MLA | 671B / 37B | 128k | 1.340 GB | ~380 GB (Q4) | Komplexe Logik, Math, Reasoning |
| DeepSeek-R1-Distill-Qwen-32B | Dense | 32.5B / 32.5B | 128k | 65 GB | 20 GB | Single-GPU Reasoning Workstation |
| Llama 3.3 70B Instruct | Dense (GQA) | 70.6B / 70.6B | 128k | 141 GB | 42 GB | Enterprise General Assistant |
| Qwen 2.5 72B Instruct | Dense (GQA) | 72.7B / 72.7B | 128k | 145 GB | 44 GB | Mehrsprachig, Tool-Calling, RAG |
| Qwen 2.5-Coder 32B | Dense (GQA) | 32.5B / 32.5B | 128k | 65 GB | 20 GB | Code Completion, Refactoring |
| Mistral Large 2 | Dense | 123B / 123B | 128k | 246 GB | 74 GB | Enterprise Reasoning, Multilingual |
| Pixtral 12B | VLM | 12B / 12B | 128k | 24 GB | 8 GB | OCR, Dokument-QA, Multimodal |
| BGE-M3 | Bi-Encoder | 560M / 560M | 8k | 1.2 GB | 0.6 GB | Semantische Suche, Dense/Sparse RAG |
| BGE-Reranker-Large | Cross-Encoder | 560M / 560M | 512 | 1.2 GB | 0.6 GB | RAG Re-Ranking Stage |
| Whisper-v3-turbo | Audio ASR | 809M / 809M | 30s Seg. | 1.6 GB | 0.8 GB | Speech-to-Text Transkription |
Die Wahl des Zielmodells richtet sich somit exakt nach den verfügbaren VRAM-Budgets und dem spezifischen Anwendungsprofil – von 800-MB-Embeddings bis zum Multi-GPU MoE-Cluster.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.