Vokabular & Mathematik
Tokens, Quantisierung, Attention und KV-Cache.
Tokens, Quantisierung, Attention und KV-Cache. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
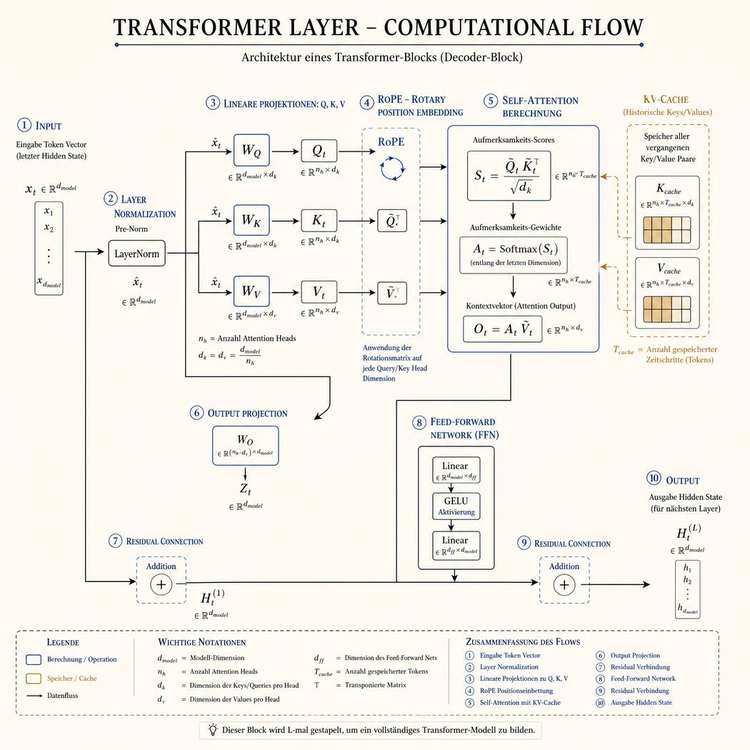
Kapitel 3: Vokabular & Mathematik lokaler LLMs – Von Parametern bis KV-Cache
Der Betrieb lokaler Sprachmodelle erfordert ein exaktes mathematisches Verständnis der zugrundeliegenden Transformer-Mechanik. Speicherallokation, Rechenkomplexität, Quantisierungsverluste und Inferenzdurchsatz lassen sich deterministisch aus den architektonischen Hyperparametern berechnen.
+-------------------------------------------------------------------------------+
|                       TRANSFORMER LAYER RECHENABLAUF                          |
+-------------------------------------------------------------------------------+

Input Token Vektor x in R^{d_model}
  |
  +---> [LayerNorm / RMSNorm]
  |       |
  |       v
  |     [Q, K, V Projektionen: W_Q, W_K, W_V]
  |       |
  |       +---> [RoPE: Rotary Positional Embedding auf Q und K]
  |       |
  |       +---> [Attention Score: Softmax( (Q * K^T) / sqrt(d_k) ) * V]
  |       |       ^
  |       |       | (Historische Keys & Values aus KV-Cache geladen)
  |       v
  |     [O Projektion: W_O]
  |       |
  +-----> (+) Residual Connection
  |
  +---> [LayerNorm / RMSNorm]
  |       |
  |       v
  |     [Feed-Forward Network (FFN / SwiGLU: W_gate, W_up, W_down)]
  |       |
  +-----> (+) Residual Connection
  |
Output Hidden State in R^{d_model}
3.1 Was ist ein Parameter? Lineare Algebra der Gewichtsmatrizen
Ein Parameter in einem künstlichen neuronalen Netz ist ein lernbarer Skalarwert (Gewicht oder Bias). In modernen Transformern sind diese Gewichte in zweidimensionalen Matrizen $W \in \mathbb{R}^{d_{\text{in}} \times d_{\text{out}}}$ organisiert.
Ein einzelner Transformer-Layer besteht aus zwei Hauptblöcken:
- Multi-Head Attention (MHA) Block:
- $W_Q \in \mathbb{R}^{d_{\text{model}} \times (n_{\text{heads}} \cdot d_{\text{head}})}$
- $W_K \in \mathbb{R}^{d_{\text{model}} \times (n_{\text{kv_heads}} \cdot d_{\text{head}})}$
- $W_V \in \mathbb{R}^{d_{\text{model}} \times (n_{\text{kv_heads}} \cdot d_{\text{head}})}$
- $W_O \in \mathbb{R}^{(n_{\text{heads}} \cdot d_{\text{head}}) \times d_{\text{model}}}$
- Feed-Forward Network (FFN / SwiGLU Block):
- $W_{\text{gate}} \in \mathbb{R}^{d_{\text{model}} \times d_{\text{ffn}}}$
- $W_{\text{up}} \in \mathbb{R}^{d_{\text{model}} \times d_{\text{ffn}}}$
- $W_{\text{down}} \in \mathbb{R}^{d_{\text{ffn}} \times d_{\text{model}}}$
Die Gesamtanzahl der Parameter $P$ eines Modells mit $n_{\text{layers}}$ Layern summiert sich näherungsweise zu:
$$P \approx n_{\text{layers}} \cdot \left( d_{\text{model}} \cdot (d_{\text{q}} + 2 d_{\text{kv}} + d_{\text{model}}) + 3 \cdot d_{\text{model}} \cdot d_{\text{ffn}} \right) + V \cdot d_{\text{model}}$$
wobei $V$ die Vokabulargröße des Tokenizers bezeichnet (z. B. 128.256 bei Llama 3 oder 152.064 bei Qwen 2.5).
+-------------------------------------------------------------------------------+
|                       MODELL-SKALIERUNG UND SPEICHERBEDARF                    |
+-------------------------------------------------------------------------------+
  Skalierung      Parameterzahl     FP16 Footprint     Q4_K_M Footprint
     8B              8,03 Mrd          16,06 GB            4,85 GB
    14B             14,77 Mrd          29,54 GB            8,90 GB
    32B             32,50 Mrd          65,00 GB           19,80 GB
    70B             70,55 Mrd         141,10 GB           43,20 GB
Der Speicherbedarf für die reinen Modellgewichte bei einer numerischen Präzision von $b$ Bits pro Parameter berechnet sich nach:
$$\text{Speicher}_{\text{Weights}} = \frac{P \times b}{8 \times 1024^3}\text{ [GiB]}$$
3.2 Numerische Präzision & Quantisierung: FP16 bis INT4
Modelle werden typischerweise in 16-Bit Gleitkommazahlen (FP16 oder BF16) trainiert. Beim quantisierten Laden werden Gewichte von Gleitkommawerten auf diskrete Integer-Gitter abgebildet.
FP16 (16-Bit Float):
[ Sign (1b) | Exponent (5b) | Mantisse / Fraction (10b) ]  -> 2 Bytes / Param

BF16 (16-Bit Bfloat):
[ Sign (1b) | Exponent (8b) | Mantisse / Fraction (7b)  ]  -> 2 Bytes / Param

INT8 (8-Bit Integer):
[ Vorzeichenbehafteter Integer: -128 bis +127 ]           -> 1 Byte / Param

INT4 (4-Bit Integer):
[ Vorzeichenbehafteter Integer: -8 bis +7 ]               -> 0.5 Bytes / Param
Quantisierungs-Mathematik: Affine Transformation
Die Standard-Quantisierung bildet einen Block von Gleitkommagewichten $W_{\text{float}}$ über Skalierungsfaktoren $S$ (Scale) und Nullpunkte $Z$ (Zero Point) auf Integer-Werte $W_{\text{quant}}$ ab:
$$W_{\text{quant}} = \text{round}\left(\frac{W_{\text{float}}}{S}\right) + Z$$
Die Rekonstruktion (Dequantisierung) während der Inferenz auf den Tensor Cores erfolgt über:
$$\hat{W}{\text{float}} = S \cdot (W{\text{quant}} - Z)$$
Quantisierungsformate im Detail
- GGUF (k-quants / llama.cpp):
- Block-Level Quantization: Verwendet nicht-lineare Super-Blöcke (z. B. Blöcke von 256 Werten, unterteilt in 16-Wert-Sub-Blöcke) mit individuellen 8-Bit- und 6-Bit-Scales.
- Varianten:
Q8_0: Reines 8-Bit, nahezu identisch zu FP16.Q5_K_M: 5-Bit Quantisierung mit mittlerem Perplexity-Delta ($\Delta \text{PPL} < 0{,}05$).Q4_K_M: 4-Bit Standard-Quantisierung; kritische Matrizen ($W_Q, W_{\text{gate}}$) werden mit höherer Präzision gehalten.IQ3_M/IQ2_XXS: Importance-Matrix-basierte Quantisierung für extreme VRAM-Reduktion unter Nutzung von Kalibrierungsdaten.
- AWQ (Activation-aware Weight Quantization):
- Erkennt, dass 1% der Gewichte für 99% der Repräsentationskraft verantwortlich sind (anhand der Größe der Aktivierungsmatrizen während eines Kalibrierungsdurchlaufs). Diese Ausreißer (Salient Weights) werden unquantisiert oder mit höherer Präzision geschützt.
- EXL2 (ExLlamaV2):
- Unterstützt fraktionale Bitraten (z. B. 3.5 bpw, 4.25 bpw, 6.0 bpw). Unterschiedliche Layer und Matrizen innerhalb desselben Modells erhalten variable Bit-Tiefen basierend auf ihrem Fehlereinfluss.
- GPTQ (Generalized Post-Training Quantization):
- Basiert auf der Inversen der Hesse-Matrix (Second-Order Information / Optimal Brain Surgeon), um Quantisierungsfehler layerweise zu kompensieren.
Perplexity (PPL) Verlustmessung
Die Perplexity misst die Güte der Wahrscheinlichkeitsverteilung über einen Test-Datensatz (z. B. Wikitext-2 oder C4). Ein niedrigerer Wert bedeutet bessere Sprachmodellierung:
$$\text{PPL}(X) = \exp\left( -\frac{1}{N} \sum_{i=1}^{N} \ln P(x_i \mid x_1, \dots, x_{i-1}) \right)$$
| Format | Bits pro Gewicht (bpw) | Modellgröße (Llama 3.3 70B) | PPL (Wikitext-2) | $\Delta$ PPL vs. FP16 |
|---|---|---|---|---|
| FP16 / BF16 | 16.00 | 141.1 GB | 2.85 | 0.00 (Baseline) |
| Q8_0 | 8.50 | 75.2 GB | 2.86 | +0.01 |
| Q5_K_M | 5.50 | 48.6 GB | 2.89 | +0.04 |
| Q4_K_M | 4.50 | 43.2 GB | 2.97 | +0.12 |
| IQ3_M | 3.30 | 31.4 GB | 3.25 | +0.40 |
| IQ2_XXS | 2.20 | 21.8 GB | 4.82 | +1.97 |
Praxiskonsequenz: Quantisierungen wie Q5_K_M und Q4_K_M reduzieren den VRAM-Bedarf um 65–70%, während der kognitive Qualitätsverlust ($\Delta \text{PPL} \le 0{,}12$) im praktischen Einsatz unbemerkbar bleibt. Unterhalb von 3 bpw steigt die Fehlerquote exponentiell an.
3.3 Das Kontextfenster & der KV-Cache
Während der autoregressiven Generierung sagt das LLM jedes neue Token $t_{i}$ basierend auf allen vorherigen Token $t_1, \dots, t_{i-1}$ voraus.
+-------------------------------------------------------------------------------+
|                       KV-CACHE GENERIERUNGS-ZYKLUS                            |
+-------------------------------------------------------------------------------+

Token i-1 ---> [Q, K, V Projektion]
                     |
                     +---> Query q_i (Nur für aktuelles Token berechnet)
                     |
                     +---> Key k_i   ----+
                     |                   |---> An KV-Cache im VRAM anhängen
                     +---> Value v_i ----+
                                           |
                                           v
[ Historische Keys: k_1 ... k_{i-1} ] + [ k_i ] ===> K_Matrix
[ Historische Vals: v_1 ... v_{i-1} ] + [ v_i ] ===> V_Matrix
                                           |
                                           v
   Attention Score = Softmax( (q_i * K_Matrix^T) / sqrt(d_k) ) * V_Matrix
Ohne Caching müssten für jedes neue Ausgabetoken die Key- und Value-Vektoren aller vorangegangenen Token neu berechnet werden (Rechenaufwand $O(N^2)$). Der KV-Cache speichert die Tensoren im VRAM, sodass pro Schritt nur noch $O(N)$ Aufwand anfällt.
Mathematische Formel für den KV-Cache-VRAM-Bedarf
Der Speicherbedarf des KV-Caches wächst linear mit der Kontextlänge, der Batchgröße und der Anzahl der KV-Heads:
$$\text{VRAM}{\text{KV}} = 2 \times n{\text{layers}} \times n_{\text{kv_heads}} \times d_{\text{head}} \times \text{context_len} \times \text{batch_size} \times \text{bytes_per_element}$$
- Faktor $2$: Jeweils ein Tensor für Keys ($K$) und Values ($V$).
- $\text{bytes_per_element}$: $2$ für FP16/BF16, $1$ für FP8/INT8-KV-Cache, $0.5$ für INT4-KV-Cache.
Beispielrechnung: Llama 3.3 70B
- $n_{\text{layers}} = 80$
- $n_{\text{kv_heads}} = 8$ (Grouped-Query Attention)
- $d_{\text{head}} = 128$
- $\text{context_len} = 131.072$ (128k Tokens)
- $\text{batch_size} = 1$
- $\text{bytes_per_element} = 2$ (FP16)
$$\text{VRAM}_{\text{KV}} = 2 \times 80 \times 8 \times 128 \times 131.072 \times 1 \times 2 = 42.949.672.960\text{ Bytes} = \mathbf{40{,}00\text{ GiB}}$$
Ein einzelner 128k-Kontext benötigt bei Llama 3.3 in FP16 allein 40 GB VRAM nur für den KV-Cache – zusätzlich zu den 43 GB Modellgewichten!
+-------------------------------------------------------------------------------+
|                       ATTENTION-ARCHITEKTUREN IM VERGLEICH                    |
+-------------------------------------------------------------------------------+

1. Multi-Head Attention (MHA):
   Query Heads (32):   [Q1] [Q2] [Q3] [Q4] ... [Q32]
   Key/Val Heads (32): [K1] [K2] [K3] [K4] ... [K32]  (1:1 Zuordnung, 100% KV-Cache)

2. Grouped-Query Attention (GQA):
   Query Heads (32):   [Q1 Q2 Q3 Q4] [Q5 Q6 Q7 Q8] ... [Q29 Q30 Q31 Q32]
   Key/Val Heads (8):      [KV1]         [KV2]     ...     [KV8]
   --> KV-Cache um Faktor 4 bis 8 reduziert bei identischer Repräsentationskraft!

3. Multi-Head Latent Attention (MLA - DeepSeek):
   Query Heads:        Projeziert aus komprimiertem Latent Vector c_Q
   Key/Val Heads:      Projeziert aus komprimiertem Latent Vector c_KV
   --> KV-Cache VRAM-Footprint um ~85% reduziert!
3.4 Tokens, Throughput und Latenzberechnung
LLMs verarbeiten keine Zeichen oder Wörter, sondern Token-IDs aus einem diskreten Vokabular.
Tokenizer-Typen
- Byte-Pair Encoding (BPE): Iteratives Verschmelzen der häufigsten Byte-Paare (z. B. GPT-4, Llama 3, Tiktoken).
- SentencePiece / Unigram: Probabilistisches Subword-Splitting (z. B. T5, Gemma).
- ** Faustformel Token-Kompression:**
- Englisch: $1.000\text{ Wörter} \approx 1.300\text{ Tokens}$ (1 Wort $\approx$ 1,3 Tokens).
- Deutsch: $1.000\text{ Wörter} \approx 1.500 - 1.800\text{ Tokens}$ (durch Komposita und Umlaute bei ineffizienten Tokenizern; moderne Tokenizer wie Llama 3 / Tekken erreichen ~1,35 Tokens/Wort).
- Quellcode: $1.000\text{ Zeilen Code} \approx 6.000 - 10.000\text{ Tokens}$.
Token-Generierungsrate (t/s) vs. Lesegeschwindigkeit
Durchsatz (t/s)
   ^
   |                                                   [Realtime Agentic Loop / IDE Refactor]
80 |                                                   (> 60 t/s zwingend für Multi-Agent)
   |
50 |                                [Flüssige interaktive UI]
   |                                (30 - 50 t/s: Optimales Nutzererlebnis)
   |
20 |             [Menschliches Schnell-Lesen]
   |             (12 - 18 t/s)
 8 |  [Menschliches Standard-Lesen: 4-6 Wörter/s = 6-8 t/s]
   +------------------------------------------------------------------------>
Die Speicherbandbreiten-Grenze (Memory Bandwidth Bound)
In der autoregressiven Generierungsphase (Decode-Phase) muss für jedes einzelne erzeugte Token die gesamte Gewichtsmatrix des Modells einmal vollständig aus dem VRAM in die Rechenkerne geladen werden.
Die theoretisch maximale Generierungsgeschwindigkeit $T_{\text{max}}$ (in Token/s bei Batch Size 1) ist strikt durch die Speicherbandbreite $\text{BW}$ (in GB/s) und die Modellgröße $M$ (in GB) limitiert:
$$T_{\text{max}} = \frac{\text{Speicherbandbreite [GB/s]}}{\text{Modellgröße im VRAM [GB]}}$$
Praxisbeispiel: Llama 3.3 70B Q4_K_M (43,2 GB)
- NVIDIA GeForce RTX 4090 (GDDR6X @ 1.008 GB/s Bandbreite):
(Hinweis: Modell benötigt 2 Karten zur Speicherung)
Bandbreite über PCIe 4.0 x16 / Dual-GPU gemittelt: $\approx 1.008\text{ GB/s}$
$$T_{\text{max}} = \frac{1008\text{ GB/s}}{43{,}2\text{ GB}} \approx \mathbf{23{,}3\text{ Token/s}}$$ - NVIDIA H100 SXM5 (HBM3 @ 3.350 GB/s Bandbreite):
$$T_{\text{max}} = \frac{3350\text{ GB/s}}{43{,}2\text{ GB}} \approx \mathbf{77{,}5\text{ Token/s}}$$ - Dual Intel Xeon / AMD EPYC DDR5-4800 (Oktakanal @ ~300 GB/s CPU RAM):
$$T_{\text{max}} = \frac{300\text{ GB/s}}{43{,}2\text{ GB}} \approx \mathbf{6{,}9\text{ Token/s}}$$
Fazit: Mehr Compute (TFLOPS) beschleunigt nur den Prefill (Prompt-Verarbeitung). Die Generierungsgeschwindigkeit (Decode) skaliert nahezu linear mit der Speicherbandbreite der Hardware.
3.5 Dense vs. Sparse Mixture-of-Experts (MoE)
+-------------------------------------------------------------------------------+
|                       DENSE VS. MOE ARCHITEKTUR                               |
+-------------------------------------------------------------------------------+

[Dense Transformer Layer]
Input Tensor x ---> [LayerNorm] ---> [All Attention Heads] ---> [Single Large FFN (100% Params)] ---> Output

[Sparse MoE Layer (z. B. DeepSeek-V3 / Mixtral)]
                                     +---> [Experte 1 (FFN 1)]
                                     |
Input Tensor x ---> [Router / Gating]+---> [Experte 2 (FFN 2)] (Top-k Routing: Nur k von N
                                     |         ...             Experten werden pro Token
                                     +---> [Experte N (FFN N)] berechnet!)
Der fundamentale Trade-Off
| Eigenschaft | Dense Modell (z. B. Llama 3.3 70B) | Sparse MoE Modell (z. B. DeepSeek-V3) |
|---|---|---|
| Parameter Total | 70.6 Milliarden | 671 Milliarden |
| Parameter Aktiv pro Token | 70.6 Milliarden (100%) | 37 Milliarden (5.5%) |
| Rechenaufwand (FLOPs / Token) | Hoch (~141 GFLOPs / Token) | Niedrig (~74 GFLOPs / Token) |
| VRAM-Bedarf (Gewichte) | Gering (~43 GB in Q4) | Extrem Hoch (~380 GB in Q4) |
| Generierungsdurchsatz | Begrenzt durch 70B Footprint | Äquivalent zu einem 37B Modell! |
Mathematische Begründung des MoE-Vorteils
Ein MoE-Layer ersetzt das standardmäßige FFN durch $N$ parallele FFN-Experten $E_1, \dots, E_N$ und ein parametrisiertes Routing-Netzwerk $G(x)$:
$$y = \sum_{i \in \text{Top-k}} G(x)_i \cdot E_i(x)$$
- Inferenz-Geschwindigkeit: Da pro Token nur $k$ Experten geladen und berechnet werden müssen ($k=8$ bei DeepSeek-V3, $k=2$ bei Mixtral 8x7B), entspricht der Rechenaufwand dem eines viel kleineren Modells.
- VRAM-Herausforderung: Um diese Geschwindigkeit zu erreichen, müssen dennoch alle $N$ Experten vollständig im schnellen VRAM gehalten werden. Liegen Teile des Modells im langsamen System-RAM, bricht die Inferenzrate über den PCIe-Bus drastisch ein.
MoE-Modelle maximieren somit die kognitive Modellkapazität pro berechnetem FLOP auf Kosten eines massiv erhöhten VRAM-Footprints.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.