Der Bandbreiten-Flaschenhals
Warum Speicherzugriff die Decode-Rate bestimmt.
Warum Speicherzugriff die Decode-Rate bestimmt. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
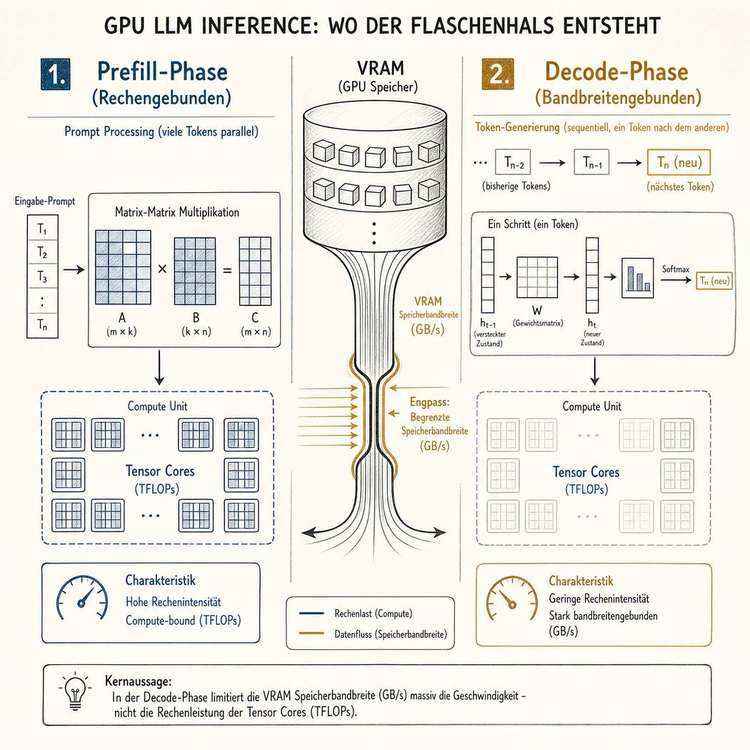
Kapitel 4: Der Flaschenhals Bandbreite – Memory-Bound vs. Compute-Bound
Die Ausführung lokaler Large Language Models unterliegt physikalischen Gesetzmäßigkeiten, die sich fundamental von klassischer Softwareentwicklung und traditionellen HPC-Workloads (High Performance Computing) unterscheiden. Während Standard-Benchmarks primär die reine Rechenleistung in TFLOPs (Tera-Floating-Point-Operations per Second) hervorheben, offenbart die autoregressive Inferenz eine harte Asymmetrie: Beim Erzeugen einzelner Sequenzen langweilt sich die Recheneinheit der GPU, während das Speicher-Subsystem unter Volllast operiert. Um Hardwarekonfigurationen korrekt zu dimensionieren, ist das mathematische Verständnis der Interaktion zwischen Rechenintensität, Speicherbandbreite und Transferlatenzen unerlässlich.
4.1 Die Physik der Inferenz: Memory-Bound vs. Compute-Bound
Die Inferenz eines Transformer-Modells gliedert sich in zwei streng getrennte Betriebsmodi mit diametral entgegengesetzten Hardware-Anforderungen:
- Prefill-Phase (Prompt Processing / Time-to-First-Token, TTFT)
- Decode-Phase (Token Generation / Inter-Token Latency, ITL)
+-----------------------------------------------------------------------------+
|                           INFERENZ-PHASEN                                   |
+-----------------------------------------------------------------------------+
|                                                                             |
|  1. PREFILL-PHASE (Prompt Processing)                                       |
|     Input: N Prompt-Tokens parallel -> Matrix-Matrix-Multiplikation (GEMM)  |
|     +--------------------------------------------------------------------+  |
|     |  [Token 1, Token 2, ..., Token N]  x  [Gewichtsmatrix W (Layer L)]  |  |
|     +--------------------------------------------------------------------+  |
|     Charakteristik: COMPUTE-BOUND (Hohe Arithmetic Intensity)               |
|     Limitierender Faktor: Tensor Core TFLOPs (FP16 / FP8 / INT4)            |
|                                                                             |
|  2. DECODE-PHASE (Autoregressive Generierung)                               |
|     Input: 1 Token sequentiell -> Matrix-Vektor-Multiplikation (GEMV)       |
|     +--------------------------------------------------------------------+  |
|     |  [Aktuelles Token t]               x  [Gewichtsmatrix W (Layer L)]  |  |
|     +--------------------------------------------------------------------+  |
|     Charakteristik: MEMORY-BOUND (Minimale Arithmetic Intensity)            |
|     Limitierender Faktor: VRAM-Speicherbandbreite (GB/s oder TB/s)          |
|                                                                             |
+-----------------------------------------------------------------------------+
Arithmetic Intensity und das Roofline-Modell
Die Arithmetic Intensity ($I$) beschreibt das Verhältnis von ausgeführten Rechenoperationen (FLOPs) zu den transferierten Speicherbytes (Bytes):
$$I = \frac{\text{FLOPs}}{\text{Bytes transferiert}} \quad \left[\frac{\text{FLOP}}{\text{Byte}}\right]$$
Das Roofline-Modell definiert die maximale Leistung $P$ (in FLOP/s) eines Prozessors in Abhängigkeit von der Arithmetic Intensity $I$, der Spitzenrechenleistung $P_{\text{peak}}$ (FLOP/s) und der Spitzen-Speicherbandbreite $B_{\text{peak}}$ (Bytes/s):
$$P = \min\left(P_{\text{peak}},, I \times B_{\text{peak}}\right)$$
Der Schnittpunkt zwischen dem speicherbandbreitenlimitierten und dem rechenleistungsberechneten Bereich markiert die kritische Rechenintensität $I_{\text{crit}}$:
$$I_{\text{crit}} = \frac{P_{\text{peak}}}{B_{\text{peak}}}$$
Liegt die Arithmetic Intensity eines Algorithmus unterhalb von $I_{\text{crit}}$, ist das System speicherbandbreitengebunden (memory-bound).
Beispielrechnung: NVIDIA GeForce RTX 4090
- FP16 Tensor Core Leistung ($P_{\text{peak}}$): $330 \times 10^{12} \text{ FLOP/s}$ (330 TFLOPs, Dense)
- GDDR6X Speicherbandbreite ($B_{\text{peak}}$): $1008 \times 10^9 \text{ Bytes/s}$ (1.008 TB/s)
$$I_{\text{crit}} = \frac{330 \times 10^{12} \text{ FLOP/s}}{1008 \times 10^9 \text{ Byte/s}} \approx 327{,}38 \text{ FLOP/Byte}$$
-
Prefill-Phase: Für einen Prompt von $N = 2048$ Tokens operiert die Inferenz als Matrix-Matrix-Multiplikation (GEMM). Pro Parameter werden $2 \times 2048 = 4096 \text{ FLOPs}$ ausgeführt. Bei 16-Bit-Präzision (2 Bytes/Parameter) beträgt die Arithmetic Intensity:
$$I_{\text{Prefill}} = \frac{4096 \text{ FLOPs}}{2 \text{ Bytes}} = 2048 \text{ FLOP/Byte} \gg I_{\text{crit}}$$
Die GPU arbeitet voll im Compute-Bound-Bereich. Die Tensor Cores sind maximal ausgelastet. -
Decode-Phase (Batch Size = 1): Zur Generierung eines einzelnen Folgetokens muss jeder Parameter des Modells exakt einmal aus dem VRAM in die Register der Streaming-Multiprozessoren (SMs) geladen werden. Für eine Matrix-Vektor-Multiplikation (GEMV) fallen pro Parameter 2 Rechenoperationen (1 Multiplikation + 1 Addition = 1 FMA = 2 FLOPs) an:
$$I_{\text{Decode}} = \frac{2 \text{ FLOPs}}{2 \text{ Bytes (FP16)}} = 1{,}0 \text{ FLOP/Byte}$$
Selbst bei INT4-Quantisierung (0.5 Bytes/Parameter):
$$I_{\text{Decode, INT4}} = \frac{2 \text{ FLOPs}}{0{,}5 \text{ Bytes}} = 4{,}0 \text{ FLOP/Byte} \ll I_{\text{crit}}$$
Leistung P [TFLOPs]
 ^
 |                                      Peak Compute (330 TFLOPs)
 |                             +----------------------------------------
 |                            /
 |                           /
 |                          /
 |                         /   <-- Roofline
 |                        /
 |                       /
 |                      /
 |   Memory-Bound      /     Compute-Bound
 |   Bereich          /      Bereich
 |                   /
 |  * (Decode: 1-4 FLOP/Byte)           * (Prefill: 2048 FLOP/Byte)
 +--------------------+------------------------------------------------->
 0                   I_crit (327.4)                   Intensity I [FLOP/Byte]
[Deep Dive] Warum die GPU während der Dekodierung zu 95-99% untätig ist
Bei Batch Size = 1 und FP16-Ausführung benötigt die RTX 4090 mit 1008 GB/s Bandbreite für 1 Byte Transfer 0,992 Picosekunden.
Die SMs könnten in dieser Zeit jedoch 327 FLOPs berechnen. Tatsächlich führen sie aber nur 1 FLOP aus.
Die Auslastung der ALUs/Tensor-Cores beträgt damit rechnerisch:
Auslastung = 1 / 327,38 = 0,305% (über 99,6% der theoretischen Rechenleistung liegen brach).
Der gesamte Chip wartet permanent auf Daten aus dem Speicher-Controller.
4.2 Die fundamentale Durchsatzformel für LLMs
Unter Vernachlässigung des Overheads für den KV-Cache (bei kurzen Kontexten) und der Latenz von Kernel-Launches wird die maximale Generierungsgeschwindigkeit eines LLMs bei Single-Stream-Inferenz (Batch Size = 1) exklusiv durch den Quotienten aus Speicherbandbreite und Modellgröße bestimmt:
$$\text{Durchsatz}{\text{max}} \left[\frac{\text{Tokens}}{\text{s}}\right] = \frac{\text{Effektive Speicherbandbreite } B{\text{eff}} \left[\frac{\text{GB}}{\text{s}}\right]}{\text{Speicherbedarf des Modells } M_{\text{model}} [\text{GB}]}$$
Wobei $M_{\text{model}}$ definiert ist als:
$$M_{\text{model}} [\text{GB}] = \frac{\text{Parameteranzahl } P \times \text{Bits pro Parameter } b}{8 \times 10^9}$$
Mathematische Beispielberechnungen
Szenario 1: Llama 3.3 70B auf RTX 4090 vs. RTX 5090 vs. Apple M4 Max
- Modell: 70,6 Milliarden Parameter, quantisiert auf Q4_K_M (~4,5 Bits pro Parameter)
- Reines Modellgewicht im VRAM: $M_{\text{model}} \approx 39{,}6 \text{ GB}$
- NVIDIA RTX 4090 (GDDR6X, 1008 GB/s theoretisch, ~880 GB/s $B_{\text{eff}}$):
- Modell passt nicht in 24 GB VRAM!
- Bei 2x RTX 4090 ($B_{\text{eff}} \approx 880 \text{ GB/s}$ via Tensor Parallelism):
$$\text{Durchsatz} = \frac{880 \text{ GB/s}}{39{,}6 \text{ GB}} \approx 22{,}2 \text{ Tokens/s}$$
- NVIDIA RTX 5090 (GDDR7, 1792 GB/s theoretisch, ~1520 GB/s $B_{\text{eff}}$):
- Modellgröße 39,6 GB passt nicht in eine einzelne 32 GB RTX 5090.
- Bei 2x RTX 5090 ($B_{\text{eff}} \approx 1520 \text{ GB/s}$):
$$\text{Durchsatz} = \frac{1520 \text{ GB/s}}{39{,}6 \text{ GB}} \approx 38{,}4 \text{ Tokens/s}$$
- Apple M4 Max (128 GB Unified Memory, 546 GB/s theoretisch, ~430 GB/s $B_{\text{eff}}$):
- Modell passt vollständig in den Unified Memory (39,6 GB von 128 GB).
$$\text{Durchsatz} = \frac{430 \text{ GB/s}}{39{,}6 \text{ GB}} \approx 10{,}8 \text{ Tokens/s}$$
- Modell passt vollständig in den Unified Memory (39,6 GB von 128 GB).
[Praxis-Tipp] Die "Faustformel" zur Hardware-Abschätzung
Für Batch=1 Inferenz gilt: Verdoppelt sich die Speicherbandbreite bei identischem Modell, verdoppelt sich die Token-Generierungsrate exakt linear.
Halbiert sich die Bitbreite durch Quantisierung (z. B. von FP16 auf Q8 oder Q4), halbiert sich die pro Token zu lesende Datenmenge, was die Token/s verdoppelt.
4.3 Die Speicher-Hierarchie: System-RAM bis HBM3
Um die extremen Geschwindigkeitsunterschiede zwischen lokaler CPU-Inferenz, Desktop-GPUs und Rechenzentrums-Beschleunigern zu verstehen, müssen die physikalischen Speichertechnologien gegenübergestellt werden.
+-----------------------------------------------------------------------------+
|                     SPEICHERBANDBREITEN IM VERGLEICH                        |
+-----------------------------------------------------------------------------+
| HBM3 (H100 SXM5)       | [########################################] 3350 GB/s|
| HBM2e (A100 80GB PCIe) | [########################] 2039 GB/s               |
| GDDR7 (RTX 5090)       | [#####################] 1792 GB/s                  |
| GDDR6X (RTX 4090)      | [############] 1008 GB/s                           |
| Apple M2/M3 Ultra UMA  | [##########] 800 GB/s                              |
| Apple M4 Max UMA       | [######] 546 GB/s                                  |
| GDDR6 (RTX 3060 12GB)  | [####] 360 GB/s                                    |
| Octa-Channel DDR5-5600 | [##] 358.4 GB/s                                    |
| Dual-Channel DDR5-5600 | [] 89.6 GB/s (Real: ~65 GB/s)                      |
| Dual-Channel DDR4-3200 | [] 51.2 GB/s (Real: ~38 GB/s)                      |
+-----------------------------------------------------------------------------+
Detaillierte Spezifikationsübersicht
| Speichertechnologie | Typische Plattform / Hardware | Busbreite (Bit) | Takt / Datenrate | Theoretische Bandbreite | Reale effektive Bandbreite | Typische Latenz |
|---|---|---|---|---|---|---|
| DDR4 (Dual Channel) | Intel 10th-11th Gen, AMD AM4 (DDR4-3200) | $2 \times 64 = 128$ | 3200 MT/s | 51,2 GB/s | 38 - 42 GB/s | 60 - 80 ns |
| DDR5 (Dual Channel) | Intel 13th-14th/Core Ultra, AMD AM5 (DDR5-5600) | $4 \times 32 = 128$ | 5600 MT/s | 89,6 GB/s | 65 - 72 GB/s | 70 - 90 ns |
| DDR5 (Quad Channel) | Intel Xeon W-2400, AMD Threadripper 7000 Non-Pro | $8 \times 32 = 256$ | 5600 MT/s | 179,2 GB/s | 135 - 148 GB/s | 75 - 95 ns |
| DDR5 (Octa Channel) | AMD EPYC 9004/Genoa, Threadripper Pro 7000WX | $16 \times 32 = 512$ | 5600 MT/s | 358,4 GB/s | 280 - 305 GB/s | 80 - 105 ns |
| GDDR6 (192-Bit) | NVIDIA GeForce RTX 3060 12GB | 192 | 15 Gbps | 360,0 GB/s | 290 - 315 GB/s | 30 - 50 ns |
| GDDR6 (256-Bit) | NVIDIA GeForce RTX 4060 Ti 16GB / AMD RX 7900 GRE | 256 | 18 Gbps | 576,0 GB/s | 460 - 500 GB/s | 30 - 50 ns |
| GDDR6X (384-Bit) | NVIDIA GeForce RTX 3090 / RTX 4090 24GB | 384 | 21 Gbps | 1008,0 GB/s | 860 - 910 GB/s | 25 - 40 ns |
| GDDR7 (512-Bit) | NVIDIA GeForce RTX 5090 32GB | 512 | 28 Gbps | 1792,0 GB/s | 1480 - 1580 GB/s | 20 - 35 ns |
| Apple UMA (M4 Pro) | Apple M4 Pro (Mac mini / MacBook Pro) | 256 | LPDDR5X-8533 | 273,0 GB/s | 220 - 240 GB/s | 40 - 60 ns |
| Apple UMA (M4 Max) | Apple M4 Max (MacBook Pro / Mac Studio) | 512 | LPDDR5X-8533 | 546,0 GB/s | 430 - 465 GB/s | 40 - 60 ns |
| Apple UMA (M2 Ultra) | Apple M2 Ultra (Mac Studio / Mac Pro) | 1024 | LPDDR5-6400 | 800,0 GB/s | 640 - 680 GB/s | 45 - 65 ns |
| HBM2e (4096-Bit) | NVIDIA A100 80GB PCIe | 4096 | 3,2 Gbps | 1935 - 2039 GB/s | 1650 - 1750 GB/s | 15 - 25 ns |
| HBM3 (5120-Bit) | NVIDIA H100 80GB SXM5 | 5120 | 5,2 Gbps | 3350,0 GB/s | 2800 - 2950 GB/s | 10 - 20 ns |
Die Auswirkung auf die Token-Generierung
Wird ein 8B-Modell (z. B. Llama 3.1 8B in Q8_0, Speicherbedarf: $8{,}5 \text{ GB}$) auf verschiedenen Architekturen betrieben, ergeben sich folgende reale Durchsätze:
- Dual-Channel DDR5-5600 (CPU-Inferenz, $B_{\text{eff}} \approx 68 \text{ GB/s}$):
$$\text{Durchsatz} = \frac{68 \text{ GB/s}}{8{,}5 \text{ GB}} \approx 8{,}0 \text{ Tokens/s}$$ - NVIDIA RTX 3060 12GB (GDDR6, $B_{\text{eff}} \approx 300 \text{ GB/s}$):
$$\text{Durchsatz} = \frac{300 \text{ GB/s}}{8{,}5 \text{ GB}} \approx 35{,}3 \text{ Tokens/s}$$ - NVIDIA RTX 4090 24GB (GDDR6X, $B_{\text{eff}} \approx 880 \text{ GB/s}$):
$$\text{Durchsatz} = \frac{880 \text{ GB/s}}{8{,}5 \text{ GB}} \approx 103{,}5 \text{ Tokens/s}$$
Die GPU ist bei identischer Modellarchitektur um den Faktor 13x schneller als der DDR5-Systemspeicher – rein getrieben durch die physikalische Busbreite und Taktrate des GDDR-Speichers.
4.4 Der PCIe-Flaschenhals beim CPU/GPU-Offloading
Wenn ein Modell die Kapazität des GPU-VRAMs überschreitet, bieten Inferenz-Engines wie llama.cpp die Möglichkeit des teilweisen Offloadings (Split-Layer-Offloading). Hierbei werden beispielsweise 20 Transformer-Layer auf der GPU und 12 Layer auf der CPU im System-RAM berechnet.
+-----------------------------------------------------------------------------+
|                      SPLIT-LAYER INFERENZ ÜBER PCIE                         |
+-----------------------------------------------------------------------------+
|                                                                             |
|  [GPU VRAM: Layer 0..19]  -- (GDDR6X @ 1008 GB/s)                           |
|       |                                                                     |
|       v                                                                     |
|  [Hidden State Tensor t] (z.B. Shape [1, 4096], FP16 -> 8 KB)               |
|       |                                                                     |
|       |  PCIe-Bus Transfer (DMA / Host-to-Device Latenz)                    |
|       |  PCIe 4.0 x16: 31.5 GB/s (Unidirektional)                           |
|       v                                                                     |
|  [CPU System-RAM: Layer 20..31] -- (DDR5 @ 65 GB/s)                         |
|       |                                                                     |
|       v                                                                     |
|  [Hidden State Tensor t+1]                                                  |
|       |                                                                     |
|       |  PCIe-Bus Rücktransfer                                              |
|       v                                                                     |
|  [GPU VRAM: Layer 32 / Final Norm & LM Head]                                |
|                                                                             |
+-----------------------------------------------------------------------------+
Das Latenz-Problem des seriellen Offloadings
Entgegen einer weit verbreiteten Fehlannahme ist beim Split-Layer-Offloading nicht die Bandbreite des PCIe-Busses der primäre Flaschenhals, sondern:
- Das langsamste Glied der Kette (DDR4/DDR5 Bandbreite für die CPU-Layer)
- Synchronisations-Barrieren und Kernel-Launch-Latenzen
Bei der autoregressiven Generierung eines Tokens müssen die Layer strikt sequentiell berechnet werden:
$$\text{Zeit pro Token } T_{\text{token}} = \sum_{l \in \text{GPU}} t_{\text{layer, GPU}}(l) + t_{\text{Transfer, GPU}\to\text{CPU}} + \sum_{l \in \text{CPU}} t_{\text{layer, CPU}}(l) + t_{\text{Transfer, CPU}\to\text{GPU}}$$
Da $t_{\text{layer, CPU}} \gg t_{\text{layer, GPU}}$, bricht die Gesamtgeschwindigkeit massiv ein.
Beispiel: Llama 3.3 70B (80 Layers) auf RTX 4090 (24 GB) + DDR5 System-RAM
- Gesamtgröße (Q4_K_M): $\approx 40 \text{ GB}$
- Aufteilung:
- 40 Layer auf RTX 4090 ($20 \text{ GB}$ VRAM belegt, Bandbreite: $880 \text{ GB/s}$)
- 40 Layer auf CPU/System-RAM ($20 \text{ GB}$ RAM belegt, Bandbreite: $65 \text{ GB/s}$)
Berechnung der Zeiten pro Token:
- Zeit für GPU-Layer:
$$t_{\text{GPU}} = \frac{20 \text{ GB}}{880 \text{ GB/s}} = 0{,}0227 \text{ s} \ (22{,}7 \text{ ms})$$ - Zeit für CPU-Layer:
$$t_{\text{CPU}} = \frac{20 \text{ GB}}{65 \text{ GB/s}} = 0{,}3077 \text{ s} \ (307{,}7 \text{ ms})$$ - Zeit für PCIe-Transfer (Hidden State $8 \text{ KB}$ über PCIe 4.0 x16 inkl. Kernel-Sync Overhead): $\approx 0{,}1 \text{ ms}$
$$\text{Gesamtzeit pro Token} = 22{,}7 \text{ ms} + 307{,}7 \text{ ms} + 0{,}2 \text{ ms} = 330{,}6 \text{ ms}$$
$$\text{Realer Durchsatz} = \frac{1}{0{,}3306 \text{ s}} \approx 3{,}02 \text{ Tokens/s}$$
Obwohl 50% der Berechnungen auf einer extrem schnellen RTX 4090 laufen, sinkt der Durchsatz von theoretisch $22 \text{ Tokens/s}$ auf magere $3 \text{ Tokens/s}$. Die GPU verbringt 93% ihrer Zeit mit Warten auf die CPU.
[Warnung] Partielles Offloading lohnt sich nur als Notlösung
Partielles CPU-Offloading (Split Layers) eignet sich ausschließlich für Batch-Jobs oder Hintergrundaufgaben, bei denen Latenz irrelevant ist.
Für interaktive Chat-Anwendungen (erforderlich: >= 15-20 Tokens/s) ist ein partielles Offloading über 20% der Gesamtlayer inakzeptabel.
Entweder muss das Modell in kleinere Quantisierungsstufen gezwungen werden (z.B. Q3_K_M), oder es muss ein kleineres Basismodell (z.B. 32B statt 70B) gewählt werden, das zu 100% in den VRAM passt.
4.5 PCIe-Schnittstellen und Multi-GPU-Transferraten
Wenn mehrere GPUs in einem System kombiniert werden, entscheidet die PCIe-Topologie über die Skalierbarkeit. Man unterscheidet zwei fundamentale Multi-GPU-Paradigmen:
- Pipeline Parallelism (PP): Layer 0-39 auf GPU 0, Layer 40-79 auf GPU 1.
- Transfer: Pro Token wird nur der Hidden State ($[1, d_{\text{model}}]$, z. B. $8 \text{ KB}$) sequentiell von GPU 0 zu GPU 1 übertragen.
- PCIe-Bandbreite: Nahezu irrelevant! Selbst PCIe 3.0 x4 reicht für $8 \text{ KB}$ Transfers problemlos aus.
- Tensor Parallelism (TP): Jeder Layer wird über alle GPUs gesplittet (z. B. vLLM, TensorRT-LLM, SGLang).
- Transfer: Pro Layer müssen $2 \times$
All-Reduce-Operationen über den Bus ausgeführt werden. - PCIe-Bandbreite: Extrem kritisch! Bei 80 Layern fallen pro Token $160 \times \text{All-Reduce}$-Synchronisationen an.
- Transfer: Pro Layer müssen $2 \times$
Bandbreiten-Vergleich der Systembusse
| Bus-Standard | Lanes | Rohdatenrate pro Lane | Bandbreite Unidirektional | Bandbreite Bidirektional | Latenz (P2P Host/Device) |
|---|---|---|---|---|---|
| PCIe 3.0 | x4 | 8 GT/s | 3,94 GB/s | 7,88 GB/s | $\approx 2{,}5 \ \mu\text{s}$ |
| PCIe 3.0 | x16 | 8 GT/s | 15,75 GB/s | 31,50 GB/s | $\approx 2{,}0 \ \mu\text{s}$ |
| PCIe 4.0 | x8 | 16 GT/s | 15,75 GB/s | 31,50 GB/s | $\approx 1{,}6 \ \mu\text{s}$ |
| PCIe 4.0 | x16 | 16 GT/s | 31,51 GB/s | 63,02 GB/s | $\approx 1{,}4 \ \mu\text{s}$ |
| PCIe 5.0 | x8 | 32 GT/s | 31,51 GB/s | 63,02 GB/s | $\approx 1{,}2 \ \mu\text{s}$ |
| PCIe 5.0 | x16 | 32 GT/s | 63,02 GB/s | 126,03 GB/s | $\approx 1{,}0 \ \mu\text{s}$ |
| NVLink 3 (A100) | 12 Links | 50 GB/s/Link | 300,00 GB/s | 600,00 GB/s | $\approx 0{,}25 \ \mu\text{s}$ |
| NVLink 4 (H100) | 18 Links | 50 GB/s/Link | 450,00 GB/s | 900,00 GB/s | $\approx 0{,}15 \ \mu\text{s}$ |
[Architektur-Hinweis] Consumer-Mainboards und PCIe-Bifurcation
Consumer-CPUs (Intel LGA1700 / AMD AM5) bieten typischerweise nur 16 bis 24 PCIe-Lanes direkt an der CPU.
Werden zwei GPUs eingesteckt, schalten die meisten Mainboards auf x8 / x8 (PCIe 4.0 oder 5.0) um.
- Für Pipeline Parallelism (llama.cpp) bedeutet x8/x8 absolut keinen Leistungsverlust (Verlust < 0,5%).
- Für Tensor Parallelism (vLLM) erzeugt PCIe 4.0 x8 einen messbaren Durchsatzabfall von 15-25% im Vergleich zu PCIe 4.0 x16 oder NVLink.
Erst Workstation-Plattformen (AMD Threadripper mit 64-128 Lanes) erlauben 4x echte PCIe 4.0/5.0 x16 Anbindungen.
4.6 Zusammenfassende Hardware-Auslegungsmatrix für Bandbreite
Die folgende Formelsammlung bildet das Fundament für jede Speicherauslegung:
$$\text{Time-to-First-Token (TTFT) } [\text{s}] \approx \frac{2 \times P \times N_{\text{prompt}}}{P_{\text{compute, GPU}} [\text{FLOP/s}]}$$
$$\text{Inter-Token-Latency (ITL) } [\text{s}] \approx \frac{M_{\text{weights}} [\text{Bytes}] + M_{\text{KV-Cache}} [\text{Bytes}]}{B_{\text{memory, eff}} [\text{Bytes/s}]}$$
$$\text{Gesamtdauer } T_{\text{total}} = \text{TTFT} + \left(N_{\text{completion}} \times \text{ITL}\right)$$
Wer lokale LLM-Systeme plant, muss primär den Ziel-Durchsatz für ITL definieren:
- Interaktiver Dialog (Einzelnutzer): Mindestens $20 \text{ Tokens/s}$ $\rightarrow$ Reines GDDR6/GDDR6X/UMA-System erforderlich.
- Agentic Workflows / Code-Generierung: Mindestens $50\text{--}100 \text{ Tokens/s}$ $\rightarrow$ High-End GDDR6X (RTX 4090/5090) oder Multi-GPU mit hoher Bandbreite.
- Batch-Verarbeitung / RAG-Indizierung: Hohe Prefill-TFLOPs und hohe Batch-Kapazitäten $\rightarrow$ Tensor Cores mit FP8/FP4-Support und NVLink/PCIe 5.0.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.