Hardware-Kategorien
Apple UMA, Consumer-GPUs und Enterprise-Hardware.
Apple UMA, Consumer-GPUs und Enterprise-Hardware. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
Kapitel 5: Hardware-Kategorien – NVIDIA, Apple Silicon, Enterprise & Alternativen
Die Auswahl der Hardware für lokale Sprachmodelle entscheidet über Durchsatz, maximale Modellgröße, Energieeffizienz und die Kompatibilität mit bestehenden Software-Stacks. Stand 2026 ist das Marktsegment durch vier distinkte Ökosysteme geprägt: das dominierende NVIDIA-Consumer- und Workstation-Segment mit CUDA-Monopol, Apple Silicon mit seiner Unified Memory Architecture (UMA) im High-RAM-Bereich, klassische Enterprise- und Gebraucht-Server-Hardware sowie aufstrebende alternative Beschleuniger von AMD, Intel und NPU-Herstellern.
5.1 NVIDIA Consumer GPUs: Das CUDA-Ökosystem
NVIDIA-Consumer-Grafikkarten (GeForce-Serie) stellen die am weitesten verbreitete Plattform für lokale Inferenz und Feintuning dar. Der primäre Vorteil liegt in der lückenlosen Softwareunterstützung: Nahezu jedes Open-Source-Framework (vLLM, TensorRT-LLM, SGLang, Ollama, llama.cpp, ExLlamaV2) ist primär für NVIDIA-Architekturen optimiert.
+-----------------------------------------------------------------------------+
|                      NVIDIA TENSOR CORE GENERATIONEN                        |
+-----------------------------------------------------------------------------+
|                                                                             |
|  Ampere (RTX 30xx)        Ada Lovelace (RTX 40xx)    Blackwell (RTX 50xx)   |
|  +---------------------+  +---------------------+    +---------------------+|
|  | FP16 Tensor Cores   |  | FP8 (E4M3 / E5M2)   |    | Native FP4 / INT4   | |
|  | INT8, INT4 Support  |  | Transformer Engine  |    | 2nd Gen Transformer | |
|  | GDDR6 / GDDR6X      |  | GDDR6X (bis 1 TB/s) |    | GDDR7 (bis 1.8 TB/s)| |
|  +---------------------+  +---------------------+    +---------------------+|
|                                                                             |
+-----------------------------------------------------------------------------+
Detaillierte Spezifikationen und Inferenz-Metriken
| GPU-Modell | VRAM & Bus | Speicher-Bandbreite | FP16 Compute (Dense) | FP8 Compute | Leistungsaufnahme (TDP) | Sweet-Spot / Anwendungsbereich |
|---|---|---|---|---|---|---|
| RTX 3060 12GB | 12 GB GDDR6 (192-Bit) | 360 GB/s | 26 TFLOPs | Nicht nativ | 170 W | Budget-Einstieg für 8B Modelle (Q8/Q4) |
| RTX 4060 Ti 16GB | 16 GB GDDR6 (128-Bit) | 288 GB/s | 44 TFLOPs | 88 TFLOPs | 165 W | Günstigste 16GB Karte, aber bandbreitenlimitiert |
| RTX 4070 Ti Super | 16 GB GDDR6X (256-Bit) | 672 GB/s | 88 TFLOPs | 176 TFLOPs | 285 W | 16GB VRAM mit hoher Bandbreite |
| RTX 4080 / Super | 16 GB GDDR6X (256-Bit) | 717 / 736 GB/s | 97 / 104 TFLOPs | 194 / 208 TFLOPs | 320 W | Hohe Prefill-Leistung für 8B-14B |
| RTX 3090 24GB | 24 GB GDDR6X (384-Bit) | 936 GB/s | 71 TFLOPs | Nicht nativ | 350 W | Gebrauchtmarkt-König für 24GB (Multi-GPU Rigs) |
| RTX 4090 24GB | 24 GB GDDR6X (384-Bit) | 1008 GB/s | 330 TFLOPs | 660 TFLOPs | 450 W | Maximale Single-GPU Consumer-Leistung |
| RTX 5090 32GB | 32 GB GDDR7 (512-Bit) | 1792 GB/s | ~340 TFLOPs | ~680 TFLOPs | 600 W | 32GB VRAM: 32B FP8 oder 70B Q3 nativ auf 1 Karte |
Relevanz der Tensor-Core-Generationen
- Ampere (RTX 30xx): Bietet hervorragendes Preis-Leistungs-Verhältnis auf dem Gebrauchtmarkt (insbesondere RTX 3090 24GB). Unterstützt native FP16- und INT8/INT4-Operationen. Limitierung: Keine native Unterstützung für FP8-Formate (E4M3 / E5M2). FP8-quantisierte Modelle (z. B. vLLM FP8) müssen per Software emuliert oder als AWQ/GPTQ (INT4/INT8) geladen werden.
- Ada Lovelace (RTX 40xx): Einführung der FP8 Transformer Engine. Ermöglicht die Ausführung von Modellen in nativer FP8-Präzision mit nahezu doppelter TFLOP-Leistung gegenüber FP16 und halbiertem VRAM-Bedarf ohne merklichen Perplexity-Verlust.
- Blackwell (RTX 50xx): Erste Consumer-Architektur mit nativem Microscaling FP4 / INT4 Support und GDDR7-Speicherinterface (1792 GB/s). Erlaubt extrem hohe Token-Generierungsraten bei 32B- und 70B-Modellen.
[Praxis-Tipp] Der 24GB-VRAM-Schwellenwert
24 GB VRAM markieren die wichtigste Grenze im Consumer-Segment. Erst mit 24 GB VRAM lassen sich:
- Qwen 2.5 32B in Q4_K_M (ca. 20 GB) mit 16k Kontext betreiben
- Llama 3.3 70B in Q2_K (Notlösung) betreiben
- 8B-Modelle in unquantisiertem FP16 mit 128k vollem Kontext betreiben
- LoRA-Feintuning für 8B-Modelle lokal mit Batch-Size > 1 durchführen
Karten mit 16 GB VRAM sind auf 14B-Modelle (Q8/FP16) oder 32B-Modelle in aggressiver Quantisierung (Q3) limitiert.
5.2 Apple Silicon: Unified Memory Architecture (UMA)
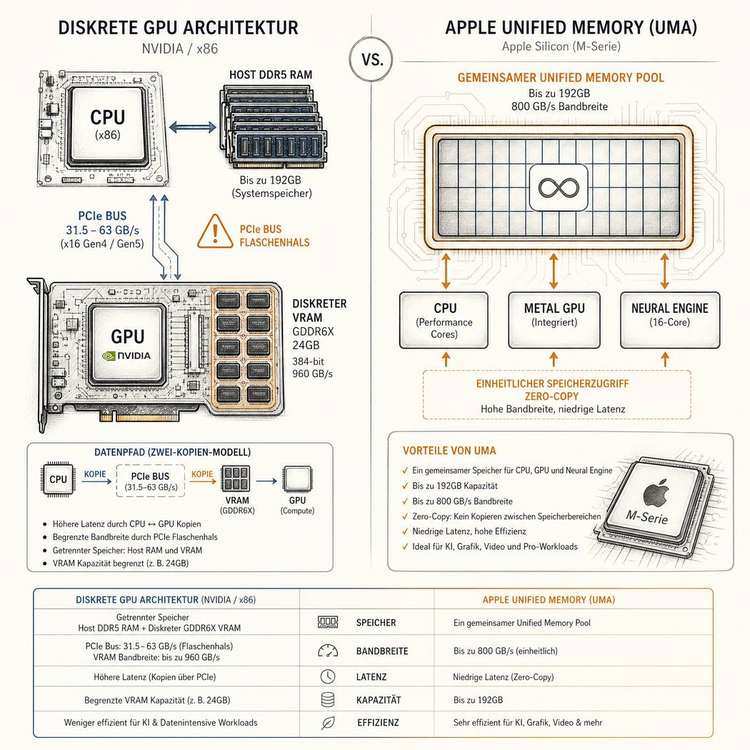
Apples M-Serie verfolgt einen radikal anderen Architekturansatz: CPU, GPU und Neural Engine teilen sich einen gemeinsamen physischen Speicherpool (Unified Memory). Es gibt keinen PCIe-Bus zwischen CPU und GPU-Speicher.
+-----------------------------------------------------------------------------+
|                     APPLE UNIFIED MEMORY ARCHITECTURE (UMA)                 |
+-----------------------------------------------------------------------------+
|                                                                             |
|  +-------------------+  +--------------------+  +----------------------+   |
|  | CPU Cores (P + E) |  | GPU Cores (Metal)  |  | Neural Engine (ANE)  |   |
|  +---------+---------+  +---------+----------+  +----------+-----------+   |
|            |                      |                        |                |
|            +----------------------+------------------------+                |
|                                   |                                         |
|                   +---------------+---------------+                         |
|                   | High-Speed On-Die Interconnect|                         |
|                   +---------------+---------------+                         |
|                                   |                                         |
|             +---------------------+---------------------+                   |
|             | UNIFIED MEMORY (LPDDR5 / LPDDR5X Speichers)|                   |
|             | Bis zu 192 GB (M2 Ultra) / 128 GB (M4 Max)|                   |
|             | Bandbreite: 273 GB/s bis 800 GB/s         |                   |
|             +-------------------------------------------+                   |
|                                                                             |
+-----------------------------------------------------------------------------+
Apple Silicon Varianten im Inferenz-Vergleich
| Prozessor / Plattform | Maximaler RAM | Speicher-Schnittstelle | Bandbreite | Metal GPU Cores | Typischer Durchsatz Llama 3.3 70B (Q4_K_M) | Typischer Durchsatz Qwen 2.5 32B (Q4_K_M) |
|---|---|---|---|---|---|---|
| M4 Pro (Mac mini) | 64 GB | 256-Bit LPDDR5X | 273 GB/s | bis zu 20 | $\approx 5{,}5 \text{ t/s}$ | $\approx 12{,}0 \text{ t/s}$ |
| M3 / M4 Max (MacBook / Studio) | 128 GB | 512-Bit LPDDR5X | 410 / 546 GB/s | bis zu 40 | $\approx 9{,}5 \text{ t/s}$ / $\approx 12{,}5 \text{ t/s}$ | $\approx 21{,}0 \text{ t/s}$ / $\approx 27{,}0 \text{ t/s}$ |
| M2 Ultra (Mac Studio / Pro) | 192 GB | 1024-Bit LPDDR5 | 800 GB/s | bis zu 76 | $\approx 16{,}5 \text{ t/s}$ | $\approx 36{,}0 \text{ t/s}$ |
Speicher-Allokation unter macOS
macOS behandelt Unified Memory gemeinsam für CPU, GPU und Systemdienste. Es gibt daher kein allgemein gültiges, öffentlich dokumentiertes „75-%-GPU-Limit“, das sich mit einem universellen sysctl-Befehl auf 95 % anheben lässt. Die nutzbare Modellgröße hängt von Gerät, Betriebssystem, Framework, Kontext und gleichzeitig laufenden Anwendungen ab. Für reproduzierbare Dimensionierung muss der konkrete MLX- oder llama.cpp-Backend-Build gemessen werden.
Vor- und Nachteile von Apple Silicon für lokale KI
Vorteile:
- Unübertroffenes VRAM-zu-Preis-Verhältnis bei Großmodellen: Ein Mac Studio M2 Ultra mit 192 GB RAM (ca. 4.500–5.500 €) stellt 180 GB nutzbaren GPU-VRAM bereit. Ein vergleichbares NVIDIA-Setup erfordert mindestens $4 \times \text{RTX 3090/4090}$ oder $4 \times \text{RTX 6000 Ada}$ (Kosten: 6.000 € bis 35.000 €).
- Gigantische Modellgrößen lokal: DeepSeek-V3/R1 Quants (Q3/Q4 MoE), Command R+ 104B oder Llama 3.3 70B in unquantisiertem FP16/Q8_0 laufen vollständig im Grafikspeicher.
- Energieeffizienz: Bei Volllast zieht ein Mac Studio M2 Ultra / M4 Max lediglich 100 bis 180 Watt aus der Steckdose (gegenüber 800–1600 Watt bei einem Multi-GPU PC-Rig).
Nachteile:
- Limitiertes Prompt-Processing (TTFT): Metal Performance Shaders (MPS) und
llama.cpp Metalerreichen bei der Prefill-Phase (GEMM) nur einen Bruchteil der TFLOP-Leistung von NVIDIA Tensor Cores. Bei 32k-Prompt-Längen kann das Prefilling auf einem Mac 10–30 Sekunden dauern. - Keine Enterprise-Inferenz-Engines: vLLM, TensorRT-LLM und SGLang unterstützen macOS nicht nativ für High-Throughput-Serving. Apple Silicon ist primär auf
llama.cpp,OllamaundMLXbeschränkt. - Geringe Multi-User/Batch-Skalierung: Wenn mehrere Anfragen parallel eintreffen, bricht die Generierungsgeschwindigkeit pro User massiv ein.
[Architektur-Hinweis] MLX vs. llama.cpp auf Apple Silicon
Das von Apple entwickelte Open-Source-Framework MLX und llama.cpp mit Metal-Backend nutzen Unified Memory. Welche Variante schneller ist, hängt unter anderem von Modellformat, Quantisierung, Kontext, Batchgröße und Version ab; pauschale 15–25-%-Vorteile sind kein belastbarer allgemeiner Wert.
5.3 Workstation & Enterprise GPUs: NVIDIA Ada Lovelace & Hopper
Im professionellen und Enterprise-Umfeld dominieren dedizierte Workstation- und Datacenter-Karten. Diese bieten ECC-Speicher (Error-Correcting Code), standardisierte PCIe-Blower- oder SXM-Kühlkonzepte und unlimitierte Treiber-Features.
+-----------------------------------------------------------------------------+
|                     ENTERPRISE INTERCONNECT: PCIE VS NVLINK                 |
+-----------------------------------------------------------------------------+
|                                                                             |
|  PCIe 4.0/5.0 Topologie:               NVLink 4 Topologie (z.B. HGX H100):  |
|  +--------+     +--------+             +--------+         +--------+        |
|  | GPU 0  |     | GPU 1  |             | GPU 0  | <=====> | GPU 1  |        |
|  +----+---+     +---+----+             +----+---+ NVLink  +---+----+        |
|       |             |                       ||   900 GB/s     ||            |
|  +----+-------------+----+             +----+-----------------+----+        |
|  |  PCIe Root Complex    |             |       NVSwitch Fabric     |        |
|  |  (31.5 - 63 GB/s P2P) |             |     (Bi-Dir: 900 GB/s)    |        |
|  +-----------------------+             +---------------------------+        |
|                                                                             |
+-----------------------------------------------------------------------------+
Spezifikations- und Benchmark-Übersicht
| GPU-Modell | Formfaktor / Bus | VRAM-Kapazität | Speicher-Typ & Bandbreite | TDP | FP8 Tensor TFLOPs | Typischer Einsatzzweck |
|---|---|---|---|---|---|---|
| RTX A4000 | Single-Slot PCIe 4.0 | 16 GB GDDR6 ECC | 448 GB/s | 140 W | Nicht nativ | Kompakte Edge-Server, 8B/14B Modelle |
| RTX A5000 | Dual-Slot PCIe 4.0 | 24 GB GDDR6 ECC | 768 GB/s | 230 W | Nicht nativ | Stabile 24GB Alternative zur RTX 3090 |
| RTX 5000 Ada | Dual-Slot PCIe 4.0 | 32 GB GDDR6 ECC | 576 GB/s | 250 W | 400 TFLOPs | 32B FP8 Modelle auf Workstations |
| RTX 6000 Ada | Dual-Slot PCIe 4.0 | 48 GB GDDR6 ECC | 960 GB/s | 300 W | 730 TFLOPs | 70B Modelle in FP8/Q4 auf einer Karte |
| A100 80GB | Dual-Slot PCIe / SXM4 | 80 GB HBM2e | 1935 / 2039 GB/s | 300 / 400 W | Nicht nativ (INT8: 624) | High-Concurrency vLLM Serving, RAG |
| H100 80GB | Dual-Slot PCIe / SXM5 | 80 GB HBM3 | 2000 / 3350 GB/s | 350 / 700 W | 1979 TFLOPs | Maximale Prefill- & Serving-Performance |
Gebrauchte Datacenter-Beschleuniger auf dem Prüfstand
Aufgrund hoher Neupreise greifen viele Systemintegratoren zu gebrauchten Enterprise-Karten aus vergangenen Generationen:
1. NVIDIA Tesla P40 (24 GB GDDR5, Pascal-Architektur – 2016)
- Vorteil: Extrem günstiger Einstieg in 24 GB VRAM (ca. 150–250 € auf dem Gebrauchtmarkt).
- Nachteile & Restriktionen:
- Katastrophale FP16-Leistung: Pascal besitzt keine FP16-Tensor-Cores. FP16 wird mit $1/64$ der FP32-Rate berechnet.
- Software-Zwang: In
llama.cppmuss die Ausführung zwingend über INT4- oder INT8-Quantisierungen mit nativem INT8-Dot-Product (dp4a) erzwungen werden (-nglauf P40 funktioniert nur performant mit Q4_0 / Q8_0, nicht mit FP16). - Keine vLLM/FlashAttention-2 Unterstützung: Moderne PagedAttention-Kernel erfordern Mindest-Compute-Capability 8.0 (Ampere) oder 7.5 (Turing). Die P40 (Compute Capability 6.1) wird von modernen Serving-Frameworks nicht mehr unterstützt.
2. NVIDIA Tesla V100 (16 GB / 32 GB HBM2, Volta-Architektur – 2017)
- Vorteil: HBM2-Speicherbandbreite von 900 GB/s zu moderaten Gebrauchtpreisen.
- Nachteile: Compute Capability 7.0. Keine native INT4-Hardwareunterstützung, keine native FP8-Unterstützung. FlashAttention-2 wird offiziell nicht unterstützt (nur FlashAttention-1 Patches).
[Warnung] Kühlung von Server-Karten im Desktop-Gehäuse
Karten wie Tesla P40, V100, A100 PCIe besitzen KEINE eigenen Lüfter (passives Blower-Design).
Werden sie in normale Desktop-Gehäuse verbaut, überhitzen die GPUs innerhalb von 60 Sekunden und schalten wegen thermischer Notabschaltung (Thermal Throttling / TJMax) ab.
Der Betrieb erfordert 3D-gedruckte Luftführungs-Adapter (Fan Shrouds) mit hochdrehenden 12V-Serverlüftern (z.B. Delta-Fans mit >5000 RPM und hohem statischem Druck).
5.4 Multi-GPU-Konfigurationen: Dual- und Quad-GPU Rigs
Um Modelle ab 70 Milliarden Parametern mit hohen Quantisierungsstufen (Q8_0 / FP8 / FP16) oder mit 128k Kontextfenster lokal zu betreiben, sind Multi-GPU-Systeme der wirtschaftlichste Pfad.
+-----------------------------------------------------------------------------+
|                 QUAD-GPU INFERENZ-SETUP (4x RTX 3090 / 4090)                |
+-----------------------------------------------------------------------------+
|                                                                             |
|  +---------------+  +---------------+  +---------------+  +---------------+ |
|  | GPU 0 (24 GB) |  | GPU 1 (24 GB) |  | GPU 2 (24 GB) |  | GPU 3 (24 GB) | |
|  | Layers 0..19  |  | Layers 20..39 |  | Layers 40..59 |  | Layers 60..79 | |
|  +-------+-------+  +-------+-------+  +-------+-------+  +-------+-------+ |
|          |                  |                  |                  |         |
|      PCIe x8            PCIe x8            PCIe x8            PCIe x8       |
|          |                  |                  |                  |         |
|  +-------+------------------+------------------+------------------+-------+ |
|  |             AMD Threadripper / EPYC Workstation-Mainboard              | |
|  |                 (128 PCIe 4.0 / 5.0 Lanes, Octa-Channel DDR5)          | |
|  +------------------------------------------------------------------------+ |
|  Gesamt-VRAM: 96 GB | Max. Modellgröße: Llama 3.3 70B FP16 oder DeepSeek MoE |
|                                                                             |
+-----------------------------------------------------------------------------+
Technische Voraussetzungen für Multi-GPU Rigs
- PCIe-Lanes & Bifurcation:
- Desktop-CPUs (Intel Core i9-14900K, AMD Ryzen 9 9950X) stellen nur 16 PCIe-Lanes für Grafikkarten bereit. Bei 2 GPUs laufen diese als $x8 / x8$. Bei 3 oder 4 GPUs müssen die Lanes über den Chipsatz geroutet werden ($x4$ über DMI/PCH), was die Latenzen massiv erhöht.
- Empfohlene Plattform für $\ge 3$ GPUs: AMD Threadripper 7000 (64-128 Lanes) oder AMD EPYC 7002/7003/9004 (128 Lanes).
- Stromversorgung (Netzteile):
- $2 \times \text{RTX 3090/4090}$ erfordern ein Netzteil mit mindestens 1200–1600 Watt (Titanium/Platinum-Zertifizierung wegen Lastspitzen / Transient Spikes).
- $4 \times \text{RTX 3090/4090}$ erfordern 2 getrennte Netzteile (z. B. $2 \times 1200\text{ W}$) oder ein 2500W-Servernetzteil an einer dedizierten 16A-Sicherung (230V $\times$ 16A = 3680 Watt maximal pro Stromkreis).
- NVLink vs. PCIe Peer-to-Peer (P2P):
- Bei der RTX 3090 ist NVLink noch vorhanden ($112{,}5 \text{ GB/s}$ bidirektional). Zwei RTX 3090 mit NVLink-Bridge erreichen in vLLM (Tensor Parallelism = 2) nahezu perfekte Skalierung ohne PCIe-Bus-Belastung.
- Ab der RTX 4090 hat NVIDIA NVLink für Consumer-Karten gestrichen. Die Kommunikation erfolgt zwingend über PCIe P2P.
5.5 Alternative Beschleuniger: AMD ROCm, Intel Arc & NPUs
Obwohl NVIDIA den Markt dominiert, existieren Alternativen mit spezifischen Stärken und Software-Einschränkungen.
AMD ROCm 6.x & Radeon-GPUs
Die AMD Radeon RX 7900 XTX bietet mit 24 GB GDDR6 (960 GB/s Bandbreite) für ca. 950–1.050 € eine attraktive Hardwarebasis.
- Software-Status (Stand 2026):
- ROCm 6.x unter Linux: Exzellente Stabilität in
llama.cpp(via HIP-Backend),OllamaundvLLM(ROCm-Docker-Images). FlashAttention-2 und vLLM PagedAttention laufen nativ auf RDNA3. - ROCm unter Windows: Weiterhin experimentell. Primär wird Windows über DirectML oder Vulkan angesprochen, was ca. 20–35% Performance gegenüber nativem Linux-ROCm einbüßt.
- ROCm 6.x unter Linux: Exzellente Stabilität in
- Instinct Enterprise (MI300X): Mit 192 GB HBM3 ($5{,}3 \text{ TB/s}$ Bandbreite) die derzeit stärkste Single-GPU für Großmodell-Serving im Datacenter.
Intel Arc & IPEX-LLM
Intel Arc Grafikkarten (z. B. Arc A770 16GB) bieten 16 GB VRAM für unter 300 €.
- Software-Status:
- Betrieb über IPEX-LLM (Intel Extension for PyTorch) und
llama.cppmit SYCL/oneAPI Backend. - Gut geeignet für 8B- und 14B-Modelle im Low-Budget-Bereich.
- Einschränkung: Geringe Prefill-Leistung und fehlende Unterstützung in etablierten Serving-Frameworks wie vLLM oder TensorRT-LLM.
- Betrieb über IPEX-LLM (Intel Extension for PyTorch) und
On-Device NPUs (Neural Processing Units)
Mit der Ära der "AI PCs" (Snapdragon X Elite, Intel Lunar Lake, AMD Strix Point) werden dedizierte NPUs in Consumer-Laptops verbaut.
| NPU-Plattform | Angegebene INT8 TOPS | Reale Speicheranbindung | Limitierung für LLMs | Geeigneter Einsatzzweck |
|---|---|---|---|---|
| Qualcomm Snapdragon X Elite | 45 TOPS | LPDDR5X (135 GB/s) | Kleiner Unified Memory, proprietärer Qualcomm AI Stack | On-Device 3B-7B INT4 Inferenz |
| Intel Lunar Lake (Core Ultra 200V) | 48 TOPS | LPDDR5X (137 GB/s) | Fest verlöteter RAM (max 32 GB) | Whisper, Background Denoising, 3B SLMs |
| AMD Ryzen AI 9 (Strix Point) | 50 TOPS | LPDDR5X (135 GB/s) | LPDDR-Bandbreiten-Limitierung | Embeddings, Vision-Preprocessing, 3B SLMs |
[Deep Dive] Warum NPUs dedizierten GPUs bei LLMs unterlegen sind
NPUs werben mit beeindruckenden TOPS-Zahlen (Tera-Operations per Second), die jedoch fast ausschließlich für INT8- oder INT4-Matrizen unter Laborbedingungen gemessen werden.
Für LLMs gilt jedoch das Bandbreiten-Gesetz: Da NPUs denselben LPDDR5X-Bus wie die CPU teilen (135 GB/s), kann selbst eine 50-TOPS-NPU ein 14B-Modell nicht schneller dekodieren als:
Durchsatz = 135 GB/s / 8 GB = max. 16 t/s.
Die eigentliche Stärke von NPUs liegt nicht im maximalen Durchsatz, sondern in der Energieeffizienz (TOPS/Watt) für kontinuierliche Hintergrundaufgaben (z. B. lokale Sprach-Transkription mit Whisper-Small bei < 5 Watt).
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.