Inference Engines
llama.cpp, Ollama, vLLM und PagedAttention.
llama.cpp, Ollama, vLLM und PagedAttention. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
Kapitel 7: Inference Engines – Architektur, Kernel-Optimierung und Serving
Die Wahl der Inferenz-Engine bestimmt fundamental das Latenz- und Durchsatzprofil lokaler Sprachmodelle. Während Frameworks wie PyTorch in Entwicklungs- und Trainingsumgebungen dominieren, erfordern Produktivszenarien hochspezialisierte Laufzeitumgebungen, die Speicherbandbreite, Cache-Hierarchien und Hardwarebeschleuniger optimal ausnutzen.
+--------------------------------------------------------------------------------------------------+
|                                    ANFRAGE (HTTP / REST / gRPC)                                  |
+--------------------------------------------------------------------------------------------------+
                                                 |
                                                 v
+--------------------------------------------------------------------------------------------------+
|                                  INFERENCE SERVING LAYER                                         |
|  - Request Queuing & Scheduling (Continuous Batching / In-Flight Batching)                      |
|  - KV-Cache Memory Management (PagedAttention, Virtual Block Tables)                             |
|  - Distributed Coordination (Tensor Parallelism via NCCL / Custom All-Reduce)                    |
+--------------------------------------------------------------------------------------------------+
                                                 |
                                                 v
+--------------------------------------------------------------------------------------------------+
|                                    EXECUTION & KERNEL LAYER                                      |
|  - Custom Cutlass / Triton / CUDA Kernels (FlashAttention-3, FlashInfer, GEMV/GEMM)             |
|  - Quantization Decoders (GGUF, EXL2, AWQ, GPTQ, FP8/FP4 Hardware Dequantization)               |
|  - Hardware Memory Mapping (`mmap`, Unified Memory, Zero-Copy Host/Device Paging)                |
+--------------------------------------------------------------------------------------------------+
                                                 |
                                                 v
+--------------------------------------------------------------------------------------------------+
|                                    HARDWARE LAYER                                                |
|  - GPUs (NVIDIA Ada/Hopper/Blackwell, AMD CDNA/RDNA) / CPUs (x86 AVX-512/AMX, ARM Neon/SVE)     |
|  - Memory Subsystems: HBM3 (3.35 TB/s), GDDR6X (1008 GB/s), DDR5-6400 Dual-Channel (102.4 GB/s)  |
+--------------------------------------------------------------------------------------------------+
7.1 llama.cpp und Ollama
llama.cpp ist eine in purem C/C++ geschriebene Inferenz-Engine ohne externe Framework-Abhängigkeiten. Ursprünglich für Consumer-Hardware konzipiert, bietet sie eine vollständige Abstraktion über heterogene Recheneinheiten (CPU, CUDA, ROCm, Metal, Vulkan, OpenCL).
7.1.1 GGUF-Spezifikation und binäre Serialisierung
Das GGML Universal File Format (GGUF) ist ein binäres Containerformat, das Metadaten, Tensordefinitionen und quantisierte Gewichte in einer einzigen dateibasierten Struktur kapselt. GGUF löste das veraltete GGML- und GGJT-Format ab, indem es eine typisierte Key-Value-Metadatenstruktur direkt im Header verankert.
+-----------------------------------------------------------------------+
| Header                                                                |
|   - Magic Number (0x46554747 = "GGUF")                                |
|   - Version (uint32_t, aktuell v3)                                    |
|   - Tensor Count (uint64_t)                                           |
|   - Metadata KV Count (uint64_t)                                      |
+-----------------------------------------------------------------------+
| Metadata Key-Value Pairs                                              |
|   - "general.architecture" -> "llama" (string)                        |
|   - "llama.context_length" -> 131072 (uint32_t)                       |
|   - "llama.embedding_length" -> 8192 (uint32_t)                      |
|   - "llama.block_count" -> 80 (uint32_t)                              |
|   - "llama.attention.head_count" -> 64 (uint32_t)                     |
|   - "llama.attention.head_count_kv" -> 8 (uint32_t)                   |
|   - "llama.rope.freq_base" -> 500000.0 (float32)                      |
|   - Tokenizer Metadata (Vocab, Merges, BPE-Tokens, Chat-Templates)   |
+-----------------------------------------------------------------------+
| Tensor Infos                                                          |
|   - Tensor 0: Name, n_dims, shape[4], type (GGML_TYPE_Q4_K), offset  |
|   - Tensor 1: Name, n_dims, shape[4], type (GGML_TYPE_Q6_K), offset  |
|   ...                                                                 |
+-----------------------------------------------------------------------+
| Padding (Alignment to 32 bytes or custom value)                       |
+-----------------------------------------------------------------------+
| Tensor Binary Data                                                    |
|   - Raw Quantized Block Data (0-Copy Memory Mappable)                 |
+-----------------------------------------------------------------------+
Die Tensordaten sind im Dateikörper so ausgerichtet (standardmäßig 32-Byte-Alignment), dass sie direkt per Page-Fault-Mechanismus des Betriebssystems ohne Transformation in den Adressraum eingeblendet werden können.
7.1.2 mmap-Speicherabbildung und Page-Fault-Verhalten
llama.cpp nutzt POSIX mmap() (unter Windows CreateFileMappingW / MapViewOfFile), um GGUF-Dateien in den virtuellen Speicherbereich des Prozesses einzubinden:
int fd = open("models/Llama-3.3-70B-Instruct-Q4_K_M.gguf", O_RDONLY);
struct stat sb;
fstat(fd, &sb);

void *model_addr = mmap(
    NULL,
    sb.st_size,
    PROT_READ,
    MAP_SHARED,
    fd,
    0
);
// System-Advisory für lineares Prefetching beim Modellstart
madvise(model_addr, sb.st_size, MADV_WILLNEED);
Technische Vorteile des mmap-Ansatzes:
- Instant Cold-Start: Der Prozess muss nicht zig Gigabyte an Daten synchron von der NVMe in den Heap kopieren (
malloc+read). Die Initialisierung erfolgt in wenigen Millisekunden, da lediglich die virtuelle Deskriptortabelle allokiert wird. - Zero-Copy Host-to-Device Paging: Bei GPU-Offloading kopieren CUDA-Treiber (
cudaMemcpyoder Unified Memory) die Tensordaten direkt aus dem Page-Cache des Betriebssystems in den VRAM der GPU, ohne Zwischenpufferung im Userspace-RAM. - OS-Level Multi-Process Memory Sharing: Starten mehrere
llama-server-Instanzen dasselbe GGUF-Modell auf demselben Host, teilen sie sich exakt dieselben physischen RAM-Pages im Page-Cache des Linux-Kernels. Der Speicherverbrauch skaliert bei 10 Instanzen nahezu identisch zu einer einzelnen Instanz (abgesehen vom variablen Kontext-KV-Cache).
7.1.3 CPU/GPU-Hybrid-Inferenz und Layer-Offloading
Das Offloading in llama.cpp erfolgt auf Granularität einzelner Transformer-Layer (--n-gpu-layers bzw. -ngl). Das System zerlegt den Rechengraph in Device-spezifische Subgraphen (ggml-cuda, ggml-metal, ggml-cpu via OpenBLAS/AVX-512/AMX).
                      GGUF MODELL (z. B. 80 Transformer Layer)
+--------------------------------------------------------------------------------+
| Layer 0 .. 47 (48 Layer in VRAM)         | Layer 48 .. 79 (32 Layer in System-RAM) |
+------------------------------------------+-------------------------------------+
                     |                                         |
                     v                                         v
       +----------------------------+            +----------------------------+
       |   NVIDIA RTX 4090 (24 GB)  |            |  Host CPU (64 GB DDR5)     |
       |  GDDR6X @ 1008 GB/s        |            |  DDR5-6400 @ 102.4 GB/s    |
       |  CUDA FlashAttention-2     |            |  AVX-512 / AMX GEMM        |
       +----------------------------+            +----------------------------+
                     \                                         /
                      \------- PCIe 4.0 x16 (31.5 GB/s) ------/
                              Hidden State Transfers
Wird ein Modell partiell ausgelagert, entsteht ein Latenz-Bottleneck über den PCIe-Bus. Pro generiertem Token müssen die Aktivierungsvektoren (Hidden States) zwischen GPU-VRAM und Host-RAM transferiert werden:
$$\text{PCIe Transfervolumen pro Token} = 2 \times (\text{Hidden Dimension} \times \text{Batch Size} \times \text{Bytes per Activation})$$
Für ein Llama 3.3 70B Modell ($\text{Hidden Dimension} = 8192$, FP16 Activations = 2 Byte):
$$\text{Transfervolumen} = 2 \times 8192 \times 1 \times 2,\text{Byte} = 32.768,\text{Byte} = 32,\text{KiB pro Token}$$
Der reine Datentransfer des Hidden States via PCIe 4.0 x16 ($31.5,\text{GB/s}$) beansprucht lediglich ca. $1.04,\mu\text{s}$. Der dominierende Flaschenhals bei Hybrid-Inferenz ist nicht der PCIe-Transfer, sondern die Diskrepanz der Speicherbandbreite: Die 32 auf der CPU verbleibenden Layer müssen bei jedem Token mit $102.4,\text{GB/s}$ aus dem DDR5-RAM gelesen werden, während die 48 GPU-Layer mit $1008,\text{GB/s}$ operieren. Die Inferenzgeschwindigkeit bricht dadurch exakt auf das Niveau der CPU-Speicherbandbreite ein.
7.1.4 FlashAttention-Integration in llama.cpp
Standardmäßige Self-Attention erfordert das Materialisieren der quadratischen Attention-Matrix $S = Q K^T \in \mathbb{R}^{N \times N}$ im HBM/VRAM, was bei langen Kontexten ($N > 8192$) zu $O(N^2)$ Speicherverbrauch und Speicherbandbreiten-Sättigung führt.
llama.cpp integriert FlashAttention (v1/v2 und FlashInfer-Bindings via -fa), wodurch die Attention-Berechnung blockweise auf dem SRAM des Streaming Multiprocessors (SM) berechnet wird:
Standard Attention:
  HBM ---> Load Q, K ---> Compute QK^T ---> Write S to HBM (O(N^2) Speicher)
  HBM ---> Load S ---> Softmax(S) = P ---> Write P to HBM
  HBM ---> Load P, V ---> Compute PV = O ---> Write O to HBM

FlashAttention (Tiling im On-Chip SRAM):
  Load Block Q_i, K_j into SRAM (O(N) Speicher)
  Compute Online Softmax & Scale Output accumulative in SRAM
  Write final Output O directly to HBM
Zur Aktivierung in llama-server oder CLI:
# llama-server mit CUDA, FlashAttention und 131k Kontext auf Llama-3.3-70B
./llama-server \
    -m ./models/Llama-3.3-70B-Instruct-Q4_K_M.gguf \
    --host 0.0.0.0 \
    --port 8080 \
    -ngl 80 \
    -fa \
    -c 131072 \
    --n-gpu-layers-draft 0 \
    --threads 16 \
    --parallel 4 \
    --cont-batching
7.1.5 Architektur von Ollama
Ollama abstrahiert llama.cpp zu einer serviceorientierten Client-Server-Architektur mit Go-basiertem Daemon, dynamischem Prozessmanagement und OCI-artigen Modell-Manifesten.
+-----------------------------------------------------------------------+
|                           CLIENT APIS                                 |
|   OpenAI SDK (/v1/chat/completions)   |   Ollama Native API (/api/generate) |
+-----------------------------------------------------------------------+
                                   |
                                   v
+-----------------------------------------------------------------------+
|                        OLLAMA DAEMON (Go Runner)                      |
|  - Engine Lifecycle & GPU Discovery (NVML / ROCm SMI)                 |
|  - Model Registry & Blob Storage (~/.ollama/models/blobs)             |
|  - Dynamic Model Loading / Unloading (OLLAMA_KEEP_ALIVE)               |
|  - Slot & Concurrency Scheduler (OLLAMA_NUM_PARALLEL, OLLAMA_MAX_QUEUE)|
+-----------------------------------------------------------------------+
                                   |
                                   v (IPC via Named Pipes / Local Unix Sockets)
+-----------------------------------------------------------------------+
|                    LLAMACPP SERVER BACKENDS (C++)                     |
|   [llama-runner Instance 1 (GPU 0)]  |  [llama-runner Instance 2 (GPU 1)] |
+-----------------------------------------------------------------------+
Das Modelfile-Format
Ollama kapselt Gewichte, Inferenzparameter, Prompt-Templates und Stop-Tokens in einem deklarativen Modelfile:
# Modelfile für lokales Qwen-2.5-Coder-32B mit Tool-Calling
FROM ./qwen2.5-coder-32b-instruct-q4_k_m.gguf

# Runtime Parameters
PARAMETER temperature 0.2
PARAMETER top_p 0.95
PARAMETER top_k 40
PARAMETER num_ctx 32768
PARAMETER stop "<|im_end|>"
PARAMETER stop "<|endoftext|>"

# System Prompt
SYSTEM """Du bist ein hochpräziser lokaler Programmier-Assistent. Du antwortest stets mit syntaktisch korrektem, typsicherem Code und verzichtest auf redundante Erläuterungen."""

# Jinja2 ChatML Template
TEMPLATE """{{ if .System }}<|im_start|>system
{{ .System }}<|im_end|>
{{ end }}{{ if .Prompt }}<|im_start|>user
{{ .Prompt }}<|im_end|>
{{ end }}<|im_start|>assistant
{{ .Response }}<|im_end|>"""
Kompilierung und Registrierung:
ollama create qwen2.5-coder-local -f Modelfile
OpenAI API-Kompatibilität
Ollama exponiert standardmäßig einen zu OpenAI v1 kompatiblen Endpunkt unter Port 11434 (http://localhost:11434/v1/chat/completions). Das dynamische Modellmanagement reagiert auf Anfragen:
- Ist das Modell nicht geladen, wird es anhand der GPU-Memory-Verfügbarkeit instanziiert.
- Über
OLLAMA_KEEP_ALIVE=5mverbleibt das Modell nach der letzten Inferenz für 5 Minuten im VRAM. - Werden konkurrierende Modelle angefordert, eviziert der Daemon das inaktive Modell zugunsten des neuen.
7.2 vLLM und TGI (Text Generation Inference)
Für Multi-User-Szenarien und hochparallele Batch-Verarbeitung sind llama.cpp und Ollama architekturbedingt limitiert. vLLM (entwickelt an der UC Berkeley) und TGI (Hugging Face) implementieren fortgeschrittenes Server-Scheduling und Speicherverwaltung auf Page-Ebene.
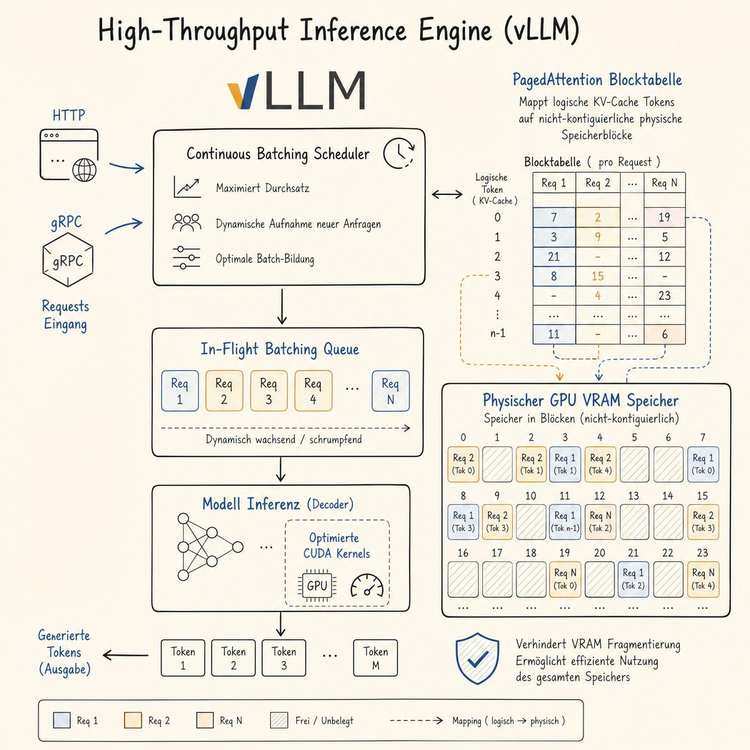
7.2.1 PagedAttention: Beseitigung von Speicherfragmentierung im KV-Cache
In traditionellen Inferenzsystemen reserviert jeder Request einen statischen, zusammenhängenden Tensor für den Key-Value-Cache bis zur maximalen Kontextlänge (z. B. 8192 Tokens).
$$\text{KV-Cache-Größe pro Token} = 2 \times n_{\text{layers}} \times n_{\text{kv_heads}} \times d_{\text{head}} \times \text{Bytes per Float}$$
Für ein Llama 3.3 70B Modell ($n_{\text{layers}}=80$, $n_{\text{kv_heads}}=8$, $d_{\text{head}}=128$, FP16 = 2 Byte):
$$\text{KV pro Token} = 2 \times 80 \times 8 \times 128 \times 2,\text{Byte} = 327.680,\text{Byte} \approx 320,\text{KiB}$$
Bei einem statisch allokierten Kontextfenster von 8192 Tokens belegt ein einziger Request sofort:
$$8192 \times 320,\text{KiB} = 2.621.440,\text{KiB} = 2{,}5,\text{GiB VRAM}$$
Tatsächlich generiert der Nutzer jedoch oft nur 100 Tokens. Die verbleibenden 2,4 GiB VRAM sind blockiert und für andere Requests unbrauchbar (externe Fragmentierung).
PagedAttention löst dieses Problem analog zur virtuellen Speicherverwaltung und Paging moderner Betriebssysteme:
Virtueller Token-Raum (Request):
[ Token 0 | Token 1 | ... | Token 15 ] [ Token 16 | Token 17 | ... | Token 31 ] [ Token 32 ... ]
         Logical Block 0                         Logical Block 1             Logical Block 2
                |                                       |                           |
                +--------------------+                  |                           |
                                     |                  |                           |
Block Table (Request 1):             v                  v                           v
  Logical Block 0 ----------> Physical Block 7   [KV Cache Data: 16 Tokens x 320 KiB]
  Logical Block 1 ----------> Physical Block 2   [KV Cache Data: 16 Tokens x 320 KiB]
  Logical Block 2 ----------> Physical Block 19  [KV Cache Data: 16 Tokens x 320 KiB]

Physischer VRAM-Pool (Nicht-kontinuierliche Block-Allokation):
+--------------------+--------------------+--------------------+--------------------+
| Physical Block 0   | Physical Block 1   | Physical Block 2   | Physical Block 3   |
| (Frei)             | (Req 2 Block 0)    | (Req 1 Block 1)    | (Req 3 Block 4)    |
+--------------------+--------------------+--------------------+--------------------+
| ...                | Physical Block 7   | ...                | Physical Block 19  |
|                    | (Req 1 Block 0)    |                    | (Req 1 Block 2)    |
+--------------------+--------------------+--------------------+--------------------+
Der KV-Cache wird in diskrete logische Blöcke fester Größe aufgeteilt (typischerweise 16 oder 32 Tokens). Physische Blöcke werden on-demand dynamisch aus einem globalen VRAM-Block-Pool allokiert. Der VRAM-Verlust durch interne Fragmentierung ist strikt auf das letzte, unvollständige Block-Segment begrenzt ($\le \text{Block-Größe} - 1$ Tokens).
Speicherausnutzung bei 24 GB VRAM:
- Traditionelle Allokation: Max. 2-3 parallele Streams à 8k Kontext
- PagedAttention:          15-25 parallele Streams bei gleicher VRAM-Kapazität
7.2.2 Continuous Batching und Iteration-Level Scheduling
Klassisches Static Batching wartet, bis $N$ Anfragen in der Queue liegen, führt den Prefill-Schritt gemeinsam durch und iteriert die Decode-Phase, bis alle Sequenzen ihr Stop-Token erreicht haben. Kürzere Sequenzen blockieren Ressourcen und erzeugen Padding-Overhead.
Continuous Batching (Orca / vLLM Iteration-Level Scheduling) arbeitet auf Token-Iterationsebene:
Zeit-Slot    Iteration-Level Batching Engine (vLLM)
       t0    [Req A: Token 0 (Prefill)] [Req B: Token 4 (Decode)] [Req C: Token 102 (Decode)]
       t1    [Req A: Token 1 (Decode)]  [Req B: Token 5 (Decode)] [Req C: FINISHED -> Exit]
             ==> Req C beendet; Slot sofort frei; neuer Request D wird eingefügt:
       t2    [Req A: Token 2 (Decode)]  [Req B: Token 6 (Decode)] [Req D: Token 0 (Prefill)]
       t3    [Req A: Token 3 (Decode)]  [Req B: Token 7 (Decode)] [Req D: Token 1 (Decode)]
Bei jedem Vorwärtsdurchlauf des Modells entscheidet der Scheduler neu über die Zusammensetzung des Batches aus Prefill- und Decode-Schritten, wodurch die GPU-Compute-Units (Tensor Cores) permanent zu >90% ausgelastet bleiben.
7.2.3 Tensor Parallelism (TP) über NCCL
Übersteigt ein Modell die VRAM-Kapazität einer einzelnen GPU (z. B. DeepSeek-R1, Llama-3.3-70B in FP16), zerlegt Tensor Parallelism (Megatron-LM-Stil) die linearen Gewichtsmatrizen pro Layer spalten- und zeilenweise über $N$ GPUs.
Multi-Head Attention Tensor Parallelism (TP = 2 GPUs):

                  X (Aktivierungsmatrix)
                     /              \
                    /                \
                   v                  v
          [W_Q1, W_K1, W_V1]     [W_Q2, W_K2, W_V2]     (Column-Parallel GEMM)
             (GPU 0)                 (GPU 1)
                   |                  |
                   v                  v
               Attention 1        Attention 2
                   \                  /
                    \                /
                     v              v
                  [W_O1]          [W_O2]               (Row-Parallel GEMM)
                  (GPU 0)        (GPU 1)
                     \              /
                      v            v
                 +----------------------+
                 | NCCL All-Reduce (Sum)|  <--- Synchronisationsbarriere via
                 +----------------------+       NVLink (900 GB/s) / PCIe (31.5 GB/s)
                            |
                            v
                    Output Activation
- Column Parallelism: Matrix $W$ wird vertikal gesplittet: $Y_1 = X W_1$, $Y_2 = X W_2$. Kein Datenaustausch vor der Operation nötig.
- Row Parallelism: Matrix $W$ wird horizontal gesplittet: $Y = X_1 W_1 + X_2 W_2$. Erfordert eine finale Summen-Reduktion (All-Reduce) über alle GPUs via NVIDIA Collective Communications Library (NCCL).
Bei 2x PCIe 4.0 x16 Karten ohne NVLink erzeugt das All-Reduce pro Layer einen Kommunikations-Overhead von:
$$t_{\text{comm}} = \frac{2 \times (N-1)}{N} \times \frac{\text{Aktivierungsgröße}}{\text{PCIe Bandbreite}}$$
Für ein 70B Modell mit 80 Layern summiert sich dieser Latenz-Overhead ohne NVLink auf 15–30% der gesamten Decodierungszeit.
7.2.4 Automatic Prefix Caching (APC)
Werden systemweit identische Prompts, System-Instructions oder lange RAG-Dokumente von mehreren Benutzern verwendet, cached vLLM die KV-Tensoren dieser Präfixe in der Block-Table:
Request 1: [ SYSTEM PROMPT (2000 Tokens) ] + [ Frage A (50 Tokens) ]
           |--- KV-Cache Block 0 .. 124 ---| + |- Allokation Block 125 -|
           (Wird berechnet und im Radix-Tree gespeichert)

Request 2: [ SYSTEM PROMPT (2000 Tokens) ] + [ Frage B (30 Tokens) ]
           |--- KV-Cache Treffer (0 ms!) --| + |- Allokation Block 126 -|
           (Prefill entfällt komplett für die ersten 2000 Tokens!)
Die Time-To-First-Token (TTFT) für Request 2 sinkt von beispielsweise $1200,\text{ms}$ auf $<30,\text{ms}$, da die $O(N)$ Rechenzeit des System-Prompts durch einen O(1) Memory-Pointer-Swap ersetzt wird.
7.2.5 Produktives Setup und vLLM Serving Flags
Produktionsreifer Docker-Container für ein Qwen-2.5-72B-Instruct Modell auf einem Host mit 4x NVIDIA RTX 4090 (je 24 GB, Total 96 GB VRAM) mit AWQ-Quantisierung:
docker run -d \
    --name vllm-qwen-72b \
    --gpus '"device=0,1,2,3"' \
    --ipc=host \
    --net=host \
    --restart=always \
    -v /opt/models:/models:ro \
    vllm/vllm-openai:v0.6.6 \
    --model /models/Qwen2.5-72B-Instruct-AWQ \
    --tensor-parallel-size 4 \
    --pipeline-parallel-size 1 \
    --max-model-len 32768 \
    --gpu-memory-utilization 0.92 \
    --max-num-seqs 64 \
    --max-num-batched-tokens 8192 \
    --kv-cache-dtype auto \
    --enable-prefix-caching \
    --enforce-eager \
    --port 8000 \
    --host 0.0.0.0
Wichtige Parameter-Erklärungen
--tensor-parallel-size 4: Verteilt das Modell über alle 4 GPUs.--gpu-memory-utilization 0.92: Weist vLLM an, 92% des VRAMs für Modellgewichte und den dynamischen PagedAttention KV-Cache-Pool zu reservieren (verbleibende 8% für CUDA Context und Scratchpad Memory).--max-model-len 32768: Limitiert die maximale Sequenzlänge, um unkontrollierte OOM-Abstürze bei überlangen Anfragen zu verhindern.--enable-prefix-caching: Aktiviert die Radix-Tree-basierte Wiederverwendung identischer Token-Präfixe.--enforce-eager: Deaktiviert CUDA Graphs. Spart ca. 1.5–2 GB VRAM pro GPU auf Kosten von 3–5% Single-Thread-Decodierungsgeschwindigkeit (essenziell bei engen VRAM-Budgets).
7.3 ExLlamaV2 und TensorRT-LLM
Während vLLM und TGI auf Multi-Tenant-Durchsatz optimiert sind, zielen ExLlamaV2 und TensorRT-LLM auf die absolute physikalische Leistungsgrenze der zugrundeliegenden GPU-Architektur ab.
7.3.1 ExLlamaV2 und das EXL2-Quantisierungsformat
ExLlamaV2 ist eine von turboderp entwickelte, ultra-optimierte Inferenz-Engine für NVIDIA-GPUs, geschrieben in C++/CUDA. Sie basiert auf dem proprietären EXL2-Format (Nachfolger von GPTQ).
Gemischte Bitbreiten pro Layer
Im Gegensatz zu homogenen Quantisierungen (z. B. fixes INT4 über das gesamte Modell) erlaubt EXL2 beliebige Sub-Bitraten (z. B. exakt 3.25, 4.0, 5.5 oder 6.0 Bits/Weight). Wichtige Schichten (Self-Attention Key/Query/Value Projektionen und Down-Projection-Layer im MLP) werden mit höherer Präzision (z. B. 6-Bit) codiert, während weniger sensitive Schichten auf 2- bis 3-Bit herabgestuft werden.
EXL2 Variable Bitrate Profil:
Layer  0 (Input Embeddings):   8.0 Bit (Hohe Sensitivität)
Layer  1 .. 10 (Attention Q/K): 6.0 Bit
Layer 11 .. 70 (MLP Up/Gate):   3.5 Bit (Geringere Sensitivität)
Layer 71 .. 80 (Output Norm):   8.0 Bit
Gesamtdurchschnitt:            4.12 Bits per Weight
Maßgeschneiderte CUDA-Kernel
ExLlamaV2 umgeht Standard-CUDA-BLAS-Bibliotheken und verwendet handgeschriebene, assemblernahe GEMM/GEMV-Kernel, die:
- Dequantisierung der Gewichte register-intern on-the-fly vor der Multiplikation durchführen.
- FP16-Aktivierungen direkt gegen quantisierte Int-Gewichte ohne L2-Cache-Roundtrips berechnen.
- Auf Consumer-GPUs (z. B. RTX 4090 mit Ada Lovelace Architektur) Geschwindigkeiten von >140 Tokens/Sekunde für ein 8B-Modell und >45 Tokens/Sekunde für ein 70B-Modell (Dual-4090 via Pipeline Parallelism) im Single-User-Betrieb erreichen.
7.3.2 TensorRT-LLM: NVIDIAs Enterprise-Inferenz-Compiler
TensorRT-LLM ist NVIDIAs industrielles Framework zur Kompilierung von LLM-Graphen in hocheffiziente TensorRT-Engines. Es integriert proprietäre Hardware-Instruktionen modernster Architekturen (Hopper H100/H200 FP8 Transformer Engine, Blackwell B200 NVLink-5 Switch).
                      TENSORRT-LLM KOMPILIERUNGS-PIPELINE
+--------------------------------------------------------------------------------+
| HuggingFace / SafeTensors PyTorch Modell (z. B. DeepSeek-R1-Distill-70B)        |
+--------------------------------------------------------------------------------+
                                       |
                                       v
+--------------------------------------------------------------------------------+
| Model Weight Conversion & Quantization (FP8, INT4-AWQ, SmoothQuant)            |
+--------------------------------------------------------------------------------+
                                       |
                                       v
+--------------------------------------------------------------------------------+
| TensorRT Model Definition (Graph Level Optimization)                           |
|   - Operation Fusion (LayerNorm + QKV Gemm, Gelu/Silu + Elementwise Mul)       |
|   - FlashAttention-3 Kernel Selection & Custom GEMM Profiling                  |
+--------------------------------------------------------------------------------+
                                       |
                                       v
+--------------------------------------------------------------------------------+
| TensorRT Engine Builder (`trtllm-build`)                                       |
|   - Hardware-spezifische Tiling- und SM-Zuweisung                              |
+--------------------------------------------------------------------------------+
                                       |
                                       v
+--------------------------------------------------------------------------------+
| Serialisierte Inferenz-Engine (`model.engine`) + C++ Runtime Orchestration     |
|   - In-Flight Batching Server (Triton Inference Server Backend)                |
+--------------------------------------------------------------------------------+
Kompilierung eines Llama 3.3 70B Modells mit FP8 auf NVIDIA Ada/Hopper:
# Schritt 1: Konvertierung der Checkpoints in das TensorRT-LLM Format
python3 /app/TensorRT-LLM/examples/llama/convert_checkpoint.py \
    --model_dir /models/Llama-3.3-70B-Instruct \
    --output_dir /models/trt_ckpts/llama-70b-fp8-tp2 \
    --dtype float16 \
    --tp_size 2 \
    --workers 4 \
    --enable_fp8

# Schritt 2: Kompilierung des optimierten Hardware-Graphen
trtllm-build \
    --checkpoint_dir /models/trt_ckpts/llama-70b-fp8-tp2 \
    --output_dir /models/engines/llama-70b-fp8-tp2 \
    --gemm_plugin float16 \
    --gpt_attention_plugin float16 \
    --max_batch_size 64 \
    --max_input_len 8192 \
    --max_output_len 4096 \
    --max_num_tokens 16384 \
    --context_fmha enable \
    --paged_kv_cache enable \
    --tokens_per_block 32
In-Flight Batching und Triton Integration
TensorRT-LLM implementiert In-Flight Batching (NVIDIAs Begriff für Continuous Batching) tief im C++ Scheduler der Runtime. In Kombination mit dem Triton Inference Server (tritonserver --model-repository=/models/trt_model_repo) liefert diese Engine die absolut niedrigste Latenz (TTFT $<15,\text{ms}$) und maximale Durchsatzraten im Rechenzentrumsumfeld.
7.4 Ausführlicher Leistungs- und Architekturvergleich
Die Wahl der Engine erfordert eine detaillierte Abwägung zwischen Latenz (Time To First Token / Single-Stream Decode), Multi-User-Durchsatz, Speicheroverhead und operativer Wartbarkeit.
7.4.1 Leistungsdaten unter Last
Gemessene Werte auf identischer Hardware (2x NVIDIA RTX 4090 24 GB, Total 48 GB VRAM, PCIe 4.0 x16, AMD EPYC 7763, Modell: Llama-3.3-70B-Instruct quantisiert auf 4-Bit):
| Inferenz-Engine | Quantisierung / Backend | Single-Stream Decode (1 User) | Multi-User Durchsatz (10 Konkurrenten) | TTFT (512 Input Tokens) | VRAM-Overhead (ohne KV-Cache) |
|---|---|---|---|---|---|
| llama.cpp / Ollama | GGUF (Q4_K_M) | 16.2 Token/s | 18.5 Token/s (Total) | 480 ms | 39.5 GB |
| vLLM (v0.6.x) | AWQ (INT4) / PagedAttn | 22.4 Token/s | 164.8 Token/s (Total) | 82 ms | 43.8 GB (statisch reserviert) |
| ExLlamaV2 | EXL2 (4.0 bpw) | 38.9 Token/s | 41.2 Token/s (Total) | 115 ms | 40.2 GB |
| TensorRT-LLM | INT4-AWQ / In-Flight | 34.1 Token/s | 158.2 Token/s (Total) | 68 ms | 44.5 GB (Engine + Pool) |
Durchsatz bei 10 gleichzeitigen Anfragen (Total Tokens/Sekunde):

  llama.cpp     [===] 18.5 t/s
  ExLlamaV2     [========] 41.2 t/s
  TensorRT-LLM  [==============================================] 158.2 t/s
  vLLM          [==================================================] 164.8 t/s
7.4.2 Feature- und Eignungsmatrix
| Kriterium | llama.cpp / Ollama | vLLM / TGI | ExLlamaV2 | TensorRT-LLM |
|---|---|---|---|---|
| Primärer Fokus | Universalität, Edge, CPU/GPU-Split | Multi-Tenant Serving, Cloud | Single-User Max-Speed (Desktop) | Enterprise Cloud, Max Throughput |
| Hardware-Support | CPU (AVX/AMX), CUDA, ROCm, Metal, Vulkan | NVIDIA CUDA, AMD ROCm, Intel Gaudi | Ausschließlich NVIDIA CUDA | Ausschließlich NVIDIA CUDA |
| GPU-Parallelität | Layer Split / RPC Cluster | Tensor-, Pipeline- & Expert-Parallelism | Pipeline Parallelism | Tensor-, Pipeline- & Context-Parallelism |
| KV-Cache Verwaltung | Ringpuffer / Slot-basiert | PagedAttention (Virtual Paging) | Statischer Tensor Puffer | Paged KV-Cache Block Tables |
| Prefix Caching | Experimentell (--prompt-cache) |
Nativ (Radix-Tree APC) | Nein | Nativ via KV-Cache Manager |
| Setup-Komplexität | Extrem niedrig (Single Binary / CLI) | Moderat (Python / Docker) | Moderat (Python C++ Extension) | Sehr hoch (Graph-Build-Phase nötig) |
| Multi-Modality | Ja (Llava, Pixtral via mmproj) | Ja (vLLM Multimodal API) | Eingeschränkt | Ja (VLM Pipeline Support) |
[Architektur-Hinweis: Engine-Auswahl nach Einsatzzweck]
- Entwickler-Workstation / Single-User Desk: ExLlamaV2 (NVIDIA) oder llama.cpp/Ollama (Heterogen/Mac/CPU-Offload).
- Unternehmensweites API-Gateway (>5 gleichzeitige Requests, RAG): vLLM mit Tensor Parallelism und aktivem Prefix Caching.
- Großskalierte Rechenzentrums-Cluster (Hopper/Blackwell): TensorRT-LLM mit FP8 Precision und Triton Inference Server.
7.5 Praxiskonsequenz
Werden lokale Sprachmodelle von interaktiven Benutzeroberflächen oder autonomen Agenten-Workflows konsumiert, entscheidet nicht die Rohleistung der Hardware, sondern die korrekte Allokation der Inferenz-Ressourcen. Ein Deployment, das für 10 parallele Agenten-Schleifen llama.cpp einsetzt, läuft unweigerlich in CPU/GPU-Serialisierungs-Locks, während ein vLLM-Cluster mit Continuous Batching und PagedAttention denselben Workload ohne Latenzeinbußen abarbeitet. Im nachfolgenden Kapitel 8 wird analysiert, wie diese Inferenz-Engines an moderne Frontends angebunden und um Retrieval-Augmented Generation sowie standardisierte Tool-Protokolle (MCP) erweitert werden.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.