Frontends, RAG & MCP
Open WebUI, Retrieval und Tool-Anbindung.
Open WebUI, Retrieval und Tool-Anbindung. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
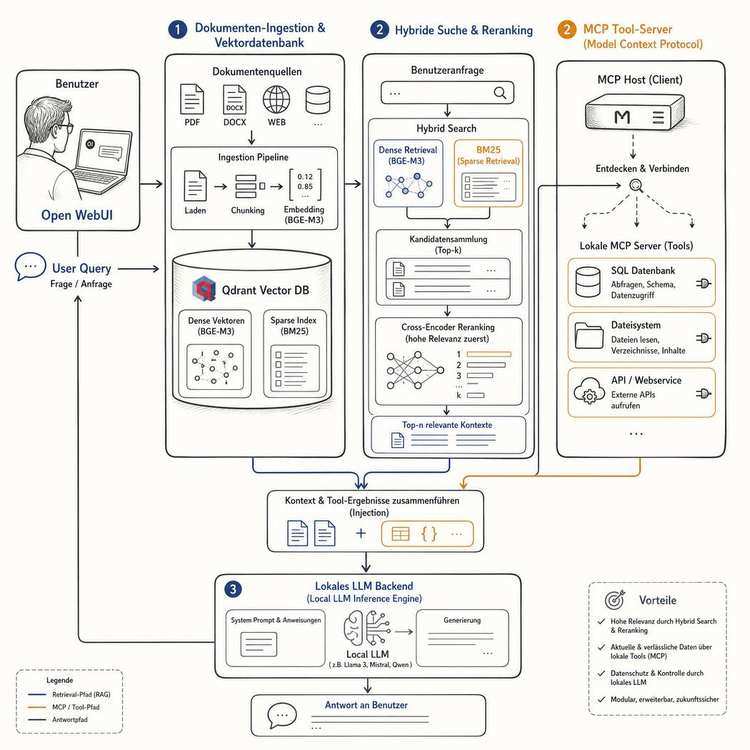
Kapitel 8: Frontends, RAG-Architekturen und Model Context Protocol (MCP)
Die Bereitstellung lokaler Sprachmodelle erfordert eine robuste Abstraktionsschicht zwischen Inferenz-Engine, Datenquellen und Endbenutzern. Dieses Kapitel analysiert moderne Benutzeroberflächen, Enterprise-taugliche Retrieval-Augmented-Generation-(RAG)-Pipelines und die standardisierte Werkzeugintegration über das Model Context Protocol (MCP).
+--------------------------------------------------------------------------------------------------+
|                                     BENUTZER / AGENTEN-CLIENTS                                   |
|               (Open WebUI, AnythingLLM, LibreChat, Autonome Agenten-Frameworks)                  |
+--------------------------------------------------------------------------------------------------+
                                                 |
                       +-------------------------+-------------------------+
                       |                                                   |
                       v                                                   v
+-----------------------------------------------+   +----------------------------------------------+
|             RETRIEVAL LAYER (RAG)             |   |        TOOL & INTEGRATION LAYER (MCP)         |
|  - Parsing & Chunking (Docling, Semantic)     |   |  - MCP Host (Tool Discovery, Routing)        |
|  - Embeddings (BGE-M3 Dense + Sparse)         |   |  - MCP Server (DBs, Shell, APIs, Filesystem) |
|  - Hybrid Search (Qdrant / pgvector + BM25)   |   |  - Structured Extraction (Outlines / JSON)   |
|  - Cross-Encoder Reranking (bge-reranker)     |   |                                              |
+-----------------------------------------------+   +----------------------------------------------+
                       \                                                   /
                        \------------------------+------------------------/
                                                 |
                                                 v
+--------------------------------------------------------------------------------------------------+
|                                 INFERENCE BACKEND (OpenAI API Layer)                             |
|               (vLLM / Ollama / llama.cpp / TensorRT-LLM: Qwen 2.5, Llama 3.3, DeepSeek-R1)       |
+--------------------------------------------------------------------------------------------------+
8.1 Benutzeroberflächen und Workspace-Management
Lokale Frontends müssen heute weit mehr leisten als ein simples Chat-Interface. Sie fungieren als Identitäts-Provider, Dokumenten-Gateway und Routing-Proxy.
+-------------------------------------------------------------------------------------------------------+
| SYSTEM-VERGLEICH LOKALER LLM-FRONTENDS                                                                |
+-------------------+--------------------+--------------------+--------------------+--------------------+
| Feature           | Open WebUI         | AnythingLLM        | LibreChat          | LM Studio          |
+-------------------+--------------------+--------------------+--------------------+--------------------+
| Primäre Zielgruppe| Self-Hosted Power  | Business Teams &   | Enterprise Multi-  | Lokale Entwickler  |
|                   | & Enterprise Teams | Abteilungen        | LLM Plattform      | & Modell-Tester    |
+-------------------+--------------------+--------------------+--------------------+--------------------+
| Architektur       | Python / FastAPI + | Node.js + React /  | Node.js / Express  | Native Desktop App |
|                   | SvelteKit          | Electron / Docker  | + React / Mongo    | (Electron/C++)     |
+-------------------+--------------------+--------------------+--------------------+--------------------+
| Multi-User & RBAC | Ja (Vollständig,   | Ja (Workspaces,    | Ja (Enterprise SSO,| Nein (Single-User  |
|                   | SCIM / OAuth / OIDC| Rollenverwaltung)  | LDAP, SAML2, OIDC) | Desktop-Fokus)     |
+-------------------+--------------------+--------------------+--------------------+--------------------+
| Dokumenten-RAG    | Nativ (Chroma /    | Nativ (LanceDB /   | Modular (Plugins / | Experimentell /    |
|                   | Qdrant / Hybrid)   | Pinecone / Chroma) | RAG-Service API)   | Eingeschränkt      |
+-------------------+--------------------+--------------------+--------------------+--------------------+
| Tool-Calling / MCP| Ja (Open WebUI     | Eingeschränkt      | Ja (Nativer MCP    | Eingeschränkt      |
|                   | Tools / Actions)   | (Custom Agents)    | Host Support)      | (Local Server API) |
+-------------------+--------------------+--------------------+--------------------+--------------------+
| Inferenz-Engine   | Ollama, vLLM, jede | Ollama, LocalAI,   | vLLM, Ollama, Alle | Integrierte        |
| Anbindung         | OpenAI-komp. API   | Cloud APIs         | Cloud-Provider     | llama.cpp Engine   |
+-------------------+--------------------+--------------------+--------------------+--------------------+
8.1.1 Open WebUI
Open WebUI (ehemals Ollama WebUI) hat sich als de-facto Standard für produktive On-Premise-Deployments etabliert. Es bietet:
- Feingranulare Rollenverwaltung (RBAC): Admin-, User- und Gast-Profile mit Quotas bezüglich Token-Limits und Modellzugriffen.
- Modelfile- und Pipeline-Engine: Definition maßgeschneiderter System-Prompts, Funktionsaufrufe und Inferenzparameter direkt über die UI.
- Integrierte RAG-Engine: Vollständige Dokumentenindizierung mit konfigurierbaren Chunking- und Embedding-Modellen (lokal via Sentence-Transformers oder remote via Ollama/vLLM).
- Web-Search-Integration: Direkte Anbindung lokaler Suchmaschinen-Instanzen (SearXNG) oder APIs (Tavily, Brave), um dem Modell Live-Internetkontexte zuzuführen.
Produktionsreifes Docker-Compose Setup (Open WebUI + SearXNG + vLLM):
version: '3.8'

services:
  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    container_name: open-webui
    restart: always
    ports:
      - "3000:8080"
    environment:
      - OPENAI_API_BASE_URLS=http://vllm-backend:8000/v1
      - OPENAI_API_KEYS=sk-local-token-9988
      - WEB_SEARCH_ENGINE=searxng
      - SEARXNG_QUERY_URL=http://searxng:8080/search?q=<query>
      - RAG_EMBEDDING_ENGINE=ollama
      - RAG_OLLAMA_BASE_URL=http://ollama-embed:11434
      - RAG_EMBEDDING_MODEL=bge-m3:latest
      - CHAT_COMPLETION_TIMEOUT=300
    volumes:
      - open-webui-data:/app/backend/data
    depends_on:
      - searxng

  searxng:
    image: docker.io/searxng/searxng:latest
    container_name: searxng
    restart: always
    environment:
      - SEARXNG_BASE_URL=http://localhost:8080/
    volumes:
      - ./searxng-settings.yml:/etc/searxng/settings.yml:ro

volumes:
  open-webui-data:
8.1.2 AnythingLLM und LibreChat
- AnythingLLM: Zeichnet sich durch sein striktes Workspace-Konzept aus. Dokumente und Vektordatenbank-Indizes werden isolierten Arbeitsbereichen zugewiesen. Es ermöglicht die klare Trennung von Mandanten oder Fachabteilungen (z. B. "Rechtsabteilung" vs. "Engineering") mit jeweils eigenen Vektorräumen.
- LibreChat: Enterprise-Grade Chat-Plattform mit nativer Unterstützung für komplexe Routing-Architekturen. Erlaubt es, Anfragen dynamisch anhand von Task-Kriterien auf vLLM, lokale Ollama-Instanzen oder Cloud-Backends zu leiten, inklusive nativer Integration des Model Context Protocol (MCP).
- LM Studio: Lokale Desktop-Applikation für Windows, macOS und Linux, optimiert für Entwickler zum Testen, Prompt-Tuning und schnellen Benchmarking lokaler GGUF-Modelle mit integriertem lokalen Server-Modus.
8.2 Retrieval-Augmented Generation (RAG) Deep Dive
Standard-LLMs verfügen über kein Wissen über interne Unternehmensdaten und neigen bei Faktenfragen zu Halluzinationen. Eine industrielle RAG-Pipeline ersetzt unsichere Wissensgenerierung durch gezieltes Dokumenten-Retrieval und nachvollziehbare Kontext-Injektion.
                                 RAG PIPELINE ARCHITEKTUR
+--------------------------------------------------------------------------------------------------+
| 1. INGESTION PHASE                                                                               |
| Raw PDFs/Docs ---> Docling Parsing ---> Semantic Chunking ---> BGE-M3 Dense + Sparse Vectors    |
|                                                                    |                             |
|                                                                    v                             |
|                                                      Qdrant / pgvector DB (Hybrid Index)         |
+--------------------------------------------------------------------------------------------------+
| 2. RETRIEVAL & SERVING PHASE                                                                     |
| User Query: "Wie hoch ist das Drehmoment der Schraube M8 in Baugruppe 4?"                       |
|       |                                                                                          |
|       +---> Dense Vector (Cosine Similarity)  ---+                                               |
|       |                                          |---> Reciprocal Rank Fusion (RRF)              |
|       +---> Sparse BM25 (Exact Token Matches) ---+                    |                          |
|                                                                       v                          |
|                                                            Top-25 Kandidaten-Chunks              |
|                                                                       |                          |
|                                                                       v                          |
|                                                            Cross-Encoder Reranker                |
|                                                            (BAAI/bge-reranker-large)             |
|                                                                       |                          |
|                                                                       v                          |
|                                                            Top-5 Relevante Chunks                |
|                                                                       |                          |
|                                                                       v                          |
|                                                            Anti-Halluzinations-Prompt            |
|                                                                       |                          |
|                                                                       v                          |
|                                                            LLM Generation (Llama 3.3 / Qwen 2.5) |
+--------------------------------------------------------------------------------------------------+
8.2.1 Dokument-Parsing und Extraktion
Konventionelle Textextraktoren (z. B. pypdf, pdfplumber) scheitern an komplexen Layouts, mehrspaltigen wissenschaftlichen Texten und geschachtelten Tabellen.
Moderne Pipelines nutzen:
- Docling (IBM Research): Verwendet spezialisierte Vision-Layout-Modelle, um Dokumente in ein strukturiertes Markdown/DoclingDocument-Format zu transformieren. Tabellen werden als valides Markdown oder HTML extrahiert, wodurch die Zell-Spalten-Semantik vollständig erhalten bleibt.
- Unstructured.io: Zerlegt Dokumente regelbasiert und modellgestützt in semantische Elemente (Title, NarrativeText, ListItem, Table).
8.2.2 Chunking-Strategien
Die Segmentierung der Texte entscheidet über die Qualität des Embeddings:
- Recursive Character Text Splitting:
Spaltet hierarchisch nach Trennzeichen["\n\n", "\n", " ", ""]mit fester Chunk-Größe (z. B. 512 Tokens) und Überlappung (Overlap z. B. 64 Tokens).- Nachteil: Trennt zusammenhängende Gedankengänge mitten im Argument ab.
- Semantic Chunking:
Berechnet Satz-Embeddings im gleitenden Fenster. Überschreitet die Cosine-Distanz zwischen aufeinanderfolgenden Sätzen einen Schwellenwert (z. B. 95. Perzentil), wird eine semantische Chunk-Grenze gesetzt:
$$\text{Distanz}(S_i, S_{i+1}) = 1 - \cos(\vec{e}(S_i), \vec{e}(S_{i+1}))$$
import numpy as np
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("BAAI/bge-m3")

def semantic_chunking(sentences: list[str], threshold_percentile: float = 90.0) -> list[str]:
    embeddings = model.encode(sentences, normalize_embeddings=True)
    distances = [1 - np.dot(embeddings[i], embeddings[i+1]) for i in range(len(embeddings)-1)]

    threshold = np.percentile(distances, threshold_percentile)
    chunks = []
    current_chunk = [sentences[0]]

    for idx, dist in enumerate(distances):
        if dist > threshold:
            chunks.append(" ".join(current_chunk))
            current_chunk = [sentences[idx+1]]
        else:
            current_chunk.append(sentences[idx+1])
    chunks.append(" ".join(current_chunk))
    return chunks
8.2.3 Embedding-Generierung mit BGE-M3
Das Modell BAAI/bge-m3 ist der State-of-the-Art Standard für lokale Embeddings im Jahr 2026:
- Multilingual: Exzellente Repräsentation deutscher Fachtexte.
- Multi-Functionality: Erzeugt simultan:
- Dense Embeddings (1024 Dimensionen) für semantische Ähnlichkeit.
- Sparse Embeddings (Lexikalische Term-Weights analog zu BM25/SPLADE) für exakte Schlüsselwörter und Seriennummern.
- Multi-Vector ColBERT-Style Embeddings für Token-Level Interaktionen.
- Lange Kontexte: Unterstützt Sequenzlängen bis 8192 Tokens.
8.2.4 Vektordatenbanken im Vergleich
| Vektordatenbank | Architektur | Hybrid Search (Dense + Sparse) | Filter-Performance (Payload HNSW) | Deployment-Footprint |
|---|---|---|---|---|
| Qdrant | Rust Nativ | Erstklassig (Nativ Sparse + Dense Vectors) | Extrem hoch (Payload Indexing im HNSW Graph) | Single Binary / Minimaler VRAM/RAM Bedarf |
| pgvector (PostgreSQL) | C Extension | Möglich (pgvector + PostgreSQL Full-Text Search) | Gut (Standard SQL Indizes + HNSW Index) | Existierende Postgres-Infrastruktur nutzbar |
| ChromaDB | Python / SQLite | Eingeschränkt (Primär Dense) | Moderat | Ideal für lokale Prototypen und Single-Node |
8.2.5 Hybrid Search und Reciprocal Rank Fusion (RRF)
Dense Embeddings versagen oft bei exakten Artikelnummern, Variablen-Namen oder spezifischen Fehlercodes (z. B. ERR_401_AUTH_EXPIRED), da diese im Vektorraum keinen klaren semantischen Nachbarn haben.
Die Hybrid Search kombiniert dichte Vektorsuche mit lexikalischer BM25-Suche mittels Reciprocal Rank Fusion (RRF):
$$RRF_Score(d \in D) = \sum_{m \in M} \frac{1}{k + r_m(d)}$$
Wobei $M = {\text{Dense}, \text{Sparse}}$, $r_m(d)$ der Rang des Dokuments im Suchlauf $m$ ist und $k$ eine Glättungskonstante (Standard $k=60$).
Suchanfrage: "Fehlercode 0x80070005 beim Zugriff auf Registry"

Dense Search Top 3:                      Sparse BM25 Top 3:
1. Doc A (Rechtevergabe Windows)         1. Doc C (Systemfehler 0x80070005)
2. Doc B (Registry Optimierung)          2. Doc A (Rechtevergabe Windows)
3. Doc C (Systemfehler 0x80070005)       3. Doc D (Dateizugriff verweigert)

RRF-Berechnung (k=60):
Doc A: 1/(60 + 1) + 1/(60 + 2) = 0.01639 + 0.01612 = 0.03251
Doc C: 1/(60 + 3) + 1/(60 + 1) = 0.01587 + 0.01639 = 0.03226  <-- Exakter Match hochgerankt!
Doc B: 1/(60 + 2) + 0          = 0.01612 + 0.00000 = 0.01612
8.2.6 Cross-Encoder Reranking mit bge-reranker-large
Bi-Encoder (Standard-Embeddings) berechnen Dokument- und Query-Vektoren getrennt voneinander ($S = \cos(\vec{u}, \vec{v})$). Ein Cross-Encoder führt die Query und den Kandidaten-Text gemeinsam in ein Self-Attention-Modell ein ($S = \text{Model}(Query \circ Passage)$), wodurch alle Tokens der Query mit allen Tokens des Dokuments interagieren können.
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("BAAI/bge-reranker-large", max_length=512)

query = "Wie konfiguriere ich PagedAttention in vLLM?"
passages = [
    "vLLM nutzt PagedAttention, um KV-Cache-Fragmentierung via Paged Memory Blöcken zu verhindern.",
    "TensorRT-LLM verwendet In-Flight Batching zur Optimierung von Decodierungs-Schritten.",
    "Die Installation von Docker erfordert das Hinzufügen des offiziellen Repositories."
]

# Berechne präzise Relevanz-Scores
scores = reranker.predict([(query, p) for p in passages])
# Resultierende Scores: [0.982, 0.124, 0.001]
8.2.7 Context Injection und Anti-Halluzinations-Prompts
Zur Minimierung von Halluzinationen muss der extrahierte Kontext strikt abgegrenzt und mit expliziten System-Schranken versehen werden:
<|im_start|>system
Du bist ein präziser, faktenbasierter technischer Assistent. Deine Aufgabe ist es, die Frage des Benutzers AUSSCHLIESSLICH unter Verwendung der bereitgestellten Dokumentenauszüge (QUICK_CONTEXT) zu beantworten.

STRIKTE REGELN:
1. Wenn die Antwort nicht eindeutig und vollständig aus dem QUICK_CONTEXT hervorgeht, antworte exakt mit: "Die bereitgestellten Dokumente enthalten keine ausreichenden Informationen zur Beantwortung dieser Frage."
2. Spekuliere keinesfalls und nutze kein externes Vorwissen.
3. Zitiere bei jeder getroffenen Aussage die Quelldokument-ID im Format [Dokument X].
<|im_end|>
<|im_start|>user
QUICK_CONTEXT:
---
[Dokument 1] (Quelle: server_manual.pdf, Seite 42)
Das Drehmoment für Schrauben der Festigkeit 8.8 beträgt im Motorgehäuse exakt 25 Nm.
---
[Dokument 2] (Quelle: safety_guidelines.pdf, Seite 3)
Vor Arbeiten am Drehmomentwandler ist das System spannungsfrei zu schalten.
---

FRAGE: Mit welchem Drehmoment müssen die Schrauben im Motorgehäuse angezogen werden?
<|im_end|>
<|im_start|>assistant
Gemäß den Angaben im Handbuch müssen die Schrauben im Motorgehäuse mit einem Drehmoment von exakt 25 Nm angezogen werden [Dokument 1].
<|im_end|>
8.3 Agentic Workflows und Model Context Protocol (MCP)
Autonome Agenten erfordern standardisierte Schnittstellen zur Außenwelt. Das von Anthropic initiierte und 2026 universell adaptierte Model Context Protocol (MCP) etabliert einen offenen Standard für die Kommunikation zwischen Sprachmodellen, Entwicklungsumgebungen und Werkzeugen.
+--------------------------------------------------------------------------------------------------+
|                                    MCP CLIENT / HOST LAYER                                       |
|                  (Open WebUI / LibreChat / Claude Desktop / Custom Agent)                        |
|  - Manages Connections, Security Sandboxing, Human-in-the-Loop Confirmation                     |
+--------------------------------------------------------------------------------------------------+
          |                                  |                                  |
          | (JSON-RPC 2.0 over Stdio)        | (JSON-RPC 2.0 over SSE / HTTP)   | (Stdio)
          v                                  v                                  v
+-----------------------+          +-----------------------+          +-----------------------+
|   MCP SERVER: SQL DB  |          |  MCP SERVER: SYSTEM   |          |  MCP SERVER: GIT/CODE |
|  - Exposes: read_query|          |  - Exposes: bash_exec |          |  - Exposes: get_diff  |
|  - Resource: schemas  |          |  - Resource: logs     |          |  - Prompt: review_pr  |
+-----------------------+          +-----------------------+          +-----------------------+
8.3.1 Function Calling und Structured Extraction
Damit lokale Modelle (z. B. Qwen 2.5-Coder 32B, Llama 3.3 70B) Werkzeuge zuverlässig bedienen können, muss die Ausgabe strikt auf ein valides JSON-Schema begrenzt werden.
Klassische RegEx-Validierung nach der Generierung führt zu häufigen Parsing-Fehlern. Moderne Systeme erzwingen die Einhaltung des Schemas während der Token-Generierung durch Guided Decoding / Grammar Constrained Decoding (Bibliotheken: Outlines, llama.cpp Grammars, vLLM Guided Decoding):
                                  GUIDED DECODING PROZESS
Logits des Modells (Vokabular-Wahrscheinlichkeiten für nächstes Token)
                          |
                          v
+-----------------------------------------------------------------------+
| JSON-Schema / EBNF Finite State Machine (FSM) Masking Filter          |
| Maskiert alle Tokens im Vokabular mit -Infinity, die das JSON-Schema |
| an der aktuellen Cursor-Position verletzen würden.                     |
+-----------------------------------------------------------------------+
                          |
                          v
Nur syntaktisch gültige Fortsetzungen sind wählbar (Garantiert 100% valides JSON)
Beispiel mit outlines für deterministische Tool-Argumente:
import outlines
from pydantic import BaseModel, Field

class DatabaseQueryTool(BaseModel):
    database: str = Field(description="Name der Zieldatenbank")
    query: str = Field(description="SQL-SELECT-Query")
    limit: int = Field(default=10, ge=1, le=100)

model = outlines.models.transformers("Qwen/Qwen2.5-Coder-32B-Instruct")
generator = outlines.generate.json(model, DatabaseQueryTool)

prompt = "Finde die 5 neuesten Kunden in der PostgreSQL Datenbank 'crm_prod'."
result = generator(prompt)
print(result.database)  # 'crm_prod'
print(result.query)     # 'SELECT * FROM customers ORDER BY created_at DESC LIMIT 5;'
print(result.limit)     # 5
8.3.2 Anthropic Model Context Protocol (MCP) Architektur
MCP definiert ein asynchrones JSON-RPC 2.0 Protokoll zwischen drei Primärrollen:
- MCP Host: Die Anwendung (z. B. LibreChat, Open WebUI, Claude Desktop), die die Benutzeroberfläche bereitstellt und das LLM koordiniert.
- MCP Client: Die Protokoll-Instanz innerhalb des Hosts, die 1:1-Verbindungen zu Servern aufrechterhält.
- MCP Server: Leichtgewichtige Prozesse, die über
stdiooder Server-Sent Events (SSE) Werkzeuge (Tools), Datenquellen (Resources) und Vorlagen (Prompts) bereitstellen.
MCP Protokoll-Elemente:
- Tools: Ausführbare Funktionen mit JSON-Schema (z. B.
execute_sql,fetch_webpage). Erfordern explizite Bestätigung oder Richtlinien-Prüfung. - Resources: Passive Datenquellen (z. B. Dateiinhalte, Systemmetriken, Datenbankschemata), die der Host als Kontext anfordern kann.
- Prompts: Vordefinierte strukturierte Interaktionsmuster.
Implementierung eines maßgeschneiderten lokalen MCP-Servers in Python:
#!/usr/bin/env python3
"""Lokaler MCP Server zur kontrollierten Abfrage von Host-Metriken."""
import json
import psutil
from mcp.server.fastmcp import FastMCP

mcp = FastMCP("HostMetricsServer")

@mcp.tool()
def get_system_load() -> str:
    """Liefert die aktuelle CPU-, RAM- und Festplattenauslastung des lokalen Hosts."""
    cpu_percent = psutil.cpu_percent(interval=1)
    memory = psutil.virtual_memory()
    disk = psutil.disk_usage('/')

    metrics = {
        "cpu_usage_percent": cpu_percent,
        "ram_used_gb": round(memory.used / (1024**3), 2),
        "ram_total_gb": round(memory.total / (1024**3), 2),
        "ram_percent": memory.percent,
        "disk_free_gb": round(disk.free / (1024**3), 2),
        "disk_percent": disk.percent
    }
    return json.dumps(metrics, indent=2)

@mcp.tool()
def read_log_snippet(filepath: str, max_lines: int = 50) -> str:
    """Liest die letzten N Zeilen einer System-Logdatei sicher aus."""
    allowed_dirs = ["/var/log/", "/opt/app/logs/"]
    if not any(filepath.startswith(d) for d in allowed_dirs):
        raise ValueError(f"Zugriff verweigert: Pfad {filepath} liegt außerhalb erlaubter Verzeichnisse.")

    with open(filepath, 'r', encoding='utf-8', errors='ignore') as f:
        lines = f.readlines()
        return "".join(lines[-max_lines:])

if __name__ == "__main__":
    mcp.run(transport="stdio")
Einbindung des MCP-Servers in der Host-Konfiguration (mcp_config.json):
{
  "mcpServers": {
    "host-metrics": {
      "command": "python3",
      "args": ["/opt/mcp/servers/host_metrics_server.py"],
      "env": {
        "PYTHONPATH": "/opt/mcp/venv/lib/python3.11/site-packages"
      }
    },
    "postgres-enterprise": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-postgres",
        "postgresql://pguser:secretpass@localhost:5432/enterprise_db"
      ]
    }
  }
}
8.4 Lokale autonome Agenten-Architekturen
Werden Inferenz-Engine, RAG-Pipeline und MCP-Server verknüpft, entstehen vollständig lokale, autonome Agenten, die komplexe mehrstufige Aufgaben iterativ abarbeiten (ReAct-Muster: Reasoning + Acting).
                      REPOS-TO-CODE AGENTEN-LOOP
+------------------------------------------------------------------------------------+
| AUFGABE: "Optimiere die SQL-Queries in repository_v2 und prüfe die Logs"            |
+------------------------------------------------------------------------------------+
                                          |
                                          v
+------------------------------------------------------------------------------------+
| THOUGHT (Llama 3.3 / Qwen 2.5-Coder):                                              |
| "Ich muss zunächst die slow_queries.log analysieren, um die Engpässe zu identifizieren." |
+------------------------------------------------------------------------------------+
                                          |
                                          v
+------------------------------------------------------------------------------------+
| ACTION: Aufruf MCP Tool `read_log_snippet(filepath='/var/log/slow_queries.log')`    |
+------------------------------------------------------------------------------------+
                                          |
                                          v
+------------------------------------------------------------------------------------+
| OBSERVATION: MCP Server liefert: `SELECT * FROM users WHERE active = true; (850ms)`|
+------------------------------------------------------------------------------------+
                                          |
                                          v
+------------------------------------------------------------------------------------+
| THOUGHT: "Die Tabelle users benötigt einen partiellen Index auf `active`."         |
+------------------------------------------------------------------------------------+
                                          |
                                          v
+------------------------------------------------------------------------------------+
| ACTION: Aufruf MCP Tool `postgres_query(sql='CREATE INDEX idx_active...')`         |
+------------------------------------------------------------------------------------+
                                          |
                                          v
+------------------------------------------------------------------------------------+
| FINAL RESPONSE: Dokumentation der durchgeführten Optimierung an den Benutzer.       |
+------------------------------------------------------------------------------------+
Durch das Zusammenspiel aus deterministischem Guided Decoding, strikter MCP-Typisierung und lokal gehosteten State-of-the-Art Modellen erreichen On-Premise-Umgebungen im Jahr 2026 eine funktionale Autonomie und Zuverlässigkeit, die vormals proprietären Cloud-Diensten vorbehalten war. Im nachfolgenden Kapitel 11 wird detailliert dargestellt, wie diese Systeme im Unternehmensnetzwerk gehärtet, überwacht und über sichere API-Gateways in bestehende IT-Infrastrukturen integriert werden.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.