Homelab & Privat-Setups
Vom Refurbished-Rechner zur Dual-GPU-Workstation.
Vom Refurbished-Rechner zur Dual-GPU-Workstation. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
Kapitel 9: Homelab & Enthusiast-Setups: Vom 500-Euro-Rig bis zum Multi-GPU-Server
Der Betrieb lokaler Large Language Models im Heimbereich oder im kleinen Entwicklerbüro verlangt eine kompromisslose Ausrichtung an den physikalischen Engpässen von Inferenz-Engines. Im Gegensatz zu klassischen Workstation-Workloads wie 3D-Rendering, Videocodierung oder Gaming ist LLM-Inferenz im autoregressiven Token-Generierungsmodus fast vollständig speicherbandbreitenlimitiert (Memory Bandwidth Bound). Die Vorberechnung des Eingabekontexts (Prompt Processing / Prefill) skaliert mit der Rechenleistung der Tensorkerne (Compute Bound), die anschließende Generierung jedes einzelnen Tokens erfordert jedoch den vollständigen Transfer aller Modellgewichte aus dem Videospeicher in die Recheneinheiten des Grafikprozessors.
Eine realistische Systemplanung setzt daher an drei fundamentalen Hardware-Parametern an:
- Speicherkapazität (VRAM / Unified Memory): Bestimmt die maximale Modellgröße (Parameteranzahl) und den Quantisierungsgrad sowie die für den KV-Cache reservierbare Kontextlänge.
- Speicherbandbreite ($\text{GB/s}$): Bestimmt die theoretische Obergrenze der Generierungsgeschwindigkeit bei Batch Size 1 ($T_{\text{max}} = \frac{\text{Bandbreite}}{\text{Modellgröße im VRAM}}$).
- PCIe-Topologie und Bandbreite: Bestimmt bei Multi-GPU-Setups den Durchsatz der Tensor-Parallelschaltung (TP) und Pipeline-Parallelschaltung (PP).
+---------------------------------------------------------------------------------------------------+
|                                 LLM INFERENZ-ENGPASS-DIAGRAMM                                      |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|  [ PREFILL-PHASE / PROMPT-PROCESSING ]              [ DECODING-PHASE / TOKEN-GENERIERUNG ]        |
|  - Viele Tokens parallel                            - 1 Token pro Durchlauf (Sequential)          |
|  - Compute Bound (TFLOPS, Tensor Cores)             - Memory Bandwidth Bound (GB/s VRAM)          |
|  - Skaliert mit GPU-Kernen                          - Formel: Max t/s = Speicherbandbreite / VRAM |
|                                                                                                   |
|  Beispiel 70B Modell in Q4_K_M (~43 GB VRAM):                                                     |
|  * 1x RTX 3090 (936 GB/s)      -> Theoretisch: 936 / 43 = 21.7 t/s  (Real: ~18-20 t/s)            |
|  * 1x Apple M2 Ultra (800 GB/s)-> Theoretisch: 800 / 43 = 18.6 t/s  (Real: ~16-18 t/s)            |
|  * DDR5-5600 Dual-Channel (89.6 GB/s) -> Theoretisch: 89.6 / 43 = 2.08 t/s (Real: ~1.5-1.8 t/s)  |
+---------------------------------------------------------------------------------------------------+
9.1 Budget-Tier (< 500 €/CHF): Einstieg und Machbarkeitsgrenzen
Im Preissegment unter 500 €/CHF ist Neuware für dedizierte LLM-Workstations unrentabel. Ziel in dieser Kategorie ist es, ein System mit mindestens 12 GB bis 16 GB adressierbarem Hochgeschwindigkeitsspeicher bereitzustellen, um Modelle im Bereich von 7B bis 14B Parametern vollständig ohne CPU-Offloading im VRAM auszuführen.
9.1.1 Gebraucht-Workstation mit NVIDIA GeForce RTX 3060 12GB
Die NVIDIA GeForce RTX 3060 12GB (Ampere GA106, 3584 CUDA-Kerne, 192-Bit GDDR6, 360 GB/s) ist die kostengünstigste Option für hardwarebeschleunigte Inferenz mit FP16/INT4-Tensorkernen und vollständiger CUDA/vLLM/Ollama-Kompatibilität.
Typische Plattformen (Refurbished / Gebrauchtmarkt)
- Dell OptiPlex 7050 / 7060 / 5070 MT (Mini Tower): Ausgestattet mit Intel Core i7-7700 oder i7-8700, 16–32 GB DDR4 RAM. Anschaffungskosten: ca. 120–180 €.
- HP Z440 Workstation: Intel Xeon E5-1650 v3 / E5-2678 v3 (LGA2011-3), Quad-Channel DDR4, 700W Netzteil (80+ Gold). Anschaffungskosten: ca. 140–200 €.
- GPU-Zukauf: NVIDIA RTX 3060 12GB (Gebrauchtmarkt ca. 220–250 €).
+---------------------------------------------------------------------------------------------------+
|                         ARCHITEKTUR: REFURBISHED WORKSTATION + RTX 3060 12GB                      |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|   +-------------------------------------------------------------------------------------------+   |
|   | HP Z440 Mainboard (Intel C612 Chipsatz / LGA2011-3)                                       |   |
|   |  - CPU: Intel Xeon E5-1650 v4 (6 Kerne / 12 Threads @ 3.6 GHz)                            |   |
|   |  - RAM: 64 GB (4x 16 GB) DDR4-2400 ECC Registered (Quad-Channel: ~76.8 GB/s)              |   |
|   +-------------------------------------------------------------------------------------------+   |
|                                       | PCIe 3.0 x16 (15.75 GB/s)                                 |
|                                       v                                                           |
|   +-------------------------------------------------------------------------------------------+   |
|   | NVIDIA GeForce RTX 3060 12 GB GDDR6                                                       |   |
|   |  - Speicherbandbreite: 360 GB/s (192-Bit Bus)                                             |   |
|   |  - TGP: 170 Watt (1x 8-Pin PCIe Stromversorgung)                                          |   |
|   |  - CUDA Compute Capability: 8.6                                                           |   |
|   +-------------------------------------------------------------------------------------------+   |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
Wichtige Hardware-Fallstricke bei OEM-Rechnern
- Netzteil-Proprietäten: Dell OptiPlex MT-Gehäuse verwenden herstellerspezifische 6-Pin- oder 8-Pin-Mainboard-Stromanschlüsse sowie Netzteile mit lediglich 240W–290W ohne 8-Pin-PCIe-Stromstecker. Für den Einbau einer RTX 3060 (170W TGP) ist ein ATX-Netzteil (ab 500W) nebst 24-Pin-auf-6/8-Pin-Adapterkabel erforderlich. HP Z440 Systeme bringen ab Werk ein standardmäßiges 700W-Netzteil mit 2x 6-Pin PCIe mit, welches per 6-Pin-auf-8-Pin-Adapter sofort nutzbar ist.
- PCIe-Slot-Dimensionen: Viele Small-Form-Factor-Gehäuse (SFF) fassen nur Low-Profile-Karten mit einer Slotbreite. Es muss zwingend die Tower-Variante (MT) beschafft werden.
9.1.2 Alternative: Apple Mac Mini M2 (16 GB Unified Memory)
Gebrauchte Mac Mini M2 mit 16 GB Unified Memory (ca. 450–520 €) bieten eine extrem energieeffiziente Alternative (15–30W Leistungsaufnahme unter Volllast). Die Speicherbandbreite des Basis-M2 beträgt 100 GB/s über einen 128-Bit-LPDDR5-Bus.
+---------------------------------------------------------------------------------------------------+
|                        APPLE UNIFIED MEMORY ARCHITEKTUR (MAC MINI M2 16GB)                        |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|   +-------------------------------------------------------------------------------------------+   |
|   | Apple M2 SoC                                                                              |   |
|   |  - 8-Core CPU / 10-Core GPU / 16-Core Neural Engine                                       |   |
|   |  - Metal 3 API / MPS Acceleration                                                         |   |
|   +-------------------------------------------------------------------------------------------+   |
|                                       ^                                                           |
|                                       | 128-Bit Unified Memory Bus (100 GB/s)                     |
|                                       v                                                           |
|   +-------------------------------------------------------------------------------------------+   |
|   | 16 GB LPDDR5-6400 Unified Memory (Geteilt für OS, Display, CPU und GPU-Buffer)            |   |
|   |  - Max. allozierbarer GPU-Speicher (sysctl iogpu.wired_mem_limit): ~11.5 - 12.8 GB         |   |
|   +-------------------------------------------------------------------------------------------+   |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
[Warnung]
Auf Apple Silicon reserviert macOS standardmäßig ca. 25 % des RAMs für System- und Grafikfunktionen. Bei 16 GB Gesamtspeicher stehen der Metal-Engine für Inferenz standardmäßig maximal 11,5 GB zur Verfügung. Mittels sudo sysctl iogpu.wired_mem_limit=13800 lässt sich dieser Grenzwert auf ca. 13,8 GB anheben, was jedoch das Risiko von Out-of-Memory-Panics (OOM) bei parallelen Desktop-Anwendungen erhöht.
9.1.3 Modellgrenzen und Durchsatz im Budget-Tier
| Modell | Parameter | Quantisierung | VRAM-Bedarf (Modell + 4k KV) | Plattform: RTX 3060 12GB (360 GB/s) | Plattform: Mac Mini M2 16GB (100 GB/s) |
|---|---|---|---|---|---|
| Qwen 2.5 | 7.6B | Q4_K_M | ~5.2 GB | 58.4 t/s | 16.8 t/s |
| Qwen 2.5 | 7.6B | Q8_0 / FP16 | ~8.4 GB / 15.5 GB | 37.1 t/s (Q8) / OOM (FP16) | 10.9 t/s (Q8) / OOM |
| Llama 3.1 | 8.0B | Q4_K_M | ~5.6 GB | 54.2 t/s | 15.2 t/s |
| Llama 3.1 | 8.0B | Q8_0 | ~8.9 GB | 34.8 t/s | 9.8 t/s |
| Qwen 2.5 | 14.7B | Q4_K_M | ~9.8 GB | 31.5 t/s | 8.7 t/s |
| Qwen 2.5 | 14.7B | Q5_K_M | ~11.4 GB | 26.2 t/s (Knapp am Limit) | OOM (Swap-Drossel ~1.2 t/s) |
| Gemma 2 | 9.2B | Q4_K_M | ~6.4 GB | 48.0 t/s | 13.5 t/s |
| Whisper | large-v3-turbo | FP16 | ~3.1 GB | ~8x Realtime | ~3.5x Realtime |
9.2 Mid-Tier (1.000 – 2.500 €/CHF): Die Dual-GPU- und High-Bandwidth-Klasse
Das Mid-Tier-Segment stellt den Sweet Spot für anspruchsvolles Prototyping und lokale Entwicklung dar. Ziel ist die verzögerungsfreie Ausführung von 32B-Modellen in voller Präzision bzw. 70B-Modellen in praxistauglichen 4-Bit-Quantisierungen mit einer Mindestgeschwindigkeit von 15 bis 25 t/s.
Hier existieren zwei fundamentale Architekturentwürfe:
- Neubau Single-GPU: Moderne Ada-Lovelace-Architektur mit hoher Energieeffizienz und nativer FP8-Tensor-Core-Unterstützung (RTX 4070 Ti Super 16GB oder RTX 4080 Super 16GB).
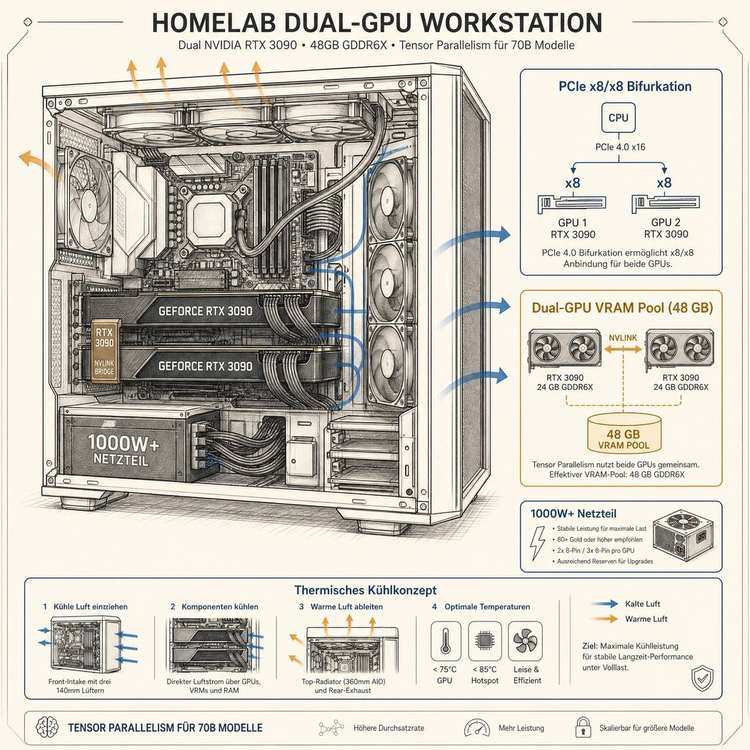
- Dual-GPU Gebraucht-Workstation: 2x NVIDIA GeForce RTX 3090 24GB = 48 GB VRAM bei kombinierter Bandbreite via Tensor-Parallelismus.
+---------------------------------------------------------------------------------------------------+
|                        VERGLEICH: SINGLE MODERN GPU VS. DUAL VRAM WORKSTATION                     |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|  VARIANTE A: Single RTX 4080 Super (16 GB)         VARIANTE B: Dual RTX 3090 (48 GB Total)        |
|  +---------------------------------------+         +---------------------------------------+      |
|  | VRAM: 16 GB GDDR6X (736 GB/s)         |         | GPU 0: 24 GB GDDR6X (936 GB/s)        |      |
|  | Max Model: Qwen 2.5-Coder 14B Q8/FP16 |         | GPU 1: 24 GB GDDR6X (936 GB/s)        |      |
|  | TDP: 320 Watt                         |         | Total VRAM: 48 GB                     |      |
|  | FP8 Transformer Engine: JA            |         | Max Model: Llama 3.3 70B Q4_K_M       |      |
|  | Schnittstelle: PCIe 4.0 x16           |         | TDP: 2x 350W = 700 Watt               |      |
|  +---------------------------------------+         | PCIe: x8 / x8 Bifurcation nötig       |      |
|                                                    +---------------------------------------+      |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
9.2.1 Das 48-GB-Dual-GPU-Rig (2x RTX 3090 24GB)
Zwei GeForce RTX 3090 bieten zusammen 48 GB GDDR6X-Videospeicher bei einer Einzelbandbreite von 936 GB/s pro Karte. Dies ermöglicht die vollständig im VRAM residierende Inferenz von:
- Llama 3.3 70B (Q4_K_M: ~43 GB VRAM inkl. 8k Context)
- DeepSeek-R1-Distill-Llama-70B (Q4_K_M: ~43 GB VRAM)
- Qwen 2.5-Coder 32B (Q8_0 oder FP8: ~35 GB VRAM bei 32k Context)
- Command R+ 104B (IQ2_XS / IQ3_S quantisiert)
Mainboard- und PCIe-Bifurcation-Anforderungen
Die Installation zweier 3-Slot-Grafikkarten mit hoher Leistungsaufnahme scheitert auf Standard-Consumer-Mainboards häufig an der physischen Slot-Platzierung und der PCIe-Lane-Verteilung.
+---------------------------------------------------------------------------------------------------+
|                        PCIe BIFURCATION TOPOLOGIE (AMD X670E / PROART)                            |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|                              +----------------------------------+                                 |
|                              |      AMD Ryzen 9 7900 / 9900X    |                                 |
|                              |        (28 PCIe 5.0 Lanes)       |                                 |
|                              +----------------------------------+                                 |
|                                   |                        |                                      |
|                 PCIe 4.0 x8 (15.75 GB/s)          PCIe 4.0 x8 (15.75 GB/s)                        |
|                                   |                        |                                      |
|                                   v                        v                                      |
|                          +-----------------+      +-----------------+                             |
|                          | PCIe Slot 1:    |      | PCIe Slot 2:    |                             |
|                          | RTX 3090 #1     |      | RTX 3090 #2     |                             |
|                          | (x16 mechanisch,|      | (x16 mechanisch,|                             |
|                          |  x8 elektrisch) |      |  x8 elektrisch) |                             |
|                          +-----------------+      +-----------------+                             |
|                                                                                                   |
|  Slot-Abstand erforderlich: Mindestens 3 bis 4 Slots Abstand (Triple-Slot Cooler Dicke ~60 mm)    |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
Empfohlene Mainboards für Dual-GPU-Betrieb ohne Lane-Engpässe:
- ASUS ProArt X670E-Creator WIFI: Unterstützt echtes $x8/x8$-Splitting der CPU-Lanes auf PCIe-Slot 1 und 2 mit 3 Slots Abstand dazwischen.
- MSI MEG X570 Unify / ASUS WS X570-ACE: Ältere AM4-Plattformen für Budget-Builds mit PCIe 4.0 $x8/x8$.
- ASRock WRX80 Creator / Gigabyte MZ32 (Workstation/Server): Volle 128 PCIe-Lanes für uneingeschränkten $x16/x16$-Betrieb.
+---------------------------------------------------------------------------------------------------+
|                           VOLLSTÄNDIGE MID-TIER DUAL-GPU STÜCKLISTE (BOM)                         |
+---------------------------------------------------------------------------------------------------+
| Komponente               | Modell / Spezifikation                             | Preis (ca.)       |
+--------------------------+----------------------------------------------------+-------------------+
| Prozessor (CPU)          | AMD Ryzen 9 7900 (12 Kerne, 65W TDP)               | 340 € / CHF       |
| CPU-Kühler               | Thermalright Peerless Assassin 120 SE              | 40 € / CHF        |
| Mainboard                | ASUS ProArt X670E-Creator WIFI (PCIe x8/x8 Switch) | 460 € / CHF       |
| Arbeitsspeicher (RAM)    | 64 GB (2x 32 GB) DDR5-6000 CL30 EXPO               | 210 € / CHF       |
| Grafikkarte 1 (GPU 1)    | NVIDIA GeForce RTX 3090 24GB (Gebrauchtmarkt)      | 680 € / CHF       |
| Grafikkarte 2 (GPU 2)    | NVIDIA GeForce RTX 3090 24GB (Gebrauchtmarkt)      | 680 € / CHF       |
| Festplatte (NVMe SSD)    | 2 TB Samsung 990 Pro PCIe 4.0 (7450 MB/s Read)     | 160 € / CHF       |
| Netzteil (PSU)           | Seasonic Vertex GX-1200 (1200W ATX 3.0, 80+ Gold)  | 220 € / CHF       |
| Gehäuse                  | Fractal Design Torrent (Optimaler Airflow)         | 180 € / CHF       |
+--------------------------+----------------------------------------------------+-------------------+
| GESAMTSUMME              |                                                    | 2.970 € / CHF     |
| (Sparpotential mit AM4 / Gebraucht-Plattform: ~2.350 € / CHF)                                      |
+---------------------------------------------------------------------------------------------------+
[Praxis-Tipp]
Verzichten Sie bei Dual-RTX-3090-Setups auf eine NVLink-Bridge, sofern Sie Inferenz via llama.cpp oder vLLM betreiben. Moderne Inferenz-Engines nutzen optimierte P2P-Transfers über PCIe 4.0 $x8$ (~15.75 GB/s Vollduplex). Der Durchsatzverlust gegenüber NVLink (112.5 GB/s) liegt bei der autoregressiven Generierung unter 5 %, da der Transferaufwand für Zwischenschichten bei Batch Size 1 im Mikrosekundenbereich liegt.
9.3 High-End Enthusiast (3.000 – 7.000+ €/CHF): Riesenmodelle und Multi-GPU-Inferenz
Für Entwickler und Forscher, die Modelle jenseits der 70B-Klasse (z.B. DeepSeek-V3 671B MoE, Llama 3.3 70B in FP16/Q8, Qwen 2.5 72B FP16, Mistral Large 2 123B) lokal ausführen möchten, spaltet sich das High-End-Segment in zwei fundamental unterschiedliche Architekturansätze:
- Apple Silicon Unified Memory (Mac Studio M2/M4 Ultra): Gewaltiger, zusammenhängender Adressraum (bis 192 GB / 512 GB) bei mittlerer Bandbreite (800 GB/s) und extrem kompaktem Formfaktor bei minimaler Lautstärke.
- Dediziertes Quad-GPU x86-Rack/Tower: Vier GPUs (4x RTX 3090/4090 = 96 GB VRAM) mit bis zu 4.032 GB/s aggregierter Bandbreite, jedoch massivem Leistungsaufnahme- und Kühlungsaufwand.
+---------------------------------------------------------------------------------------------------+
|                     ARCHITEKTURVERGLEICH: APPLE SILICON VS. QUAD-GPU TOWER                        |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|   APPLE MAC STUDIO M2 ULTRA (192 GB)                  QUAD-GPU RIG (4x RTX 3090 96 GB)            |
|   +-------------------------------------------+       +-----------------------------------------+ |
|   | SoC: 24-Core CPU / 76-Core GPU            |       | CPU: AMD EPYC 7002/7003 / Threadripper  | |
|   | RAM: 192 GB Unified Memory                |       | RAM: 128-256 GB DDR4/DDR5 ECC           | |
|   | Bandbreite: 800 GB/s                      |       | GPUs: 4x RTX 3090 24GB (96 GB Total)    | |
|   | Max VRAM Zuweisung: ~148 - 160 GB         |       | Bandbreite: 4x 936 GB/s = 3.744 GB/s    | |
|   | Idle Leistungsaufnahme: 15 Watt           |       | Idle Leistungsaufnahme: 120 Watt        | |
|   | Last Leistungsaufnahme: 220 Watt          |       | Last Leistungsaufnahme: 1.450 Watt      | |
|   | Lautstärke: 15 - 22 dB(A) (Lautlos)       |       | Lautstärke: 45 - 65 dB(A) (Serverpegel) | |
|   | Software: llama.cpp / MLX / Ollama Metal  |       | Software: vLLM / TensorRT-LLM / SGLang  | |
|   +-------------------------------------------+       +-----------------------------------------+ |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
9.3.1 Performance- und Skalierungsvergleich bei Großmodellen
| Modell | Parameter | Quantisierung | VRAM-Bedarf | Mac Studio M2 Ultra (192 GB) | Quad-GPU Rig (4x RTX 3090 96 GB) |
|---|---|---|---|---|---|
| Llama 3.3 | 70B | Q4_K_M | ~43 GB | 17.8 t/s | 34.2 t/s (TP=4 via vLLM) |
| Llama 3.3 | 70B | Q8_0 | ~75 GB | 10.4 t/s | 19.5 t/s (TP=4 via vLLM) |
| Qwen 2.5 | 72B | FP8 | ~76 GB | 10.1 t/s (via MLX) | 22.0 t/s (vLLM FP8 Native) |
| Mistral Large 2 | 123B | Q4_K_M | ~74 GB | 9.8 t/s | 18.2 t/s (TP=4) |
| DeepSeek-V3 (MoE) | 671B (37B active) | Q2_K / IQ2_XXS | ~150 GB | 4.8 t/s | Nicht ladbar (OOM, benötigt 8x GPU) |
| Flux.1 Dev (Image) | 12B DiT | FP16 / FP8 | ~24 GB | ~12 s pro Bild (20 Steps) | ~2.4 s pro Bild (20 Steps) |
[Deep Dive]
MoE-Inferenz auf Apple Silicon vs. Dense-Modelle:
Mixture-of-Experts (MoE) Architekturen wie DeepSeek-V3 oder Mixtral 8x22B profitieren überproportional von Unified-Memory-Systemen mit hoher Kapazität. Da pro Token nur ein Bruchteil der Gesamtexperten aktiv ist (z.B. 37B von 671B bei DeepSeek-V3), muss trotz des gigantischen Speicherbedarfs im VRAM nur ein kleiner Teil der Gewichte pro Generierungsschritt transferiert werden. Apple Silicon Systeme mit 128 GB oder 192 GB RAM können MoE-Modelle hosten, die auf GPU-Clustern aufgrund von VRAM-Mangel scheitern würden.
9.4 Physische Infrastruktur: Thermodynamik, Elektrik und Akustik
Der Betrieb von Hochleistungs-GPUs im Heimbereich oder im Büro unterliegt strikten physikalischen Grenzen. Das Nichtbeachten von Wärmeabfuhr, Absicherung und Geräuschentwicklung führt unweigerlich zu thermischem Throttling, Hardwaredefekten oder untragbaren Arbeitsbedingungen.
+---------------------------------------------------------------------------------------------------+
|                              THERMISCHES & ELEKTRISCHES HOMELAB-BUDGET                            |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|  230V / 16A Stromkreis (Haushalt DE/AT/CH)                                                        |
|  Theoretisches Maximum: 230 V * 16 A = 3.680 Watt                                                 |
|  Dauerlastgrenze (80%-Regel nach DIN VDE 0100): 2.944 Watt                                       |
|                                                                                                   |
|  +---------------------------------------------------------------------------------------------+  |
|  | RIG-LEISTUNGSAUFNAHME (4x RTX 3090 UNTER VOLLLAST):                                         |  |
|  | - 4x GPUs @ 350W TDP:              1.400 Watt                                               |  |
|  | - CPU (AMD EPYC / Threadripper):     280 Watt                                               |  |
|  | - Mainboard, RAM, NVMe, Lüfter:      120 Watt                                               |  |
|  | - Netzteil-Verlustleistung (80+ Pl.): 180 Watt                                               |  |
|  | --------------------------------------------------                                          |  |
|  | SYSTEM-GESAMTLEISTUNG:             1.980 Watt (Elektrische Dauerlast = 1.980 Watt Abwärme)  |  |
|  +---------------------------------------------------------------------------------------------+  |
|                                                                                                   |
|  Raumerwärmungsrechnung (Geschlossener Raum, 15 m², 2.5 m Höhe = 37.5 m³ Luftvolumen):             |
|  - Wärmekapazität Luft ($c_p$): ~1.2 kJ/(m³·K)                                                    |
|  - Gesamtwärmekapazität Raumluft: 45 kJ/K                                                         |
|  - Bei 1.980 W Netto-Wärmeeintrag ($1.980 \text{ J/s} = 7.128 \text{ kJ/h}$):                     |
|    -> Temperaturanstieg ohne Klimatisierung/Lüftung: **ca. 158 °C pro Stunde (theoretisch)**      |
|    -> Realer Temperaturanstieg (inkl. Wände/Möbel): **+4 °C bis +8 °C pro Stunde Inferenz**      |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
9.4.1 Elektrische Absicherung und Leitungsdimensionierung
- Einschaltströme (Inrush Current): Große Schaltnetzteile (1200W–2000W) erzeugen beim Laden der Primärkondensatoren massive Einschaltstromspitzen. Herkömmliche Leitungsschutzschalter der Charakteristik B16 lösen hierbei häufig fehlerhaft aus.
- Maßnahme: Umrüstung auf Leitungsschutzschalter mit Trägercharakteristik (C16) durch eine Elektrofachkraft oder Einsatz eines NTC-Einschaltstrombegrenzers.
- Phasentrennung bei Multi-PSU: Werden in einem Quad-GPU-System zwei getrennte 1000W-Netzteile betrieben, sollten diese idealerweise an denselben Stromkreis angeschlossen werden, um Potenzialverschleppungen über das gemeinsame Massepotenzial der PCIe-Ground-Lanes zu vermeiden.
9.4.2 Akustik- und Kühlungsmanagement
Die Kühlung von Multi-GPU-Systemen erzwingt je nach Gehäusetyp unterschiedliche Lüfterkonzepte.
+---------------------------------------------------------------------------------------------------+
|                             LÜFTERTYPEN: AXIAL VS. RADIAL (BLOWER)                                |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|   AXIAL-LÜFTER (Consumer-Karten)                      RADIAL- / BLOWER-LÜFTER (Server/Workstation)|
|   +---------------------------------------+           +-----------------------------------------+ |
|   | Wirbelt Luft IM Gehäuse auf           |           | Saugt Luft an und drückt sie direkt     | |
|   | Benötigt massiven Gehäuse-Airflow     |           | HINTEN aus dem Slotblech heraus         | |
|   | Bei Stacked-Slots: Obere GPU erstickt |           | Ideal für dichte Multi-GPU-Setups       | |
|   | Lautstärke: 32 - 42 dB(A)             |           | Lautstärke: 55 - 72 dB(A) (Föhnpegel)   | |
|   +---------------------------------------+           +-----------------------------------------+ |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
Schallpegelmatrix und Einsatzort
| Systemkonfiguration | Kühlungstyp | Leerlauf (Idle) | Volllast Inferenz | Geeigneter Standort |
|---|---|---|---|---|
| Mac Studio M2 Ultra | Integrierter Radiallüfter | 15 dB(A) | 22 dB(A) | Schreibtisch / Wohnbereich |
| Single RTX 4080 Super Tower | 3x 140mm Axial-Gehäuselüfter | 24 dB(A) | 34 dB(A) | Arbeitszimmer unterm Tisch |
| Dual RTX 3090 Tower | Gehäuse offen + 6x Noctua A12x25 | 30 dB(A) | 46 dB(A) | Arbeitszimmer (mit Headset) |
| Quad RTX 3090 Rig (Axial) | Mining-Frame / Open Air | 38 dB(A) | 58 dB(A) | Keller / Abstellraum |
| Quad RTX 4090 (Blower) | 4U Rackmount Server Chassis | 52 dB(A) | 74 dB(A) | Dedizierter Serverraum |
[Warnung]
Betreiben Sie niemals Blower-GPU-Server oder offene Multi-GPU-Mining-Rigs im regulären Wohn- oder Schlafbereich. Ein Dauerschallpegel von über 65 dB(A) führt zu messbaren kognitiven Leistungseinbußen und Gehörschäden. Bei unzureichender Raumklimatisierung im geschlossenen Homelab-Raum steigen die GPU-Hotspot-Temperaturen bei Dauerlast auf über 105 °C an, was zur thermischen Notabschaltung (Thermal Shutdown) führt.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.