KMU-Einsatzszenarien
Inhouse-Architekturen für kleine Teams.
Inhouse-Architekturen für kleine Teams. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
Kapitel 10: KMU-Einsatzszenarien: Dimensionierung, Hardware-Architektur & ROI-Kalkulation
Kleine und mittlere Unternehmen (KMU) mit 5 bis 50 wissensintensiven Arbeitsplätzen stehen bei der Einführung von generativer KI vor anderen Randbedingungen als Großkonzerne oder Heimanwender. Während Konzerne über spezialisierte MLOps-Abteilungen verfügen und Heimanwender Kompromisse bei Latenz und Ausfallsicherheit akzeptieren, fordern KMU deterministische Verfügbarkeit, minimale Total Cost of Ownership (TCO), vollständige Konformität mit der DSGVO bzw. dem Schweizer Datenschutzgesetz (DSG) und eine nahtlose Integration in bestehende IT-Landschaften.
10.1 Konkrete KMU-Einsatzszenarien (5–20 Wissensarbeiter)
Die Wirtschaftlichkeit lokaler Inferenzsysteme im KMU-Umfeld wird primär durch vier hochgradig repetitive Anwendungsfälle getrieben, bei denen proprietäre Unternehmensdaten das Firmennetzwerk aus rechtlichen oder strategischen Gründen nicht verlassen dürfen.
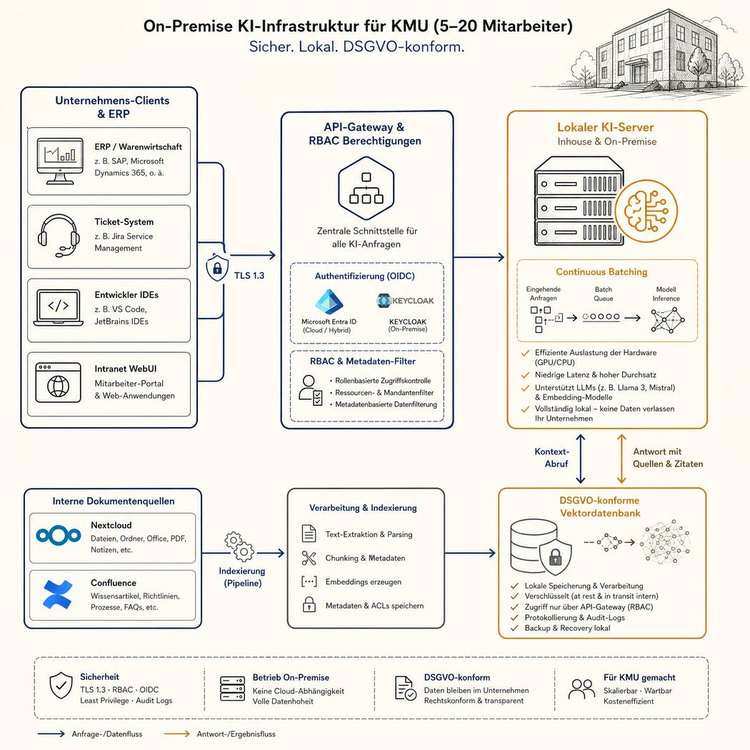
+---------------------------------------------------------------------------------------------------+
|                               KMU-INFERENZ ARCHITEKTUR-ÜBERSICHT                                  |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|   +-------------------------------------------------------------------------------------------+   |
|   | INTERNE CLIENTS & QUELLEN                                                                 |   |
|   |  - ERP (SelectLine / SAP Business One)        - DMS / Nextcloud / SharePoint              |   |
|   |  - Ticket-System (Zammad / Jira)             - Entwickler-IDEs (VS Code / Cursor / Continue) |   |
|   +-------------------------------------------------------------------------------------------+   |
|                                       | (HTTPS / REST API / OpenAI Standard)                     |
|                                       v                                                           |
|   +-------------------------------------------------------------------------------------------+   |
|   | API-GATEWAY & RBAC-LAYER (Traefik / LiteLLM Proxy)                                        |   |
|   |  - Authentifizierung via Microsoft Entra ID / Keycloak OIDC                               |   |
|   |  - Token-Budgetierung, Rate-Limiting & Audit-Logging                                      |   |
|   +-------------------------------------------------------------------------------------------+   |
|                                       |                                                           |
|             +-------------------------+-------------------------+                                 |
|             |                                                   |                                 |
|             v                                                   v                                 |
|   +-----------------------------------+       +-----------------------------------+               |
|   | RAG- & PIPELINE-SERVICES          |       | INFERENZ-CLUSTER (vLLM / Triton)  |               |
|   |  - Qdrant / pgvector              | ----> |  - Qwen 2.5 72B-Instruct (Allg.)  |               |
|   |  - BGE-M3 Embeddings              |       |  - Qwen 2.5-Coder 32B (Entwickl.) |               |
|   |  - Berichtigungs-Filter (ACLs)    |       |  - Whisper large-v3 (Transkript)  |               |
|   +-----------------------------------+       +-----------------------------------+               |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
10.1.1 DSGVO-konforme Mandanten- und Kundendatenanalyse
- Branche: Anwaltskanzleien, Treuhänder, Steuerberater, medizinische Versorgungszentren (MVZ).
- Anforderung: Vollständige Verarbeitung von personenbezogenen Daten besonderer Kategorien (Art. 9 DSGVO / Art. 5 DSG). Jeglicher Transfer über US-amerikanische Hyperscaler-APIs ist ohne aufwendige Transfer Impact Assessments (TIA) und Standardvertragsklauseln (SCC) haftungsrechtlich riskant.
- Workload: Dokumentenextraktion, Vertragsprüfung, Bilanzanalysen, forensische E-Mail-Auswertung.
10.1.2 Interner Wissens-Assistent (RAG über heterogene Datenspeicher)
- Datenquellen: Confluence, Microsoft SharePoint, Nextcloud, SMB-Netzlaufwerke, Ticketarchive.
- Architektur-Anforderung: Hybride Suche (Dichte Vektoren via
BAAI/bge-m3+ Sparse BM25) kombiniert mit striktem Berechtigungsabgleich auf Dokumentenebene (siehe Kapitel 11).
10.1.3 Ticket-Klassifizierung und First-Level-Drafting
- Integration: REST-Webhook-Anbindung an Ticketsysteme (z.B. Zammad, OTRS, Zendesk).
- Ablauf: Eingehende Kundenanfragen werden in unter 2 Sekunden analysiert, mit Metadaten (Dringlichkeit, Kategorie, Sentiment) angereichert, und es wird ein formulierungssicherer Antwortentwurf auf Basis interner Wissensartikel generiert.
10.1.4 Lokale Coding-Assistenz
- Integration: Continue.dev Plugin für VS Code / JetBrains oder Cursor-Konfiguration auf interne Endpunkte.
- Modellwahl: Qwen 2.5-Coder 32B-Instruct (oder 72B). Bietet Code-Generierung und Refactoring auf dem Niveau proprietärer Closed-Source-Modelle, ohne proprietäre Quellcodes auf externe Server zu spiegeln.
10.2 Sizing, Concurrency & SLA-Berechnung
Die Dimensionierung eines KMU-Inferenzservers basiert auf stochastischer Lastverteilung. Bei 20 Mitarbeitern generieren nicht alle Nutzer simultan Tokens.
+---------------------------------------------------------------------------------------------------+
|                       QUEUING VS. CONTINUOUS BATCHING BEI MULTI-USER LAST                         |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|  SEQUENTIELLES QUEUING (z.B. einfaches llama.cpp ohne Continuous Batching):                       |
|  Request A: [Prefill A][----------------- Decoding A -----------------]                          |
|  Request B:                                                            [Prefill B][--- Dec B ---] |
|  * Problem: Request B muss warten, bis Request A vollständig beendet ist. Hohe TTFT-Spitzen.       |
|                                                                                                   |
|  ITERATION-LEVEL CONTINUOUS BATCHING (vLLM / TensorRT-LLM):                                       |
|  Step N:   [Decode A] + [Decode B] + [Prefill C (Chunked)]                                        |
|  Step N+1: [Decode A] + [Decode B] + [Decode C]                                                   |
|  Step N+2: [Done A  ] + [Decode B] + [Decode C] + [Prefill D]                                     |
|  * Vorteil: GPU-Speicherbandbreite wird optimal genutzt; Token-Durchsatz steigt linear mit Batch.  |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
10.2.1 Mathematische Modellierung der Last
Gegeben:
- Mitarbeiteranzahl: $N = 20$
- Durchschnittliche Interaktionen pro Mitarbeiter/Stunde: $I = 12$
- Durchschnittliche Prompt-Länge: $L_{\text{prompt}} = 1.200 \text{ Tokens}$
- Durchschnittliche Generierungs-Länge: $L_{\text{gen}} = 350 \text{ Tokens}$
Daraus ergibt sich die mittlere Anfragerate $\lambda$:
$$\lambda = \frac{N \times I}{3600 \text{ s}} = \frac{20 \times 12}{3600} = 0.067 \text{ Anfragen pro Sekunde (Req/s)}$$
Unter Annahme einer Poisson-Verteilung für eintreffende Anfragen und einer Sicherheitsmarge für Lastspitzen (Peak-to-Average-Ratio $\approx 4$) berechnet sich die Auslegungslast $\lambda_{\text{peak}}$:
$$\lambda_{\text{peak}} = 0.067 \times 4 \approx 0.27 \text{ Req/s} \quad (\approx 1 \text{ Anfrage alle 3.7 Sekunden})$$
Bei einer typischen Verweildauer (Service Time) von $t_{\text{service}} = \frac{L_{\text{gen}}}{\text{Tokenrate pro Stream}}$ ($350 \text{ Tokens} / 30 \text{ t/s} \approx 11.6 \text{ s}$) beträgt die durchschnittliche Anzahl paralleler aktiver Generationen im Spitzenbetrieb ($C_{\text{peak}}$) nach Little's Gesetz:
$$C_{\text{peak}} = \lambda_{\text{peak}} \times t_{\text{service}} = 0.27 \text{ Req/s} \times 11.6 \text{ s} \approx 3.13 \text{ parallele Streams}$$
Das System muss somit für 3 bis 5 gleichzeitig aktive Generierungs-Streams ausgelegt werden, ohne dass die Service Level Agreements (SLAs) verletzt werden.
10.2.2 Service Level Agreements (SLAs) und Latenzbudgets
+---------------------------------------------------------------------------------------------------+
|                                  KMU-LATENZBUDGET DEFINITION                                      |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|  [ REQUEST START ]                                                                                |
|         |                                                                                         |
|         +--> 1. Netzwerk- & Proxy-Routing (Traefik + LiteLLM):         < 50 ms                    |
|         +--> 2. RAG-Vektorsuche & ACL-Validierung (Qdrant + BM25):     < 250 ms                   |
|         +--> 3. Time-to-First-Token (TTFT) Inferenz-Engine:             < 1.200 ms                 |
|         |    ------------------------------------------------------------------                   |
|         |    TOTAL ZEIT BIS ZUM ERSTEN ZEICHEN:                        < 1.500 ms (1.5 s)         |
|         |                                                                                         |
|         +--> 4. Autoregressive Generierung (Streaming Output):         > 25 Tokens/s pro Nutzer   |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
10.3 Hardware-Architektur für KMU-Inferenzserver
Für einen verlässlichen 24/7-Betrieb scheiden Consumer-Desktop-Gehäuse aus. Der Standard im KMU-Umfeld sind 19-Zoll-Rackmount-Server (2U bis 4U) mit redundanter Stromversorgung, ECC-Arbeitsspeicher und IPMI/BMC-Fernwartung.
+---------------------------------------------------------------------------------------------------+
|                          4U KMU-INFERENZSERVER ARCHITEKTUR (AMD EPYC + ADA)                       |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|   +-------------------------------------------------------------------------------------------+   |
|   | AMD EPYC 9354P (32 Kerne, 64 Threads, 256MB L3-Cache, 128 PCIe 5.0 Lanes)                |   |
|   +-------------------------------------------------------------------------------------------+   |
|                                 |                                                                 |
|             +-------------------+-------------------+                                             |
|             | 12-Kanal DDR5-4800 ECC (Total 384 GB) | Bandbreite: 460 GB/s                        |
|             +---------------------------------------+                                             |
|                                 |                                                                 |
|   +-----------------------------+-----------------------------+                                   |
|   | 128 PCIe 5.0 Lanes Switchless Root Complex                |                                   |
|   +-----------------------------------------------------------+                                   |
|        | PCIe 4.0 x16              | PCIe 4.0 x16              | PCIe 5.0 x4                      |
|        v                           v                           v                                  |
|   +-----------------------+   +-----------------------+   +-----------------------+               |
|   | GPU 0:                |   | GPU 1:                |   | Storage:              |               |
|   | NVIDIA RTX 6000 Ada   |   | NVIDIA RTX 6000 Ada   |   | 2x 3.84 TB NVMe       |               |
|   | 48 GB GDDR6 ECC       |   | 48 GB GDDR6 ECC       |   | Enterprise (RAID 1)   |               |
|   | 960 GB/s Bandbreite   |   | 960 GB/s Bandbreite   |   | U.3 / PCIe 4.0        |               |
|   +-----------------------+   +-----------------------+   +-----------------------+               |
|                                                                                                   |
|   Netzteile: 2x 2000 Watt Redundant (1+1 Hot-Plug Titanium 80+)                                   |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
10.3.1 Professionelle GPU-Optionen im Vergleich
| GPU-Modell | VRAM & Typ | Speicherbandbreite | Formfaktor | FP8 Tensor TFLOPS (Sparsity) | TDP | Ungefährer Listenpreis |
|---|---|---|---|---|---|---|
| NVIDIA RTX 4090 (Blower) | 24 GB GDDR6X | 1.008 GB/s | 2-Slot Blower | 660 TFLOPS | 450W | ca. 2.100 € / CHF |
| NVIDIA RTX 6000 Ada | 48 GB GDDR6 ECC | 960 GB/s | 2-Slot Blower | 1.457 TFLOPS | 300W | ca. 8.200 € / CHF |
| NVIDIA L40S | 48 GB GDDR6 ECC | 864 GB/s | 2-Slot Passiv | 1.466 TFLOPS | 350W | ca. 9.500 € / CHF |
| NVIDIA A100 80GB PCIe | 80 GB HBM2e | 1.935 GB/s | 2-Slot Passiv | Kein FP8 (INT8: 624) | 300W | ca. 14.500 € / CHF |
[Architektur-Hinweis]
Die NVIDIA RTX 6000 Ada Generation ist für KMU die wirtschaftlichste Enterprise-Option. Im Gegensatz zu Consumer-GPUs (RTX 4090) bietet sie:
- Offizielle Rechenzentrumszulassung in den NVIDIA-EULA-Bestimmungen.
- Nativen ECC-Speicherschutz gegen Bit-Flips bei großen KV-Caches.
- Kompakten 2-Slot-Blower-Formfaktor für dichte Rack-Integration ohne thermisches Ersticken.
- 48 GB VRAM pro Karte, sodass bereits zwei GPUs (96 GB) für Llama 3.3 70B in FP8 oder Qwen 2.5 72B genügen.
10.3.2 Turnkey Appliances vs. Systemintegratoren
| Anbieter / Plattform | Typ | Typische Konfiguration | Vorteile | Nachteile |
|---|---|---|---|---|
| Dell PowerEdge R760xa | Enterprise Server | 2x Xeon Platinum + 4x L40S / RTX 6000 Ada | Weltweiter 4h-Mission-Critical-Support, iDRAC 9 | Sehr hohe Anschaffungskosten, proprietäre Ersatzteile |
| Supermicro GPU SuperServer (4U) | Whitebox Enterprise | Dual AMD EPYC + 4x RTX 6000 Ada | Maximale Flexibilität, Standardkomponenten, hervorragender Airflow | Support primär über Integrator |
| Lambda Labs Vector | AI Workstation/Server | AMD Threadripper Pro + 4x RTX 4090 / 6000 Ada | Vorinstallierter Lambda Stack (CUDA, PyTorch, vLLM schlüsselfertig) | US-Import, längere Lieferzeiten |
| Exxact Corporation | Custom HPC Server | EPYC 9004 + 2x–4x RTX 6000 Ada | Maßgeschneiderte Konfiguration, hervorragende Rack-Führung | Aufpreis gegenüber reinem Eigenbau |
10.4 Detaillierte ROI-Kalkulation über 3 Jahre (20 Mitarbeiter)
Die folgende Wirtschaftlichkeitsrechnung vergleicht den Betrieb eines On-Premise-Inferenzservers mit dem Bezug proprietärer Cloud-APIs (Azure OpenAI / OpenAI API / AWS Bedrock).
10.4.1 Basishypothesen der Modellrechnung
- Mitarbeiteranzahl: 20 Wissensarbeiter (Entwickler, Juristen, Sachbearbeiter).
- Nutzungsvolumen: 1,5 Millionen Tokens pro Mitarbeiter und Arbeitstag (kombiniert Input + Output, inklusive automatisierter RAG-Pipelines, Code-Completion und Ticketverarbeitung).
- Arbeitstage pro Jahr: 220 Tage.
- Token-Volumen pro Jahr (Unternehmen):
$$\text{Tokens/Jahr} = 20 \times 1.500.000 \times 220 = 6.600.000.000 \text{ Tokens (6.6 Milliarden Tokens)}$$ - Token-Splitting: 75 % Prompt-Tokens (Eingabe / RAG-Kontext), 25 % Completion-Tokens (Generierung).
- Prompt-Tokens/Jahr: 4,95 Milliarden Tokens.
- Completion-Tokens/Jahr: 1,65 Milliarden Tokens.
10.4.2 Option A: Cloud-API (Azure OpenAI / OpenAI GPT-4o bzw. Claude 3.5 Sonnet Äquivalent)
- Kosten Prompt-Tokens (Stand 2026 gemittelt): 2,50 $ / Million Tokens.
- Kosten Completion-Tokens (Stand 2026 gemittelt): 10,00 $ / Million Tokens.
$$\text{Jahreskosten Prompts} = 4.950 \times 2,50 \text{ $} = 12.375 \text{ $}$$
$$\text{Jahreskosten Completions} = 1.650 \times 10,00 \text{ $} = 16.500 \text{ $}$$
$$\text{Jahreskosten API-Nutzung} = 28.875 \text{ $} \quad (\approx 26.500 \text{ €})$$
- Cloud-Netzwerk-Egress, VPN-Tunnel & Addon-Dienste: ca. 1.500 € / Jahr.
- Gesamtkosten Cloud über 3 Jahre:
$$\text{TCO}_{\text{Cloud}} = 3 \times (26.500 + 1.500) = \mathbf{84.000 \text{ €}}$$
(Hinweis: Bei Einsatz von Reasoning-Modellen wie OpenAI o1/o3 mit hohem Tokenverbrauch steigen die Cloud-Kosten auf über 180.000 € über 3 Jahre).
10.4.3 Option B: On-Premise Enterprise Server (2x NVIDIA RTX 6000 Ada 48GB)
+---------------------------------------------------------------------------------------------------+
|                            ON-PREMISE TCO-AUFSTELLUNG (3 JAHRE BETRIEB)                           |
+---------------------------------------------------------------------------------------------------+
| Kostenposition                             | Detailberechnung                     | Summe (3 Jahre) |
+--------------------------------------------+--------------------------------------+-----------------+
| **Hardware-Anschaffung (CAPEX)**           |                                      |                 |
| - 4U Rack-Chassis + AMD EPYC 9354P         | Server-Barebone, 384 GB ECC DDR5     | 6.800 €         |
| - 2x NVIDIA RTX 6000 Ada 48GB              | 2x 8.200 €                           | 16.400 €        |
| - NVMe Storage (2x 3.84 TB Enterprise)     | PCIe 4.0 U.3 (RAID 1)                | 900 €           |
| - USV (Online-Dauerwandler 3000VA Rack)    | APC Smart-UPS On-Line                | 1.800 €         |
| **Betriebs- & Stromkosten (OPEX)**         |                                      |                 |
| - Stromverbrauch Server                    | Mittlere Last 650W, 24/7, 0.28 €/kWh | 4.773 €         |
|   ($0.65 \text{ kW} \times 8760 \text{ h} \times 3 \times 0.28$)                   |                 |
| - Klimatisierungsaufwand (PUE 1.3)         | $4.773 \text{ €} \times 0.3$         | 1.432 €         |
| **Wartung, Lizenzen & Administration**     |                                      |                 |
| - 3 Jahre 24/7 NBD Vor-Ort-Hardware-Garantie| Systemintegrator-Supportpaket        | 2.400 €         |
| - IT-Betreuungsaufwand (Setup & Updates)   | 40h Initial + 2h/Monat @ 110 €/h     | 12.320 €        |
+--------------------------------------------+--------------------------------------+-----------------+
| **GESAMT-TCO ON-PREMISE (3 JAHRE)**        |                                      | **46.825 €**    |
+--------------------------------------------+--------------------------------------+-----------------+
10.4.4 TCO-Vergleich und Break-Even-Analyse
+---------------------------------------------------------------------------------------------------+
|                             KUMULIERTE KOSTEN ENTWICKLUNG (36 MONATE)                             |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|   Kosten (€)                                                                                      |
|   90.000 +                                                            / Cloud API (84.000 €)      |
|   80.000 |                                                           /                            |
|   70.000 |                                                          /                             |
|   60.000 |                                                         /                              |
|   50.000 |                                                        /   On-Premise (46.825 €)       |
|   40.000 |  +----------------------------------------------------+------------------              |
|   30.000 | / Initial CAPEX (25.900 €)                           /                                 |
|   20.000 |/                                                    /                                  |
|   10.000 /  BREAK-EVEN NACH CA. 14 MONATEN                    /                                   |
|        0 +---------------------------------------------------+-------------------------> Zeit     |
|          0         6        12   14   18        24        30        36 (Monate)                   |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
Zusammenfassende ROI-Metriken
- Break-Even-Point: Nach 13,8 Monaten amortisiert sich die On-Premise-Investition vollständig.
- Nettokosteneinsparung über 3 Jahre: 37.175 € (Ersparnis von ca. 44,2 % gegenüber Cloud-APIs).
- Zusatzgewinn: Vollständige Unabhängigkeit von API-Ratensperren, kein Risiko von Preiserhöhungen durch Cloud-Anbieter, uneingeschränkte Datenschutzkonformität ohne Drittlandtransfer.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.