Betrieb & Sicherheit
RBAC, Monitoring, Backups und Rollouts.
RBAC, Monitoring, Backups und Rollouts. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
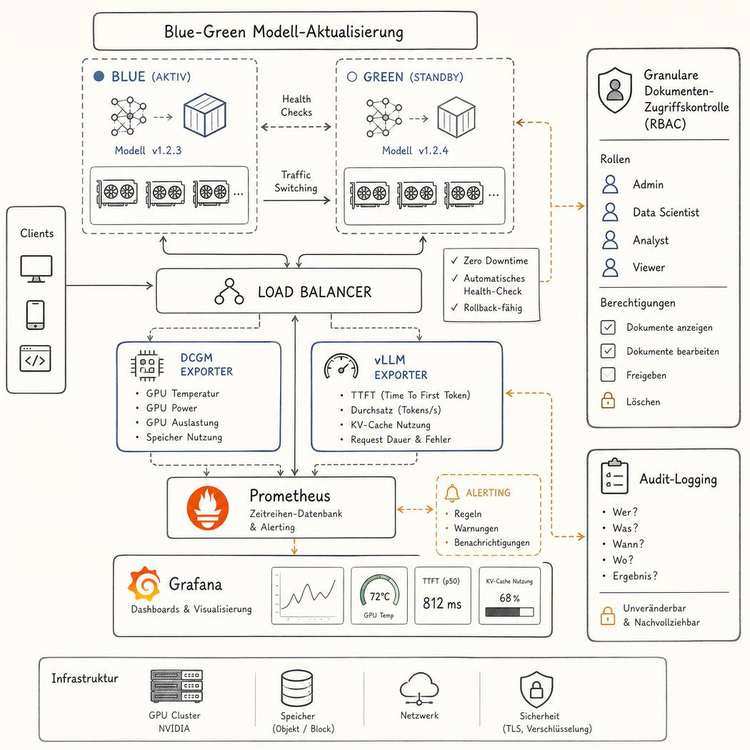
Kapitel 11: Enterprise-Betrieb: Sicherheit, Monitoring, Hochverfügbarkeit & Lifecycle Management
Der Produktivbetrieb lokaler Sprachmodelle in regulierten Unternehmensumgebungen erfordert dieselbe operationelle Disziplin wie relationale Datenbanksysteme oder ERP-Kernanwendungen. Ein Modell, das isoliert auf einem Entwickler-Host ausgeführt wird, genügt weder den Sicherheitsanforderungen des Zero-Trust-Prinzips noch den Compliance-Vorgaben nach ISO/IEC 27001 oder NIS-2.
Dieses Kapitel behandelt die unterbrechungsfreie Bereitstellung, rollenbasierte Zugriffskontrolle (RBAC), metadatenbasierte Berechtigungsfilterung in RAG-Pipelines, kontinuierliche GPU- und Inferenz-Telemetrie sowie risikofreie Aktualisierungsstrategien.
11.1 Access Control & RBAC: Absicherung der Inferenz- und UI-Ebene
Die direkte Exposition von Inferenz-Engines (wie vLLM, Ollama oder Triton Inference Server) im lokalen Unternehmensnetzwerk stellt ein Sicherheitsrisiko dar. Diese Engines verfügen ab Werk über keine mandantenfähige Authentifizierung, kein Token-Rate-Limiting und keine feingranularen Zugriffskontrolllisten.
+---------------------------------------------------------------------------------------------------+
|                        ENTERPRISE AUTHENTIFIZIERUNGS- & RBAC-ARCHITEKTUR                          |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|   +-------------------------------------------------------------------------------------------+   |
|   | Identity Provider (IdP): Microsoft Entra ID (Azure AD) / Keycloak (OIDC & SAML 2.0)       |   |
|   |  - Benutzergruppen: `ai-users-basic`, `ai-users-finance`, `ai-developers`, `ai-admins`    |   |
|   +-------------------------------------------------------------------------------------------+   |
|                                       | OpenID Connect (JWT Token + Scopes)                       |
|                                       v                                                           |
|   +-------------------------------------------------------------------------------------------+   |
|   | API-Gateway / Reverse Proxy: Traefik + OAuth2-Proxy / LiteLLM Proxy                       |   |
|   |  - Validiert JWT Signature & Expiration                                                   |   |
|   |  - Erzwingt TLS 1.3, Rate-Limits & Per-User Token-Quotas                                  |   |
|   +-------------------------------------------------------------------------------------------+   |
|                                       |                                                           |
|             +-------------------------+-------------------------+                                 |
|             | HTTP Header (`X-User`, `X-Groups`)                | Bearer Token (Service Account)  |
|             v                                                   v                                 |
|   +-----------------------------------+       +-----------------------------------+               |
|   | Open WebUI (Menschliche Nutzer)   |       | vLLM Cluster (API-Backend)        |               |
|   |  - Rollen: User, Admin            | ----> |  - OpenAI-kompatible REST API     |               |
|   |  - Modell-Whitelist per Gruppe    |       |  - Keine öffentliche Exposition   |               |
|   +-----------------------------------+       +-----------------------------------+               |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
11.1.1 Absicherung von Open WebUI via OpenID Connect (Keycloak / Entra ID)
Open WebUI unterstützt nativen OIDC-Login. Die Konfiguration erfolgt über Umgebungsvariablen im Docker-Compose-Verbund.
# docker-compose.prod.yml (Auszug: Open WebUI mit Entra ID / Keycloak OIDC)
version: '3.8'

services:
  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    container_name: open-webui-prod
    restart: always
    environment:
      - 'WEBUI_SECRET_KEY=e8f3b2a9c4d1e0f7a5b3c2d1e9f8a7b6'
      - 'OPENAI_API_BASE_URL=http://litellm-proxy:4000/v1'
      - 'OPENAI_API_KEY=sk-internal-enterprise-proxy-key'
      # OIDC / OAuth2 Konfiguration
      - 'ENABLE_OAUTH_SIGNUP=true'
      - 'OAUTH_CLIENT_ID=open-webui-client'
      - 'OAUTH_CLIENT_SECRET=super-secure-oidc-client-secret'
      - 'OPENID_PROVIDER_URL=https://auth.unternehmen.internal/realms/enterprise/.well-known/openid-configuration'
      - 'OAUTH_PROVIDER_NAME=Enterprise SSO'
      - 'OAUTH_SCOPES=openid email profile groups'
      - 'OAUTH_USERNAME_CLAIM=preferred_username'
      - 'OAUTH_EMAIL_CLAIM=email'
      # Rollen-Mapping
      - 'ENABLE_OAUTH_ROLE_MAPPING=true'
      - 'OAUTH_ROLES_CLAIM=groups'
      - 'OAUTH_ADMIN_ROLES=ai-administrators,domain-admins'
    ports:
      - '127.0.0.1:8080:8080'
    networks:
      - ai-internal-net

networks:
  ai-internal-net:
    internal: true
11.1.2 Granulare Dokumentenberechtigungen im RAG (Metadata Filtering)
Ein kritisches Sicherheitsrisiko bei unternehmensweiten RAG-Systemen ist das unautorisierte Durchsickern von Informationen (Data Exfiltration via Inferenz). Ein Mitarbeiter aus der Logistik darf bei Abfragen über den Wissens-Assistenten keine Gehaltsdaten aus der Geschäftsleitungs-Ablage erhalten, selbst wenn diese semantisch die beste Übereinstimmung zur Suchanfrage aufweisen.
+---------------------------------------------------------------------------------------------------+
|                        METADATEN-BASIERTES RAG BERECHTIGUNGSFILTERING                             |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|  1. Benutzer-Anfrage: "Wie hoch waren die Boni im Q4?"                                            |
|     Benutzer-Kontext (aus JWT): User: `s.meier`, Groups: `['sales', 'logistics']`                |
|                                                                                                   |
|  2. Qdrant / pgvector Vektor-Query mit Hard-Constraint-Filter:                                    |
|     +---------------------------------------------------------------------------------------+     |
|     | Filter-Bedingung (Payload Matching):                                                  |     |
|     | `(acl_users CONTAINS 's.meier') OR (acl_groups OVERLAPS ['sales', 'logistics'])`      |     |
|     +---------------------------------------------------------------------------------------+     |
|                                       |                                                           |
|                                       v                                                           |
|  3. Vektorsuchraum wird VOR dem Distanzvergleich auf autorisierte Chunks eingeschränkt.           |
|     -> HR-/Geschäftsleitungs-Dokumente werden auf Indexebene physikalisch ignoriert.              |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
Python-Implementierung eines ACL-geschützten Qdrant-Retrievals:
from qdrant_client import QdrantClient
from qdrant_client.http import models
from typing import List

def retrieve_authorized_context(
    query_vector: List[float],
    username: str,
    user_groups: List[str],
    collection_name: str = "enterprise_knowledge",
    limit: int = 5
) -> List[dict]:
    """
    Führt eine Vektorsuche durch, die ausschließlich Chunks zurückliefert,
    für die der Nutzer explizit berechtigt ist (ACL-Metadatenfilterung).
    """
    client = QdrantClient(host="qdrant.internal", port=6333)

    # Aufbau des Boolschen Sicherheitsfilters
    security_filter = models.Filter(
        should=[
            models.FieldCondition(
                key="acl_users",
                match=models.MatchValue(value=username)
            ),
            models.FieldCondition(
                key="acl_groups",
                match=models.MatchAny(any=user_groups)
            )
        ]
    )

    search_result = client.search(
        collection_name=collection_name,
        query_vector=query_vector,
        query_filter=security_filter,
        limit=limit,
        with_payload=True
    )

    return [
        {
            "content": hit.payload["text"],
            "source": hit.payload["document_path"],
            "score": hit.score
        }
        for hit in search_result
    ]
11.2 Monitoring & Telemetrie: Prometheus, Grafana & DCGM
Ein verlässlicher Inferenzbetrieb erfordert zwei komplementäre Metrik-Schichten:
- Hardware-Ebene (NVIDIA Data Center GPU Manager / DCGM): Überwacht Stromaufnahme, Temperaturen, Speicherauslastung, PCIe-Bandbreite und Hardwarefehler (XID Errors).
- Inferenz-Engine-Ebene (vLLM native Metriken): Überwacht Warteschlangen, KV-Cache-Sättigung, Token-Durchsatz und Time-to-First-Token.
+---------------------------------------------------------------------------------------------------+
|                                  MONITORING & ALERTING PIPELINE                                   |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|   +-----------------------+   +-----------------------+   +-----------------------+               |
|   | NVIDIA GPUs           |   | vLLM Inferenz-Server  |   | LiteLLM Proxy / WebUI |               |
|   | (DCGM Exporter :9400) |   | (Prometheus :8000)    |   | (Prometheus :4000)    |               |
|   +-----------------------+   +-----------------------+   +-----------------------+               |
|              |                            |                            |                          |
|              +----------------------------+----------------------------+                          |
|                                           | Pull (scrape_interval: 5s)                            |
|                                           v                                                       |
|                        +-------------------------------------+                                    |
|                        | Prometheus Time Series DB (:9090)   |                                    |
|                        +-------------------------------------+                                    |
|                                           |                                                       |
|                    +----------------------+----------------------+                                |
|                    |                                             |                                |
|                    v                                             v                                |
|   +---------------------------------+           +---------------------------------+               |
|   | Grafana Dashboard (:3000)       |           | Alertmanager (:9093)            |               |
|   |  - KV-Cache Usage Heatmap       |           |  - PagerDuty / Slack Webhook    |               |
|   |  - Generation vs Prefill Latenz |           |  - GPU Temp > 85°C Alarm        |               |
|   +---------------------------------+           |  - VRAM Sättigung > 95% Alarm   |               |
|                                                 +---------------------------------+               |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
11.2.1 Zentrale vLLM-Prometheus-Metriken
| Metrik-Name | Typ | Kritischer Schwellenwert | Bedeutung & Diagnose |
|---|---|---|---|
vllm:num_requests_waiting |
Gauge | $> 5$ über 60 Sekunden | System überlastet. Eingehende Anfragen stauen sich in der Warteschlange. Skalierung oder Request-Dropping erforderlich. |
vllm:num_requests_running |
Gauge | Variiert je nach Server | Anzahl der Anfragen, die sich aktuell im aktiven Continuous Batching befinden. |
vllm:gpu_cache_usage_factor |
Gauge | $> 0.90$ ($90,%$) | Sättigung des PagedAttention KV-Caches. Bei $1.0$ droht Request-Preemption (Verdrängung) oder OOM-Recompute. |
vllm:time_to_first_token_seconds |
Histogram | $p95 > 2.0\text{ s}$ | Prefill-Latenz. Hohe Werte deuten auf massive Context-Größen oder unzureichende Compute-Leistung bei Lastspitzen hin. |
vllm:time_per_output_token_seconds |
Histogram | $p95 > 0.05\text{ s}$ ($< 20\text{ t/s}$) | Decoding-Geschwindigkeit pro Stream sinkt. Hinweis auf zu große Batch Sizes oder Bandbreiten-Throttling. |
11.2.2 NVIDIA DCGM Exporter Konfiguration
Start des NVIDIA DCGM Exporters via Docker zur Übergabe der GPU-Hardware-Telemetrie an Prometheus:
docker run -d --gpus all \
  --name dcgm-exporter \
  --restart always \
  -p 9400:9400 \
  nvcr.io/nvidia/k8s/dcgm-exporter:3.3.5-3.4.0-ubuntu22.04
Wichtige DCGM-Metriken für Alerting-Regeln:
DCGM_FI_DEV_GPU_TEMP: GPU-Kerntemperatur ($> 82\text{ }^\circ\text{C} \rightarrow \text{Warning}, > 88\text{ }^\circ\text{C} \rightarrow \text{Critical}$).DCGM_FI_DEV_MEMORY_TEMP: VRAM-Temperatur ($> 95\text{ }^\circ\text{C}$ bei GDDR6X $\rightarrow$ Throttling-Gefahr).DCGM_FI_DEV_POWER_USAGE: Reale Leistungsaufnahme in Watt.DCGM_FI_DEV_XID_ERRORS: NVIDIA-Treiber-Fehlercodes (z.B. XID 31 = GPU Page Fault, XID 79 = GPU ist vom PCIe-Bus abgefallen).
11.3 Backup, Model Lifecycle & Zero-Downtime Deployment
Sprachmodelle und Inferenz-Engines unterliegen kontinuierlichen Aktualisierungszyklen. Der Tausch eines Basismodells (z.B. Upgrade von Qwen 2.5 72B auf Qwen 3 72B) oder das Update von vLLM darf weder zu Serviceunterbrechungen noch zu unerwarteten Verhaltensänderungen (Regressions) führen.
+---------------------------------------------------------------------------------------------------+
|                        BLUE-GREEN DEPLOYMENT & LOAD BALANCING ARCHITEKTUR                         |
+---------------------------------------------------------------------------------------------------+
|                                                                                                   |
|                               +----------------------------------+                                |
|                               | Traefik / Nginx Reverse Proxy    |                                |
|                               | Health-Check: `/health`          |                                |
|                               +----------------------------------+                                |
|                                       |                   |                                       |
|                  Aktiver Traffic 100% |                   | 0% (Staging / Warmup)                 |
|                                       v                   v                                       |
|                    +---------------------+     +---------------------+                            |
|                    | INSTANZ BLAU        |     | INSTANZ GRÜN        |                            |
|                    | (Produktiv v0.7.1)  |     | (Neu v0.7.2 / Qwen3)|                            |
|                    | GPUs: 0, 1          |     | GPUs: 2, 3          |                            |
|                    | Status: Healthy     |     | Status: Warming Up  |                            |
|                    +---------------------+     +---------------------+                            |
|                                                                                                   |
|  Schritte beim Modell-Swap:                                                                       |
|  1. Instanz Grün starten & Modellgewichte in VRAM laden.                                          |
|  2. Automatisierte Prompt-Batterie gegen Grün ausführen (Regressions-Test).                       |
|  3. Traefik-Routing atomar auf Grün umschalten.                                                   |
|  4. Instanz Blau nach Entleeren der bestehenden Streams herunterfahren (Graceful Drain).          |
|                                                                                                   |
+---------------------------------------------------------------------------------------------------+
11.3.1 Air-Gapped Model Mirroring und Artefakt-Versionierung
Im Unternehmensumfeld dürfen Produktionsserver Modelle nicht unkontrolliert über das Internet von Hugging Face herunterladen. Modelle müssen versionsgesichert auf einem internen Object Storage (MinIO / Ceph S3) oder einem gespiegelten Verzeichnis vorgehalten werden.
Bash-Skript zum deterministischen Snapshot-Spiegeln:
#!/usr/bin/env bash
set -euo pipefail

MODEL_ID="Qwen/Qwen2.5-72B-Instruct"
REVISION="b8162e08420e6f3b06e8648e24484b80b2a3d077" # Niemals 'main' verwenden!
DEST_DIR="/data/models/snapshots/${MODEL_ID}/${REVISION}"

echo "=== Spiegeln von ${MODEL_ID} auf Revision ${REVISION} ==="
mkdir -p "${DEST_DIR}"

# Download via Hugging Face CLI mit verifizierter Revision
python3 -c "
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id='${MODEL_ID}',
    revision='${REVISION}',
    local_dir='${DEST_DIR}',
    local_dir_use_symlinks=False,
    ignore_patterns=['*.bin', '*.msgpack'] # Nur SafeTensors laden
)
"

# SHA256 Prüfsummen-Verifikation der Safetensors-Dateien
cd "${DEST_DIR}"
sha256sum --check model.safetensors.index.json.sha256 || true
echo "Modell erfolgreich gespiegelt und verifiziert unter: ${DEST_DIR}"
11.3.2 Automatisierte Regressions-Tests vor Modell-Rollouts
Vor der Umschaltung des Produktiv-Traffics auf eine neue Modellversion muss eine standardisierte Testbatterie prüfen, ob strukturelle Ausgabeformate (z.B. JSON-Modi), Klassifizierungsgenauigkeiten und Latenzbudgets eingehalten werden.
# test_model_regression.py (Auszug)
import json
import time
import urllib.request

STAGING_URL = "http://localhost:8001/v1/chat/completions"

PROMPT_SUITE = [
    {
        "name": "JSON Structured Output Test",
        "messages": [
            {"role": "system", "content": "Antworte ausschließlich in gültigem JSON."},
            {"role": "user", "content": "Extrahiere Name und Alter: Peter Schmidt ist 42 Jahre alt."}
        ],
        "expected_keys": ["name", "alter"]
    },
    {
        "name": "Determinismus & Tool-Call Syntax",
        "messages": [
            {"role": "user", "content": "Rufe das Wetter-Tool für Zürich auf."}
        ],
        "must_contain": "get_weather"
    }
]

def run_regression_tests():
    for test in PROMPT_SUITE:
        payload = json.dumps({
            "model": "staged-model",
            "messages": test["messages"],
            "temperature": 0.0,
            "max_tokens": 150
        }).encode("utf-8")

        req = urllib.request.Request(STAGING_URL, data=payload, headers={"Content-Type": "application/json"})
        start_time = time.time()

        with urllib.request.urlopen(req) as resp:
            latency = time.time() - start_time
            result = json.loads(resp.read().decode("utf-8"))
            content = result["choices"][0]["message"]["content"]

        print(f"Test '{test['name']}': Latenz {latency:.2f}s")
        if "expected_keys" in test:
            parsed = json.loads(content)
            for k in test["expected_keys"]:
                assert k in parsed, f"Schlüssel {k} fehlt in Ausgabe!"
        if "must_contain" in test:
            assert test["must_contain"] in content, f"Erwartetes Token '{test['must_contain']}' fehlt!"

    print("Alle Regressions-Tests erfolgreich bestanden. Bereit für Traffic-Umschaltung.")

if __name__ == "__main__":
    run_regression_tests()
[Praxis-Tipp]
Integrieren Sie diesen Regressions-Testlauf in Ihre CI/CD-Pipeline (z.B. GitLab CI oder GitHub Actions Runner mit GPU-Zugriff). Erst wenn die Testbatterie ohne Assertion-Fehler durchläuft und die $p95$-Latenz unter dem Schwellenwert liegt, sendet die Pipeline den Umschaltbefehl an den Traefik-API-Endpunkt.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.