Evolution 2020–2026
Die wichtigsten Sprünge bei Open Weights.
Die wichtigsten Sprünge bei Open Weights. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
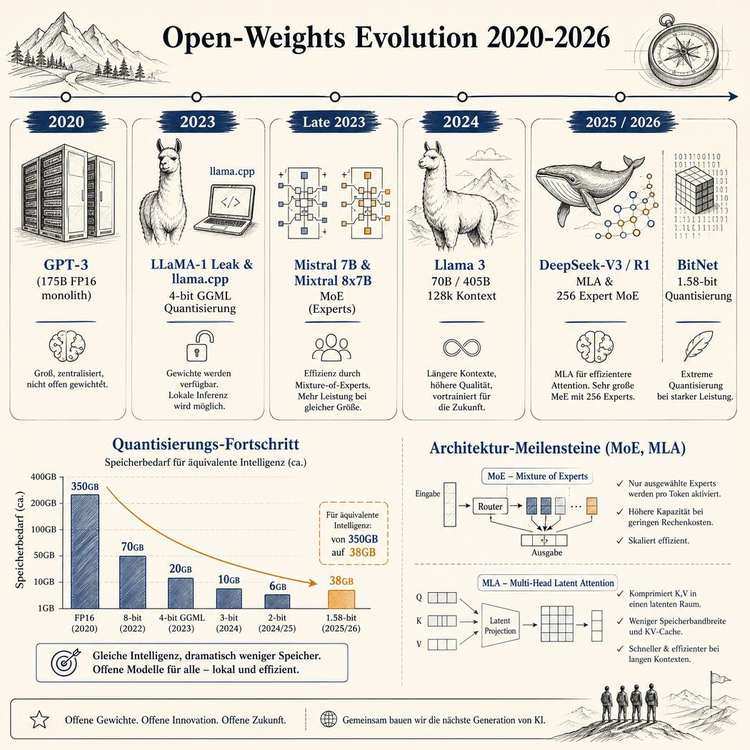
Kapitel 12: Evolution & Retrospektive: Der Weg zur lokalen KI-Souveränität
Die Ausführung von Large Language Models auf lokaler Hardware galt noch Anfang 2023 als theoretisches Randphänomen, das auf Multi-Node-Servercluster mit 8x NVIDIA A100 (80 GB SXM4) beschränkt schien. Zwischen 2020 und 2026 vollzog sich jedoch ein beispielloser technologischer Wandel: Durch tiefgreifende mathematische Innovationen in der Aufmerksamkeitsmechanik, Sparse-MoE-Topologien und verlustarme Quantisierungsverfahren sank der Speicher- und Rechenbedarf für State-of-the-Art-Inferenz um mehr als den Faktor vier. Ein 70B-Parametermodell, das 2020 unkomprimiert 140 GB VRAM erforderte und Memory-Bandwidths jenseits von 1.5 TB/s voraussetzte, lässt sich 2026 mit minimalem Perplexity-Verlust auf Consumer-Hardware mit 38 bis 40 GB adressierbarem Speicher betreiben.
+----------------------------------------------------------------------------------------------------+
|                                 CHRONOLOGIE DER OPEN-WEIGHTS EVOLUTION                             |
|                                                                                                    |
|  2020: GPT-3 (175B)          Mai 2020: Monolithisch, 175 Mrd. Parameter, FP16 (~350 GB), closed    |
|       |                                                                                            |
|  2023: LLaMA-1 Leak          März 2023: Georgi Gerganovs llama.cpp (AVX2/NEON), 4-Bit GGML        |
|       |                      7B bis 65B Gewichte frei verfügbar, Start der Open-Source-Inferenz     |
|       |                                                                                            |
|  2023: Mistral 7B & Mixtral  Herbst 2023: Sliding Window Attention (SWA), GQA, MoE 8x7B (47B Param, |
|       |                      13B aktiv). Erste Open-Weights-Architektur, die GPT-3.5 schlägt       |
|       |                                                                                            |
|  2024: Llama 3 / 3.1 / 3.3   April-Dez 2024: 8B bis 405B, 128k Kontextfenster, 15T Token Training  |
|       |                      Llama 3.3 70B erreicht 405B-Qualitätsniveau bei 70B-Inferenzkosten    |
|       |                                                                                            |
|  2025/2026: DeepSeek V3 / R1 Jan 2025+: Multi-Head Latent Attention (MLA), DeepSeekMoE (256 Exp.,  |
|                              37B aktiv / 671B total), DualPipe Parallelismus, FP8-Nativtraining   |
+----------------------------------------------------------------------------------------------------+
12.1 Chronologie der Modellarchitekturen (2020–2026)
2020: Das Zeitalter der unerreichbaren Monolithen (GPT-3)
Mit der Veröffentlichung von Language Models are Few-Shot Learners durch OpenAI im Mai 2020 demonstrierte das 175-Milliarden-Parameter-Modell GPT-3 (Davinci) emergente Fähigkeiten im In-Context Learning. Die Architektur basierte auf einem Standard-Dense-Transformer (Decoder-only) mit Dense Multi-Head Attention (MHA):
$$\text{MHA}(Q, K, V) = \text{Concat}(\text{head}_1, \dots, \text{head}_h)W^O$$
$$\text{head}_i = \text{Softmax}\left(\frac{Q_i K_i^T}{\sqrt{d_k}}\right)V_i$$
In FP16 belegten die reinen Modellgewichte 350 GB VRAM. Zusammen mit dem unkomprimierten KV-Cache (2 Bytes pro Token, Layer und Head) erforderte ein einziges Inferenzsystem mindestens acht NVIDIA A100 (40 GB) GPUs im Tensor-Parallel-Verbund ($TP=8$). Die Ausführung auf lokalen Workstations oder On-Premise-Servern des Mittelstands war technisch und wirtschaftlich ausgeschlossen.
März 2023: Der LLaMA-1-Leak als Katalysator
Im März 2023 gelangten die Gewichte von Metas LLaMA-1-Modellfamilie (7B, 13B, 30B, 65B) an die Öffentlichkeit. Trainiert auf 1.0 bis 1.4 Billionen Tokens und ausgestattet mit architektonischen Verfeinerungen wie Rotary Position Embeddings (RoPE) und SwiGLU-Aktivierungsfunktionen:
$$\text{SwiGLU}(x, W, V, W_2) = \left(\text{Swish}(xW) \otimes xV\right)W_2$$
$$\text{wobei} \quad \text{Swish}(z) = z \cdot \sigma(\beta z)$$
Binnen weniger Tage implementierte Georgi Gerganov das Projekt llama.cpp in reinem C/C++ ohne externe Abhängigkeiten. Durch Ausnutzung von AVX2- und AVX-512-Vektorinstruktionen auf x86_64-CPUs sowie ARM NEON auf Apple-Silicon-SoCs (M1/M2) konnten Entwickler erstmals ein 7B-Modell mit 4-Bit-Quantisierung auf einem Notebook mit 8 GB RAM bei Inferenzraten von 12 bis 18 Tokens pro Sekunde betreiben.
Herbst 2023: Mistral 7B und Mixtral 8x7B (MoE-Durchbruch)
Das französische Startup Mistral AI führte im September 2023 mit Mistral 7B zwei entscheidende architektonische Verbesserungen in den Mainstream ein:
- Grouped-Query Attention (GQA): Während MHA für jeden Query-Head ($h_Q$) einen eigenen Key- und Value-Head besitzt ($h_{KV} = h_Q$), teilt GQA die Query-Heads in Gruppen ein, die sich jeweils einen einzigen Key/Value-Head teilen ($h_{KV} \ll h_Q$, typischerweise $h_Q/h_{KV} = 8$). Dadurch schrumpft der KV-Cache-Speicherbedarf um das Achtfache:
$$\text{KV-Cache-Reduktion} = 1 - \frac{h_{KV}}{h_Q} = 1 - \frac{8}{64} = 87.5%$$ - Sliding Window Attention (SWA): Eine lokale Aufmerksamkeitsmaske begrenzt die Attention-Berechnung auf ein fixes Fenster von $W = 4096$ Tokens pro Layer, wodurch die Rechenkomplexität von $\mathcal{O}(N^2)$ auf $\mathcal{O}(N \cdot W)$ sinkt.
Im Dezember 2023 folgte Mixtral 8x7B, eine Sparse Mixture-of-Experts (SMoE) Architektur. Statt einer dichten Feed-Forward-Schicht (FFN) nutzt jeder Layer acht spezialisierte FFN-Netzwerke ("Experten"). Ein lernbares Top-2-Gating-Netzwerk routet jedes Token dynamisch an genau zwei Experten:
$$y = \sum_{i \in \text{Top2}(G(x))} P_i(x) \cdot E_i(x)$$
$$G(x) = \text{Softmax}(\text{Top2}(x \cdot W_g))$$
Mixtral 8x7B besitzt insgesamt 46.7 Milliarden Parameter, aktiviert pro Token jedoch nur 12.9 Milliarden. Das Modell erreichte die Inferenzlatenz eines 13B-Dense-Modells bei der Benchmark-Präzision eines 70B-Dense-Modells.
                    TOP-2 GATING IN SPARSER MOE-ARCHITEKTUR

                      +-----------------------------+
                      |       Input-Token x         |
                      +--------------+--------------+
                                     |
                                     v
                      +-----------------------------+
                      |   Gating Network W_g        |
                      |   Softmax(Top-2 Router)     |
                      +---+---------------------+---+
                          |                     |
                   P_1 = 0.68            P_4 = 0.32
                          |                     |
                          v                     v
                   +--------------+      +--------------+
                   |  Expert 1    |      |  Expert 4    |
                   |  (SwiGLU FFN)|      |  (SwiGLU FFN)|
                   +-------+------+      +-------+------+
                           |                     |
                           +----------+----------+
                                      |
                                      v
                      +-----------------------------+
                      |  y = 0.68*E1(x) + 0.32*E4(x)|
                      +-----------------------------+
2024: Die Llama-3-Familie (8B bis 405B)
Meta etablierte mit Llama 3 (April 2024), Llama 3.1 (Juli 2024) und Llama 3.3 (Dezember 2024) die industrielle Referenz für Open-Weights. Die Modelle wurden auf über 15 Billionen Tokens trainiert und nutzten einen vergrößerten Byte-Pair-Encoding (BPE) Tokenizer mit 128.256 Tokens Vokabulargröße.
Das Flaggschiff Llama 3.1 405B war das erste öffentlich verfügbare Modell, das proprietären Closed-Source-Frontier-Systemen (GPT-4, Claude 3.5 Sonnet) im MMLU, MATH und HumanEval ebenbürtig war. Mit Llama 3.3 70B gelang Meta eine Destillation, die das Reasoning-Niveau des 405B-Vorgängers in einem 70B-Footprint bereitstellte.
+------------------+-----------------+---------------+----------------+----------------+
| Modell           | Parameter Total | Aktive Param. | Kontextfenster | Native VRAM    |
|                  |                 | pro Token     | (Tokens)       | FP16 / BF16    |
+------------------+-----------------+---------------+----------------+----------------+
| Llama-1 65B      | 65.2 Mrd.       | 65.2 Mrd.     | 2.048          | 130.4 GB       |
| Mistral 7B       | 7.24 Mrd.       | 7.24 Mrd.     | 32.768         | 14.5 GB        |
| Mixtral 8x7B     | 46.7 Mrd.       | 12.9 Mrd.     | 32.768         | 93.4 GB        |
| Llama 3.1 8B     | 8.03 Mrd.       | 8.03 Mrd.     | 131.072        | 16.1 GB        |
| Llama 3.3 70B    | 70.6 Mrd.       | 70.6 Mrd.     | 131.072        | 141.2 GB       |
| DeepSeek-V3      | 671.0 Mrd.      | 37.0 Mrd.     | 128.000        | 671.0 GB (FP8) |
| DeepSeek-R1      | 671.0 Mrd.      | 37.0 Mrd.     | 128.000        | 671.0 GB (FP8) |
+------------------+-----------------+---------------+----------------+----------------+
2025/2026: Die DeepSeek-Disruption (MLA und Sparse-MoE)
Mit der Veröffentlichung von DeepSeek-V3 und DeepSeek-R1 Ende 2024 / Anfang 2025 demonstrierte DeepSeek eine radikale Effizienzsteigerung im Verhältnis von Trainingskosten zu Inferenzleistung. Das Modell mit 671 Milliarden Gesamtparametern aktiviert pro Token lediglich 37 Milliarden Parameter, verteilt über 256 feingranulare Experten (plus einen Shared Expert), von denen 8 Experten dynamisch zugewiesen werden.
Zwei Kerntechnologien definieren den Durchbruch:
1. Multi-Head Latent Attention (MLA)
Konventionelle Multi-Head oder Grouped-Query Attention speichert die unkomprimierten Key- und Value-Vektoren im KV-Cache. Bei 128k Kontextfenstern dominiert der KV-Cache den VRAM-Verbrauch vollständig. MLA komprimiert Key und Value in einen niedrigdimensionalen latenten Vektor $c_t^{KV}$ der Dimension $d_c \ll d_h \cdot n_h$:
$$c_t^{KV} = W^{DKV} h_t \quad (W^{DKV} \in \mathbb{R}^{d_c \times d})$$
$$k_t^C = W^{UK} c_t^{KV}, \quad v_t^C = W^{UV} c_t^{KV}$$
Im KV-Cache wird ausschließlich der komprimierte latente Vektor $c_t^{KV}$ sowie ein entkoppelter RoPE-Schlüssel $k_t^R$ gespeichert:
$$\text{Cache-Größe pro Token} = d_c + d_R \quad \text{statt} \quad 2 \cdot n_{KV} \cdot d_h$$
Bei DeepSeek-V3 reduziert MLA den KV-Cache-Footprint von 164 Bytes/Token (MHA-Äquivalent) auf 21.5 Bytes/Token – eine Reduktion um 86.9%.
                   MULTI-HEAD LATENT ATTENTION (MLA) TOPOLOGIE

   Hidden State h_t
          |
          +-----------------------------------------+
          | Down-Projection (W^DKV)                 | Decoupled RoPE (W^KR)
          v                                         v
   Latent Vector c_t^{KV} [d_c = 512]         RoPE Key k_t^R [d_R = 64]
          |                                         |
          +===================+=====================+
                              |
                              v
                   GESPEICHERT IM KV-CACHE:
                   [c_t^{KV} || k_t^R] = 576 floats
                   (93.3% kleiner als MHA KV-Cache)
                              |
          +-------------------+---------------------+
          | Up-Projection (W^UK)                    | Up-Projection (W^UV)
          v                                         v
   Decompressed Keys (K)                     Decompressed Values (V)
2. DeepSeek-Sparse MoE mit Shared Experts
Statt weniger großer Experten nutzt DeepSeek 256 extrem kleine Sub-Experten. Mindestens ein Experte ist als Shared Expert fixiert und verarbeitet jedes Token bedingungslos, während sieben weitere Sub-Experten über ein Sigmoid-basiertes Routing selektiert werden. Dies verhindert Routing-Kollisionen und sichert grundlegendes Weltwissen im Shared-Pfad ab.
12.2 Die Evolution der Quantisierungstechnologien
Die mathematische Inferenz von Transformern ist primär speicherbandbreitenlimitiert (Memory-Bound). Die Generierungsphase eines Tokens (Autoregressives Decoding mit Batch Size 1) erfordert das vollständige Laden aller aktiven Modellgewichte aus dem DRAM/VRAM in die Rechenkerne:
$$\text{Minimale Latenz pro Token} = \frac{\text{Modellgröße in Bytes}}{\text{Speicherbandbreite in Byte/s}}$$
Für ein unkomprimiertes FP16-Modell mit 70 Milliarden Parametern (141.2 GB) auf einer NVIDIA GeForce RTX 4090 (24 GB GDDR6X, 1008 GB/s Bandbreite) ist Inferenz im VRAM physikalisch unmöglich. Über System-RAM (DDR5-6400 Dual-Channel, theoretisch 102.4 GB/s, real ~75 GB/s) ergäbe sich eine theoretische Obergrenze von:
$$\text{Tokens/s}_{\text{theoretisch}} = \frac{75 \times 10^9 \text{ Byte/s}}{141.2 \times 10^9 \text{ Bytes}} \approx 0.53 \text{ Tokens/s}$$
Die Quantisierung von 16-Bit-Gleitkommazahlen auf 4-Bit- oder 3-Bit-Ganzzahldarstellungen verringert das Transfervolumen um den Faktor 3.5 bis 5.3.
+----------------------------------------------------------------------------------------------------+
|                                 EVOLUTION DER QUANTISIERUNGSFORMATE                                |
|                                                                                                    |
|  2022: RTN (Round-to-Nearest)        Uniforme Rundung, massiver Perplexity-Verlust unter 8-Bit     |
|        |                                                                                           |
|  2023: GPTQ (Post-Training Quant.)   Hesse-Matrix-basierte inverse Fehlerkompensation (Layer-wise) |
|        |                             W4A16 Inferenz auf GPU, feste Blockgrößen (z.B. 128)          |
|        |                                                                                           |
|  2023: AWQ (Activation-Aware Quant.) Schützt 1% der Salient Weights anhand von Aktivierungs-Normen  |
|        |                             Kein Retraining nötig, hardwarenahe SIMD/Tensor-Kernel        |
|        |                                                                                           |
|  2023: GGUF K-Quants (llama.cpp)     Gemischte Bit-Präzisionen pro Tensor (Q4_K_M, Q5_K_S)         |
|        |                             Skalenfaktoren und Offsets selbst quantisiert (Block-Quants)  |
|        |                                                                                           |
|  2024: GGUF IQ-Quants                Importance-Matrix-Kalibrierung (imatrix) + Vector-Quants      |
|        |                             2.2 bis 3.5 Bit/Weight bei minimalem Qualitätsverlust         |
|        |                                                                                           |
|  2024/2026: EXL2 (ExLlamaV2)         Variable Bitrate pro Layer (Sub-Bit Quantisierung, z.B. 4.25b)|
|                                      Optimiert für NVIDIA Tensor Cores mit FP16-Aktivierungen      |
+----------------------------------------------------------------------------------------------------+
Mathematische Grundlagen: Von RTN zu Second-Order Optimization
Round-to-Nearest (RTN)
Klassische uniforme Quantisierung skaliert Gewichte $W$ linear in einen Ganzzahlbereich:
$$\hat{W} = \text{clamp}\left(\left\lfloor \frac{W}{S} \right\rceil + Z, -2^{b-1}, 2^{b-1}-1\right)$$
$$S = \frac{\max(W) - \min(W)}{2^b - 1}, \quad Z = -\left\lfloor \frac{\min(W)}{S} \right\rceil$$
Unterhalb von 8 Bit kollabiert RTN, da Ausreißergewichte (Outliers) mit Amplituden jenseits von $6\sigma$ die Skala $S$ dominieren und die Mehrheit der informativen Gewichte nahe 0 auf denselben Integer-Wert runden.
GPTQ: Second-Order Error Compensation
GPTQ nutzt die Taylor-Reihenentwicklung des Rekonstruktionsfehlers $E = |WX - \hat{W}X|2^2$. Unter Verwendung der inversen Hesse-Matrix $H = 2X X^T$ wird beim Quantisieren eines Gewichts $w_q$ der verbleibende unquantisierte Gewichtsvektor $W{:, >q}$ kompensatorisch angepasst:
$$\hat{w}_q = \text{quant}(w_q)$$
$$W_{:, >q} \leftarrow W_{:, >q} - \frac{w_q - \hat{w}q}{[H^{-1}]{qq}} \cdot [H^{-1}]_{q, >q}$$
Dieser Algorithmus arbeitet mit Cholesky-Zerlegung in $\mathcal{O}(d^3)$ und quantisiert ein 70B-Modell in weniger als 4 GPU-Stunden.
                    FEHLERKOMPENSATION IN DER GPTQ-ABFOLGE

     Original Matrix W                 Quantisierung Spalte q          Kompensations-Update
   +---+---+---+---+---+              +---+---+---+---+---+            +---+---+---+---+---+
   | * | * | * | * | * |              | # | * | * | * | * |            | # | + | + | + | + |
   | * | * | * | * | * |   ======>    | # | * | * | * | * |  ======>   | # | + | + | + | + |
   | * | * | * | * | * |              | # | * | * | * | * |            | # | + | + | + | + |
   +---+---+---+---+---+              +---+---+---+---+---+            +---+---+---+---+---+
                                        ^                                    ^
                                  Rundung auf 4-Bit               Update via [H^-1]_{q, >q}
AWQ: Activation-Aware Weight Quantization
AWQ stellte fest, dass nicht alle Gewichte dieselbe funktionale Relevanz besitzen. Durch Messung der Aktivierungsbeträge $s_X = \frac{1}{N} \sum |X|$ identifiziert AWQ das oberste 1% der Gewichte als Salient Weights. Statt diese in FP16 zu belassen (was Hardware-Inferenz verlangsamt), skaliert AWQ sie vor der Quantisierung:
$$W' = W \cdot S, \quad X' = S^{-1} \cdot X$$
$$S = \arg\min_S \mathcal{L}(W \cdot S)$$
Das System minimiert den Quantisierungsfehler gezielt für Kanäle mit hohen Aktivierungsamplituden.
GGUF K-Quants und Importance Matrix (imatrix)
Das von Georgi Gerganov entwickelte GGUF-Format (Successor von GGML) strukturierte Quantisierungsblöcke hierarchisch. In Standard-K-Quants werden Super-Blöcke (typischerweise 256 Gewichte) in 8 Sub-Blöcke zu je 32 Gewichten unterteilt:
- Q4_K_M (Medium): Verwendet 4 Bit für den Großteil der Tensoren, belässt jedoch kritische Attention-Gate- und Output-Layers (
v_proj,down_proj) teilweise auf 6-Bit-Präzision. - Importance Matrix (imatrix): Ein Kalibrierungsdurchlauf über einen Referenztext berechnet die Sensitivitätsmatrix jedes einzelnen Tensors. Die IQ-Quantisierer (
IQ2_XXS,IQ3_M,IQ4_NL) nutzen vectorielle Codebooks und nicht-lineare Gitter, um bei nominal 3.0 Bit/Weight die Perplexity eines regulären 4-Bit-Modells zu erreichen.
+----------------------------------------------------------------------------------------------------+
|                                    GGUF SUPER-BLOCK STRUKTUR (256 ELEM)                            |
|                                                                                                    |
|  +----------------------------------------------------------------------------------------------+  |
|  | Super-Block Header: Scale d (FP16, 2 Bytes) + Min dmin (FP16, 2 Bytes)                       |  |
|  +----------------------------------------------------------------------------------------------+  |
|  | Sub-Block Scales: 8x 6-Bit Werte (gepackt in 6 Bytes)                                        |  |
|  +----------------------------------------------------------------------------------------------+  |
|  | Quantisierte Gewichtsdaten: 256 x 4-Bit Nibbles = 128 Bytes                                  |  |
|  +----------------------------------------------------------------------------------------------+  |
|  | Netto-Bitrate pro Gewicht: (2 + 2 + 6 + 128) * 8 / 256 = 4.3125 Bits/Gewicht                 |  |
|  +----------------------------------------------------------------------------------------------+  |
+----------------------------------------------------------------------------------------------------+
EXL2: Variable Bitrate Quantization
ExLlamaV2 führte das EXL2-Format ein. EXL2 quantisiert Modelle nicht mit einer globalen festen Bitrate, sondern ordnet jedem Layer und Tensor individuell eine kontinuierliche Ziel-Bitrate zu (z.B. 4.25 bpw, 5.0 bpw). Layer mit hoher Fehlertoleranz (mittlere MLP-Blöcke) werden auf 3 Bit komprimiert, während sensitive Layer (frühe und späte Attention-Projektionen) mit 6 bis 8 Bit quantisiert werden.
+------------------+---------------+----------------+-------------------+--------------------+
| Quantisierung    | Bits per      | Modellgröße    | Wikitext-2 PPL    | MMLU Score         |
| Format           | Weight (bpw)  | Llama 3.3 70B  | (niedriger=besser)| (0-100, 5-shot)    |
+------------------+---------------+----------------+-------------------+--------------------+
| BF16 (Baseline)  | 16.00         | 141.2 GB       | 2.85              | 86.4               |
| EXL2 6.0 bpw     | 6.00          | 53.8 GB        | 2.87 (+0.02)      | 86.2               |
| GGUF Q5_K_M      | 5.45          | 48.9 GB        | 2.89 (+0.04)      | 86.1               |
| GGUF Q4_K_M      | 4.50          | 41.2 GB        | 2.94 (+0.09)      | 85.7               |
| AWQ 4-Bit (128g) | 4.15          | 38.6 GB        | 2.98 (+0.13)      | 85.3               |
| EXL2 4.0 bpw     | 4.00          | 37.1 GB        | 2.99 (+0.14)      | 85.2               |
| GGUF IQ3_M       | 3.45          | 32.1 GB        | 3.18 (+0.33)      | 83.8               |
| GGUF IQ2_XS      | 2.31          | 22.4 GB        | 4.12 (+1.27)      | 76.4               |
+------------------+---------------+----------------+-------------------+--------------------+
[Deep Dive]
Perplexity vs. Downstream Task Accuracy: Ein Anstieg der Wikitext-2 Perplexity um weniger als 0.15 Punkte (wie bei Q4_K_M oder EXL2 4.0 bpw gegenüber BF16) korreliert in realen Reasoning-, Coding- und RAG-Aufgaben mit einem Leistungsabfall von unter 1.2%. Erst bei Bitraten unterhalb von 3.5 bpw tritt ein disproportionaler Verlust von strukturiertem Syntax-Verständnis (JSON-Compliance, Function Calling) ein.
12.3 Hardware-Mapping & Reale Durchsatz-Metriken
Die Verteilung quantisierter Modelle auf moderne Hardware-Konfigurationen erfordert ein exaktes Verständnis des Speicherbandbreiten-Engpasses und der PCIe-Transferlatenzen beim Offloading.
+----------------------------------------------------------------------------------------------------+
|                               HARDWARE-SPEICHERBANDBREITEN IM VERGLEICH                            |
|                                                                                                    |
|  DDR5-4800 (Dual Channel, CPU)       [38.4 GB/s]                                                   |
|  DDR5-6400 (Dual Channel, CPU)       [51.2 GB/s]                                                   |
|  LPDDR5X-7500 (Apple M4 Max, 512-bit)[410.0 GB/s]                                                 |
|  PCIe 4.0 x16 Bus                    [31.5 GB/s]                                                   |
|  PCIe 5.0 x16 Bus                    [63.0 GB/s]                                                   |
|  RTX 4090 (24 GB GDDR6X)             [1008.0 GB/s]                                                 |
|  2x RTX 3090 (2x 24 GB GDDR6X, NVL)  [1872.0 GB/s aggregate]                                       |
|  NVIDIA H100 (80 GB HBM3)            [3350.0 GB/s]                                                 |
+----------------------------------------------------------------------------------------------------+
Der Token/s Berechnungsstandard für Memory-Bound Decoding
Für Inferenz mit Batch Size $N=1$ berechnet sich die maximale Token-Generierungsrate aus der effektiven Speicherbandbreite $B_{\text{eff}}$ und dem Speicherbedarf des quantisierten Modells $M_{\text{quant}}$:
$$\text{Tokens/s} = \frac{B_{\text{eff}}}{M_{\text{quant}} + \text{KV-Cache-Transfer}}$$
Unter Vernachlässigung des KV-Cache-Transfers für kurze Kontexte ergibt sich für Llama 3.3 70B in Q4_K_M ($M_{\text{quant}} = 41.2\text{ GB}$):
-
Dual NVIDIA RTX 3090 (2x 24 GB = 48 GB VRAM, Tensor-Parallel über PCIe 4.0 x16):
$$B_{\text{eff}} \approx 900\text{ GB/s (pro GPU)}, \quad \text{Aggregate Decoding Speed} \approx 21.8\text{ Tokens/s}$$
Leistungsaufnahme: $2 \times 320\text{ W} = 640\text{ W} \implies \text{Energieeffizienz} \approx 29.3\text{ W}\cdot\text{s/Token}$ -
Apple Mac Studio (M2/M4 Ultra, 192 GB Unified Memory, 800 GB/s Bandbreite):
$$\text{Decoding Speed} = \frac{800\text{ GB/s} \times 0.85}{41.2\text{ GB}} \approx 16.5\text{ Tokens/s}$$
Leistungsaufnahme: $110\text{ W} \implies \text{Energieeffizienz} \approx 6.66\text{ W}\cdot\text{s/Token}$ -
Reines CPU-System (AMD EPYC 9654, 12-Kanal DDR5-4800, 460.8 GB/s Bandbreite):
$$\text{Decoding Speed} = \frac{460.8\text{ GB/s} \times 0.70}{41.2\text{ GB}} \approx 7.83\text{ Tokens/s}$$
Leistungsaufnahme: $360\text{ W} \implies \text{Energieeffizienz} \approx 45.9\text{ W}\cdot\text{s/Token}$
+------------------------------------------------------------------------------------+
| Hardware-Setup          | Modell & Quant.      | Durchsatz   | System-Leistung | Watt/Token |
|                         |                      | (Tokens/s)  | (Watt)          |            |
+------------------------------------------------------------------------------------+
| 1x RTX 4090 (24 GB)     | Llama 3.1 8B (Q8_0)  | 98.4 t/s    | 285 W           | 2.89 Ws/t  |
| 1x RTX 4090 (24 GB)     | Qwen 2.5 32B (IQ3_M) | 38.2 t/s    | 340 W           | 8.90 Ws/t  |
| 2x RTX 3090 (48 GB)     | Llama 3.3 70B (Q4_K) | 21.8 t/s    | 640 W           | 29.35 Ws/t |
| 4x RTX 4090 (96 GB)     | DeepSeek-R1 (IQ2_XS) | 14.2 t/s    | 1450 W          | 102.1 Ws/t |
| Apple M4 Max (128 GB)   | Llama 3.3 70B (Q4_K) | 9.8 t/s     | 78 W            | 7.95 Ws/t  |
| AMD EPYC 12-Ch DDR5     | Llama 3.3 70B (Q4_K) | 7.8 t/s     | 360 W           | 46.15 Ws/t |
+------------------------------------------------------------------------------------+
[Architektur-Hinweis]
CPU-Offloading-Falle: Das dynamische Offloading einzelner Layer in den System-RAM (z.B. 35 Layer auf GPU, 45 Layer auf CPU via llama.cpp -ngl 35) zwingt den Inferenz-Loop bei jedem Token zum synchronen Datentransfer über den PCIe-Bus. Bei PCIe 4.0 x16 (31.5 GB/s unidirektional) limitiert die Bus-Latenz den Gesamtdurchsatz auf das Niveau der langsamsten Komponente:
$$\text{Latenz}{\text{Schicht}} = \max\left(t{\text{GPU-Rechenzeit}}, \frac{\text{Layer-Gewichte}}{\text{PCIe-Bandbreite}} + t_{\text{CPU-Rechenzeit}}\right)$$
In heterogenen Setups bricht der Gesamtdurchsatz häufig auf 2 bis 4 Tokens/s ein.
[Warnung]
VRAM-Fragmentierung bei Langkontexten: Ein 128k-Kontextfenster in FP16 belegt bei Llama 3.3 70B ohne Kompression über 40 GB zusätzlichen Speicher rein für den KV-Cache. Für Produktivsysteme ist die Aktivierung von FP8- oder Q4-KV-Cache (--cache-type-k q4_0 --cache-type-v q4_0) zwingend erforderlich, um OOM-Crashes (Out of Memory) bei Document-Retrieval-Pipelines zu verhindern.
12.4 Technische Implikationen für die Praxis
Der Übergang von monolithischen 175B-Modellen zu hocheffizienten 70B-Dense- und 671B-MoE-Architekturen verschob die wirtschaftliche Grenze des On-Premise-Betriebs:
- Wegfall von Multi-Node-Clustern: Während 2020 für GPT-3-Äquivalente ein InfiniBand-vernetztes GPU-Cluster notwendig war, genügt 2026 eine Dual-GPU-Workstation (z.B. 2x RTX 4090 oder 2x RTX 5090) zur lokalen Bereitstellung von Llama 3.3 70B oder Qwen 2.5-Coder 32B.
- Kostenstruktur: Die Hardware-Amortisation eines lokalen 48-GB-Servers (~5.500 EUR Investitionskosten) wird gegenüber API-Tokenkosten von proprietären Anbietern bei kontinuierlicher Auslastung von 2 Millionen Tokens pro Tag in der Regel nach weniger als 90 Betriebstagen erreicht.
- Deterministische Latenzen: Lokale Inferenz eliminiert Netzwerk-Jitter, Multi-Tenant-Queueing und Server-Throttling proprietärer Cloud-Endpunkte und garantiert garantierte Time-to-First-Token (TTFT) Latenzen unter 200 ms bei Systemen mit CUDA-Graph-Kompilierung.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.