Ausblick
BitNet, Mamba, effiziente Inferenz und nächste Grenzen.
BitNet, Mamba, effiziente Inferenz und nächste Grenzen. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
Kapitel 13: Ausblick & Zukunft: Die nächste Welle lokaler Architekturen
Die Weiterentwicklung lokaler KI-Systeme wird von zwei Kräften getrieben: Einerseits verändern neue Siliziumarchitekturen (Unified-Memory-APUs und dedizierte NPUs) die physischen Bandbreiten- und Kapazitätsgrenzen am Netzwerkrand (Edge). Andererseits brechen fundamentale algorithmische Neuerungen – insbesondere ternäre 1.58-Bit-Gewichtsrepräsentationen und lineare State Space Models – mit dem klassischen Paradigma speicherhungriger Transformer. Für Enterprise-Architekturen resultiert dies in einer klar definierten Koexistenz zwischen hochperformanten lokalen Spezialisten und hyperskaligen Cloud-Reasoning-Systemen.
+----------------------------------------------------------------------------------------------------+
|                                DIE DREI SÄULEN DER NÄCHSTEN KI-GENERATION                          |
|                                                                                                    |
|  1. Silizium-Evolution (Edge/APU)   AMD Strix Halo (128 GB LPDDR5X, 256-bit Bus, ~270 GB/s)        |
|                                     Apple M-Serie (Unified Memory bis 512 GB, bis 800+ GB/s)       |
|                                     Qualcomm Oryon / NPU-Accelerators (45-80 TOPS NPU nativ)       |
|                                                                                                    |
|  2. Algorithmische Disruption       BitNet 1.58-Bit (b1.58): Gewichte {-1, 0, 1}, keine Multi-    |
|                                     plikationen mehr, reine Integer-Additionen, 80%+ Energie-      |
|                                     einsparung. Mamba/Jamba SSMs mit O(N) Komplexität statt O(N^2) |
|                                                                                                    |
|  3. Hybride System-Architektur      Lokale Low-Latency Worker (RAG, Routing, Tooling, PII Filter)  |
|                                     gekoppelt an Cloud Frontier Super-KIs für Deep Reasoning       |
+----------------------------------------------------------------------------------------------------+
13.1 On-Device NPUs, APUs und Unified Memory
Klassische x86-Workstations leiden unter dem Engpass der PCIe-Bus-Trennung zwischen System-Hauptspeicher (DDR5) und dediziertem Grafikspeicher (GDDR6X/HBM). Während VRAM-Bandbreiten von bis zu 1008 GB/s (RTX 4090) zur Verfügung stehen, ist die Speicherkapazität typischerweise auf 24 GB pro Consumer-Karte limitiert. Neue APU- und SoC-Designs eliminieren diesen Bus-Engpass durch Unified Memory Architectures (UMA).
                    VERGLEICH: DISKRETE GPU VS. UNIFIED MEMORY (UMA)

       Klassische x86 + dGPU Setup                     Unified Memory APU/SoC Setup
   +---------------------------------+             +----------------------------------+
   | System-RAM (DDR5, 64-128 GB)   |             | Unified Memory Pool (LPDDR5X)    |
   | Bandbreite: ~50-80 GB/s         |             | Bis 128-512 GB, ~270-800 GB/s    |
   +----------------+----------------+             +----------------+-----------------+
                    |                                               |
         PCIe 4.0/5.0 Bus (31.5-63 GB/s)            Gemeinsamer Ultra-Wide Memory Bus
                    |                                               |
   +----------------v----------------+             +----------------v-----------------+
   | dGPU VRAM (GDDR6X, max 24 GB)   |             | CPU + NPU + iGPU Rechenkerne     |
   | Bandbreite: 1008 GB/s           |             | Direkter Zero-Copy Zugriff       |
   +---------------------------------+             +----------------------------------+
AMD Strix Halo: 256-Bit Speicherarchitektur für Edge-Workstations
Mit der Strix-Halo-Plattform führte AMD eine mobile und Desktop-taugliche APU ein, die bis zu 128 GB LPDDR5X-Speicher über ein 256-Bit breites Speicherinterface adressiert:
$$\text{Theoretische Speicherbandbreite} = \frac{256 \text{ Bit}}{8 \text{ Bit/Byte}} \times 8533 \text{ MT/s} = 273.05 \text{ GB/s}$$
Da CPU, RDNA-3.5-Grafikeinheit und XDNA-2-NPU (bis zu 50 TOPS) denselben physischen Adressraum ohne PCIe-Transferkosten teilen, entfällt der Offloading-Overhead vollständig. Ein 70B-Modell in Q4_K_M (41.2 GB) belegt rund 33% des verfügbaren Unified Memory und erreicht ohne dedizierte GPU:
$$\text{Inferenzdurchsatz}_{\text{Strix Halo}} = \frac{273.05 \text{ GB/s} \times 0.80}{41.2 \text{ GB}} \approx 5.30 \text{ Tokens/s}$$
Dies ermöglicht autarke, mobile Edge-Server mit unter 120 Watt Leistungsaufnahme, die vollständige 70B-Modelle lokal im Speicher halten.
Apple Silicon M-Serie: Die Skalierung auf 512 GB Unified Memory
Apples Architektur nutzt 512-Bit bis 1024-Bit breite Speicherbusse in den Max- und Ultra-Konfigurationen:
- M4 Max: 512-Bit LPDDR5X-7500 $\implies 410 \text{ GB/s}$ Bandbreite, bis zu 128 GB Unified Memory.
- M-Serie Ultra (Dual-Die via UltraFusion): Bis zu 1024-Bit Bus $\implies 819.2 \text{ GB/s}$ Bandbreite, bis zu 512 GB Unified Memory.
Auf einem Mac Studio mit 192 GB RAM lässt sich ein quantisiertes DeepSeek-V3 oder DeepSeek-R1 (IQ2_XS / IQ3_M, ca. 165–220 GB Speicherbedarf) oder ein vollständiges Llama 3.1 405B in Q4_K_M (ca. 235 GB) ohne Cluster-Aufbau auf einem einzigen Desktop-Gerät betreiben.
Qualcomm Snapdragon X Elite / Oryon
Qualcomms Oryon-CPU mit integrierter Hexagon-NPU liefert 45 TOPS INT8-Rechenleistung bei einer Gesamtsystemleistung von 20 bis 45 Watt. Die primäre Rolle dieser dedizierten NPU-Kerne liegt in der Ausführung von Edge-Subsystemen:
- Kontinuierliche lokale Whisper-v3-Turbo Sprachtranskription im Hintergrund.
- On-Device Vektor-Embedding-Generierung (z.B. Nomic-Embed-Text mit 137M Parametern) bei 0 Watt GPU-Zusatzlast.
- Lokale Guardrail- und PII-Redaction-Filterung vor dem Weiterleiten von Anfragen.
+------------------+-----------------+--------------------+------------------+-------------------+
| Plattform / SoC  | Speichertyp &   | Speicherbandbreite | Max. Adressierb. | Typischer Strom-  |
|                  | Bus-Breite      | (Peak / Real)      | RAM (Unified)    | verbrauch (Last)  |
+------------------+-----------------+--------------------+------------------+-------------------+
| AMD Strix Halo   | LPDDR5X 256-bit | 273 GB/s / 218 GB/s| 128 GB           | 75 - 120 W        |
| Apple M4 Max     | LPDDR5X 512-bit | 410 GB/s / 348 GB/s| 128 GB           | 45 - 85 W         |
| Apple M2 Ultra   | LPDDR5 1024-bit | 800 GB/s / 680 GB/s| 192 GB           | 90 - 130 W        |
| Qualcomm X Elite | LPDDR5X 128-bit | 135 GB/s / 108 GB/s| 64 GB            | 20 - 45 W         |
| Intel Lunar Lake | LPDDR5X 128-bit | 136 GB/s / 110 GB/s| 32 GB            | 15 - 35 W         |
| Dual RTX 4090    | GDDR6X 384-bit  | 2016 GB/s aggregate| 48 GB (dediziert)| 650 - 900 W       |
+------------------+-----------------+--------------------+------------------+-------------------+
13.2 BitNet 1.58-Bit (b1.58) und alternative Architekturen
Die BitNet b1.58 Revolution: Eliminierung der Matrix-Multiplikation
Klassische neuronale Netze basieren auf generalisierten Matrix-Multiplikationen (GEMM) in Gleitkommapräzision:
$$Y = W \cdot X = \sum_{j} w_{ij} \cdot x_j \quad (w_{ij} \in \mathbb{R}_{\text{FP16/FP8}})$$
Jede Recheneinheit muss floating-point-fähige Multiplizierer und Akkumulatoren (MAC-Einheiten) vorhalten, die substanziell Siliziumfläche und Energie verbrauchen.
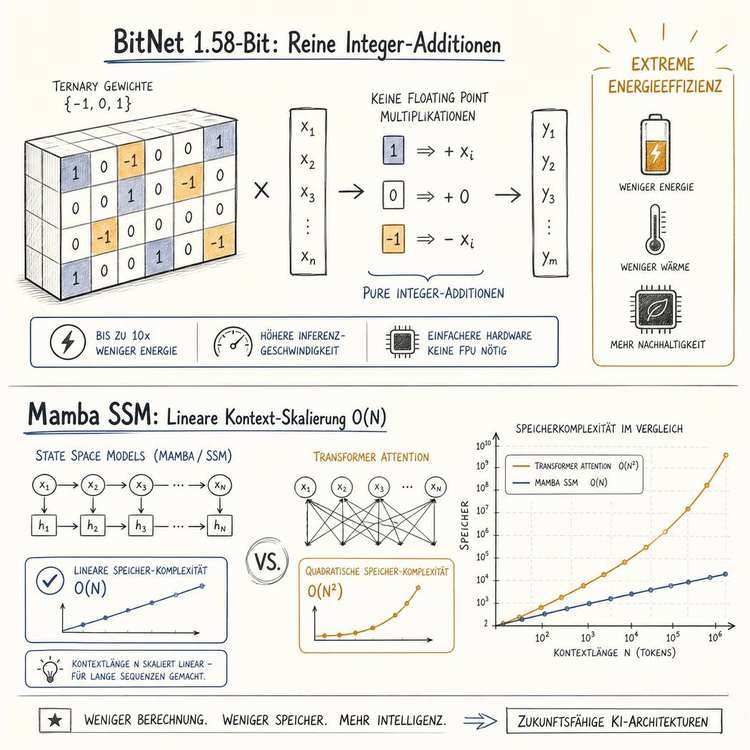
Das von Microsoft Research vorgestellte BitNet 1.58-Bit (b1.58) beschränkt die Gewichtsmatrix auf genau drei diskrete Zustände:
$$W \in {-1, 0, +1}^{m \times n}$$
Die Bezeichnung "1.58 Bit" leitet sich aus der theoretischen Informationskapazität ab:
$$\log_2(3) \approx 1.58496 \text{ Bits}$$
                TRANSFORMATION DER RECHENOPERATION IN BITNET B1.58

    Klassischer Transformer (FP16 / INT8):
    y_i = w_{i,1} * x_1 + w_{i,2} * x_2 + w_{i,3} * x_3 + ...   [FP/INT Multiplikationen + Additionen]

    BitNet b1.58 Architektur:
    w_{i,j} in {-1, 0, +1}

            +---- Falls w_{i,j} = +1  ===>   + x_j  (Addition)
    y_i = --+---- Falls w_{i,j} =  0  ===>   0      (Skip)
            +---- Falls w_{i,j} = -1  ===>   - x_j  (Subtraktion)

    Ergebnis: NULL Multiplikationen, 100% Integer-Additionen/Subtraktionen
Mathematische Quantisierungsmechanik in BitNet
Die Gewichtsmatrix wird während des Forward-Passes über die sogenannte Absmean-Quantisierung ternarisiert:
$$\tilde{W} = \text{RoundClip}\left(\frac{W}{\gamma + \epsilon}, -1, +1\right), \quad \gamma = \frac{1}{mn} \sum_{i,j} |W_{ij}|$$
Die Aktivierungen $X$ werden parallel auf $b$-Bit Integer (typischerweise INT8) skaliert:
$$\tilde{X} = \text{Quant}(X) = \text{Clip}\left(\left\lfloor \frac{X \cdot 2^{b-1}}{\max(|X|)} \right\rceil, -2^{b-1}, 2^{b-1}-1\right)$$
Die Matrixmultiplikation $Y = \tilde{W} \cdot \tilde{X}$ degeneriert zu reinen Integer-Additions- und Subtraktionsbäumen.
+------------------------------------------------------------------------------------+
| Metrik / Eigenschaft       | FP16 Transformer       | BitNet b1.58                 |
+------------------------------------------------------------------------------------+
| Rechenoperation            | Floating Point MAC     | Integer Add / Sub            |
| Energieeinsparung Arithm.  | Modellabhängig; Laborwert   | potenziell deutlich geringer   |
| Speicherbedarf 70B Modell  | ca. 141 GB Gewichte (FP16) | ca. 14 GB Rohgewichte bei 1,58 Bit, plus Overhead |
| Inferenz auf CPU (SIMD)    | Bandbreiten- und kernelabh. | benötigt geeignete BitNet-Implementierung       |
+------------------------------------------------------------------------------------+
[Deep Dive]
BitNet b1.58 reduziert die Gewichtsdarstellung auf drei Werte, garantiert aber weder eine bestimmte End-to-End-Energieeinsparung noch eine bestimmte RAM-Grenze. Bei 70B Parametern entsprechen 1,58 Bit rechnerisch rund 13,8 GB Rohdaten; Skalierungsfaktoren, Metadaten, Aktivierungen, Laufzeitpuffer und das konkrete Kernel-Layout kommen hinzu. Ein dedizierter Beschleuniger ist nicht zwingend, der Durchsatz hängt aber von einer passenden Implementierung und der Speicherbandbreite ab.
State Space Models (SSM) und Hybride: Mamba, Jamba und Griffin
Der quadratische Skalierungsaufwand der Standard-Attention-Mechanik $\mathcal{O}(N^2)$ führt bei langen Kontexten ($N > 64\text{k}$) zu stark ansteigenden Latenzen während des Prefilling und zu massivem KV-Cache-Wachstum.
       AUFMERKSAMKEITSSKALIERUNG: TRANSFORMER VS. STATE SPACE MODEL (SSM)

   Rechenaufwand / Speicher
     ^
     |                                      Transformer: O(N^2) Rechenaufwand,
     |                                      O(N) KV-Cache Speicherwachstum
     |                                         /
     |                                       /
     |                                     /
     |                                   /
     |                                 /
     |                             _--'
     |                    _..---'''
     |            _..---''
     |    _..---''                          SSM (Mamba): O(N) Rechenaufwand,
     |  ---------------------------------   O(1) konstanter State-Speicher
     +------------------------------------------------------------------>
     0                                32k              64k              128k
                                  Kontextlänge (Tokens)
Mamba (Selective State Space Model)
Mamba ersetzt die Aufmerksamkeitsmatrix durch eine zeitkontinuierliche Differentialgleichung, die über eine Input-abhängige Diskretisierung in eine zeitdiskrete Rekursion überführt wird:
$$h_t = \bar{A}t h{t-1} + \bar{B}_t x_t$$
$$y_t = C_t h_t + D x_t$$
$$\bar{A}_t = \exp(\Delta_t A), \quad \bar{B}_t = (\Delta_t A)^{-1}(\exp(\Delta_t A) - I) \cdot \Delta_t B_t$$
Entscheidend ist, dass $\Delta_t, B_t, C_t$ Funktionen des aktuellen Inputs $x_t$ sind (Selection Mechanism).
- Prefill-Phase: Berechenbar als paralleler Assoziativ-Scan in $\mathcal{O}(N)$ Zeit.
- Decoding-Phase: Konstanter Speicher- und Rechenaufwand $\mathcal{O}(1)$ unabhängig von der Position im Dokument, da kein historischer KV-Cache gespeichert werden muss, sondern lediglich der Zustand $h_t \in \mathbb{R}^{d_{\text{state}}}$.
Jamba (Hybrid Transformer-SSM + MoE)
Die von AI21 Labs entwickelte Jamba-Architektur kombiniert Transformer-Attention-Layer, Mamba-SSM-Layer und Mixture-of-Experts in einem festen Schichtverhältnis (z.B. 1:7 Transformer-zu-Mamba).
- Die Mamba-Layer komprimieren den globalen Kontext mit linearem Aufwand.
- Die wenigen Transformer-Layer sichern exaktes In-Context-Retrieval über Needle-in-a-Haystack-Aufgaben ab.
- Die MoE-Schichten halten die Rechenlast pro Token gering.
+------------------+-----------------+-------------------+-------------------+-------------------+
| Modell           | Architektur-    | Kontextfenster    | KV-Cache bei      | Throughput-       |
|                  | Typ             | (Tokens)          | 128k Kontext      | Skalierung        |
+------------------+-----------------+-------------------+-------------------+-------------------+
| Llama 3.3 70B    | Dense Transf.   | 131.072           | 41.2 GB (FP16)    | Fällt ab > 32k    |
| DeepSeek-V3      | MLA Transf.+MoE | 128.000           | 5.4 GB (MLA FP8)  | Stabil bis 64k    |
| Mamba-2 8B       | Reines SSM      | 1.000.000+        | 0 GB (O(1) State) | Linear O(N)       |
| Jamba 1.5 Large  | SSM + Trafo+MoE | 256.000           | ~4.8 GB           | Fast linear       |
+------------------+-----------------+-------------------+-------------------+-------------------+
13.3 Die strategische Koexistenz: Edge vs. Frontier Cloud
Die Enterprise-IT-Architektur der Jahre 2026+ konsolidiert sich nicht in einer "Entweder-Cloud-oder-Lokal"-Dichotomie, sondern in einem strikt hierarchischen Routing-Modell.
                    ENTERPRISE HYBRID AI-ROUTING TOPOLOGIE

                         +-----------------------------+
                         |       Client Anfrage        |
                         +--------------+--------------+
                                        |
                                        v
                         +-----------------------------+
                         | Lokaler Tier-0 Router       |
                         | (Qwen 2.5 0.5B / Fast Embed)|
                         | PII Maskierung / Sanitizing |
                         +--------------+--------------+
                                        |
                 +----------------------+----------------------+
                 |                                             |
   Komplexität: Standard / Intern                Komplexität: Hoch-Abstrakt
   Datenschutz: Streng Vertraulich                Datenschutz: Öffentlich / Pseudonym
                 |                                             |
                 v                                             v
   +---------------------------+                 +---------------------------+
   | Lokaler Tier-1 Cluster    |                 | Cloud Tier-2 Frontier     |
   | (Llama 3.3 70B / Qwen 72B)|                 | (OpenAI o1/o3, Claude 3.5)|
   | - Lokales RAG / Milvus    |                 | - Multi-Step Reasoning    |
   | - Interne Code-Inferenz   |                 | - Mathematische Theoreme  |
   | - ERP/CRM Tool Calling    |                 | - Seltene Fachdomänen     |
   | Latenz: 15-40 ms (TTFT)   |                 | Latenz: 2.000-15.000 ms   |
   | Kosten: 0.00 € / Token    |                 | Kosten: 15-60 € / M-Token |
   +---------------------------+                 +---------------------------+
Das 4-Stufen-Entscheidungsmodell für Workload-Platzierung
+-----------------------------------+-----------------------------------+
| Parameter / Anforderung           | Lokale On-Premise-Ausführung      | Cloud Frontier-Modelle            |
+-----------------------------------+-----------------------------------+
| Latenz-Garantie (SLA)             | TTFT < 50 ms, jitter-frei         | TTFT 800 - 4.000 ms (variabel)    |
| Datenschutz & Compliance          | DSGVO Art. 9, Berufsgeheimnis     | Standard-Datenverarbeitungsvertrag|
|                                   | (§ 203 StGB), Zero Data Egress    | (ZDR oft nur mit Enterprise-Plan) |
| System-Kopplung                   | Direkte SQL/DB-Kopplung im LAN    | API-Gateways mit DMZ-Tunnel       |
| Kostenstruktur                    | Hohe Fixkosten (CapEx),           | Variable Kosten (OpEx),           |
|                                   | Grenzkosten pro Token ~0.00 EUR   | Skaliert linear mit Token-Volumen |
| Reasoning-Tiefe (ARC-AGI, MATH)   | Hoch (Llama 3.3 70B / Qwen 72B)   | Maximal (o1, o3, Claude Opus)     |
| Anpassbarkeit (Fine-Tuning/LoRA)  | Vollständiger Zugriff auf Layer,  | Stark limitierte Fine-Tuning-APIs,|
|                                   | Gewichte und Logits               | keine Weight-Transparenz          |
+-----------------------------------+-----------------------------------+
[Architektur-Hinweis]
Semantisches Routing im Produktivbetrieb: In modernen Setups bewertet ein lokales SLM (z.B. Qwen 2.5 3B) jede Anfrage nach drei Vektoren:
- PII-Score: Enthält der Prompt personenbezogene oder geschäftskritische Daten? $\implies$ Bei Score $> 0$ immer lokaler Pfad.
- Intention & Tool-Bedarf: Kann die Anfrage über lokale RAG-Vektordatenbanken und SQL-Tools gelöst werden? $\implies$ Lokaler Pfad.
- Reasoning-Komplexitäts-Index: Erfordert die Anfrage formale Beweisführung oder cross-disziplinäre Hypothesenbildung? $\implies$ Nur bei expliziter Freigabe Weiterleitung an Cloud-Frontier-Modelle.
Über dieses Schema werden in typischen Enterprise-Workloads 85 bis 92 Prozent aller Token-Volumina lokal verarbeitet, was die API-Kosten drastisch senkt und Compliance-Anforderungen deterministisch absichert.
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.