Glossar & Audit
Begriffe, Checklisten und Readiness-Fragen.
Begriffe, Checklisten und Readiness-Fragen. Lies zuerst die Kurzantwort und springe danach in die technische Herleitung.
Anhang: Technisches Fachglossar & Enterprise Audit-Checkliste
A.1 Vollständiges Fachglossar (Core Reference)
- AWQ (Activation-Aware Weight Quantization): Post-Training-Quantisierungsverfahren für GPUs, das durch Analyse der Aktivierungsverteilung das oberste 1% der funktional kritischen Gewichte (Salient Weights) schützt und den Rest verlustarm auf 4-Bit-Ganzzahlen skaliert.
- BitNet 1.58-Bit (b1.58): Neuronale Netzarchitektur mit ternären Gewichten ${-1, 0, +1}$, bei der teure Gleitkomma-Matrixmultiplikationen durch reine vorzeichenbehaftete Integer-Additionen ersetzt werden.
- Continuous Batching (Iteration-level Scheduling): Dynamisches Scheduling-Verfahren in Inferenz-Servern (wie vLLM), das fertige Sequenzen nach jedem generierten Token sofort aus dem Batch entfernt und neue Anfragen ohne Wartezeit einfügt.
- Cross-Encoder: Neuronales Re-Ranking-Modell, das Query und Dokument gemeinsam als zusammenhängendes Tokenpaar verarbeitet und durch vollständige Cross-Attention eine präzisere Relevanzbewertung als reine Vektordistanzberechnungen liefert.
- CUDA (Compute Unified Device Architecture): Proprietäre parallele Programmier- und Rechenplattform von NVIDIA zur direkten Ansteuerung von GPU-Hardware und Tensor-Kernen.
- Embedding: Die Abbildung von Texten, Tokens oder Entitäten in einen kontinuierlichen, hochdimensionalen Vektorraum ($\mathbb{R}^d$), in dem semantische Ähnlichkeit als geometrische Distanz (z.B. Cosine Similarity) messbar ist.
- EXL2 (ExLlamaV2 Format): Hochoptimiertes Quantisierungsformat für NVIDIA-GPUs mit variabler Bitrate pro Layer (z.B. 2.2 bis 8.0 Bits/Weight), das Sub-Bit-Präzisionen ohne signifikanten Perplexity-Anstieg ermöglicht.
- Function Calling (Tool Use): Die Fähigkeit eines Sprachmodells, strukturierte Funktionsaufrufe (meist JSON) anhand einer vorgegebenen API-Definition zu generieren, um externe Systeme, Datenbanken oder Skripte deterministisch anzusteuern.
- GGUF (GPT-Generated Unified Format): Universelles, binäres Dateiformat von
llama.cppfür CPU- und GPU-Inferenz, das Modellarchitektur, Tokenizer, Metadaten und hierarchisch block-quantisierte Tensoren (K-Quants, IQ-Quants) in einer einzigen Datei kapselt. - GQA (Grouped-Query Attention): Optimierte Attention-Mechanik, bei der sich mehrere Query-Heads einen gemeinsamen Key- und Value-Head teilen, wodurch der KV-Cache-Speicherbedarf bei minimalem Qualitätsverlust drastisch sinkt.
- LoRA (Low-Rank Adaptation): Parameter-effiziente Fine-Tuning-Methode, die die Gewichtsänderungsmatrix $\Delta W \in \mathbb{R}^{d \times k}$ in zwei niedrigrangige Matrizen $B \in \mathbb{R}^{d \times r}$ und $A \in \mathbb{R}^{r \times k}$ mit Rang $r \ll \min(d, k)$ zerlegt und nur diese trainiert.
- MCP (Model Context Protocol): Von Anthropic initiierter offener Standard zur standardisierten, sicheren Anbindung von LLMs an externe Kontextquellen, Entwicklungsumgebungen, Tools und Unternehmensdatenbanken über JSON-RPC.
- MLA (Multi-Head Latent Attention): Von DeepSeek entwickelte Attention-Architektur, die Key- und Value-Tensoren vor dem Caching in einen niedrigdimensionalen latenten Vektor komprimiert und den KV-Cache-Footprint um bis zu 87% reduziert.
- MoE (Mixture of Experts): Modellarchitektur, die dichte Feed-Forward-Schichten durch mehrere spezialisierte Experten-Netzwerke ersetzt, von denen ein dynamisches Gating-Netzwerk pro Token nur eine kleine Teilmenge (Top-$k$) aktiviert.
- PagedAttention: Speicherverwaltungsmethode für den KV-Cache nach dem Vorbild des virtuellen Speichermanagements in Betriebssystemen, die unzusammenhängende physische Speicherseiten alloziert und VRAM-Fragmentierung eliminiert.
- Perplexity (PPL): Die exponentiierte Kreuzentropie eines Modells über einen Testtext ($\text{PPL} = \exp(-\frac{1}{N}\sum \log P(x_i|x_{<i}))$, die misst, wie überrascht das Modell von den tatsächlichen Folgetokens ist (niedrigere Werte bedeuten höhere Vorhersagegüte).
- QLoRA (Quantized Low-Rank Adaptation): Fine-Tuning-Verfahren, das das Basismodell in einen 4-Bit-NormalFloat-Datentyp (NF4) quantisiert und Gradienten durch doppelte Quantisierung und paged Optimizers in 16-Bit-LoRA-Adapter zurückpropagiert.
- Quantization Error: Die akkumulierte numerische Differenz zwischen den originalen Gleitkommagewichten/-aktivierungen und ihren diskretisierten Integer-Repräsentationen.
- RAG (Retrieval-Augmented Generation): Systemarchitektur, die Prompts vor der Modellgenerierung dynamisch mit relevanten Passagen anreichert, die aus Vektor- oder Volltext-Indizes abgerufen wurden.
- Reranking: Zweistufiger Filterprozess im Retrieval, bei dem eine grobe Kandidatenmenge (z.B. Top-50 via Vektorsuche) durch ein rechenintensiveres Modell auf die hochrelevanten Top-$k$ Dokumente nachsortiert wird.
- ROCm (Radeon Open Compute): AMDs quelloffener Software-Stack und Treiber-Architektur zur Ausführung von GPU-Computing- und Deep-Learning-Workloads auf AMD-Radeon- und Instinct-Hardware.
- RoPE (Rotary Position Embedding): Positionskodierungsverfahren, das relative Positionsinformationen durch Multiplikation der Query- und Key-Vektoren mit einer zweidimensionalen Rotationsmatrix direkt im komplexen Raum einbettet.
- TPS (Tokens Per Second): Durchsatzmetrik für die Generierungsgeschwindigkeit eines Sprachmodells, berechnet als Quotient aus erzeugten Tokens und benötigter Generierungszeit.
- TTFT (Time To First Token): Latenzmetrik, die die Zeitspanne vom Absenden des Prompts bis zur Ausgabe des allerersten generierten Tokens (inklusive Prompt-Processing- und Prefill-Phase) misst.
- Vector DB (Vektordatenbank): Spezialisiertes Datenbanksystem (z.B. Qdrant, Milvus, pgvector) zur performanten Speicherung, Indexierung (z.B. HNSW, IVF) und Ähnlichkeitssuche von hochdimensionalen Vektoren über Distanzmetriken.
- VRAM (Video Random Access Memory): Hochgeschwindigkeits-Grafikspeicher (z.B. GDDR6X, HBM3) auf Beschleunigerkarten, dessen Bandbreite und Kapazität den primären limitierenden Faktor für LLM-Inferenz darstellen.
- Zero Data Retention (ZDR): Vertragliche und technische Garantie, dass eingehende Prompts, verarbeitete Daten und generierte Ausgaben nach Abschluss des Inferenzzyklus weder persistiert noch für Trainingszwecke verwendet werden.
A.2 Enterprise Audit-Checkliste: "Ist mein Unternehmen bereit für lokale KI?"
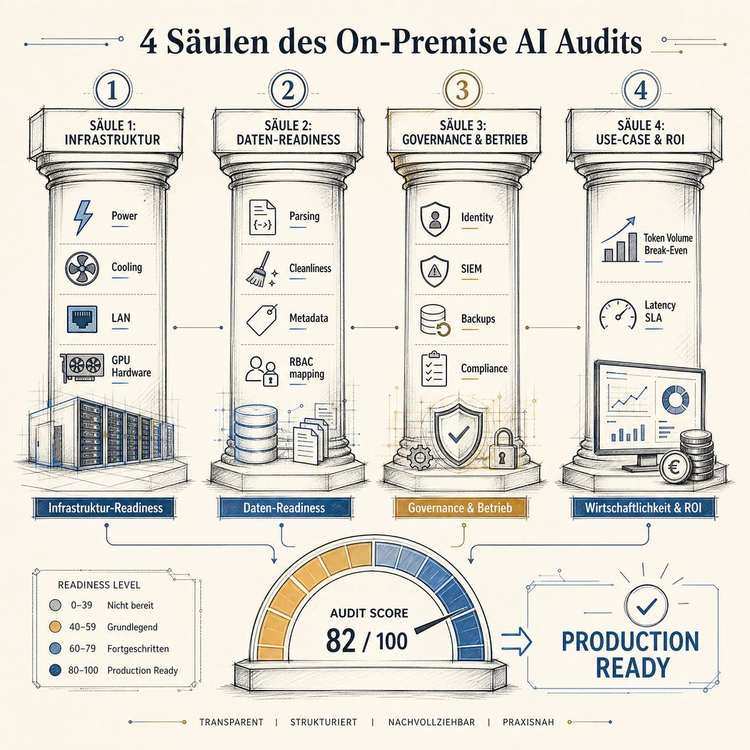
Die erfolgreiche Einführung lokaler Inferenzsysteme scheitert in der Praxis selten an den Sprachmodellen selbst, sondern an unzureichender Dimensionierung von Infrastruktur, Berechtigungsstrukturen, Betriebs-Know-how oder wirtschaftlicher Fehlkalkulation. Die folgende 4-Säulen-Checkliste definiert die verbindlichen Prüfkriterien vor der Beschaffung und Inbetriebnahme von On-Premise-LLM-Infrastrukturen.
+----------------------------------------------------------------------------------------------------+
|                                DIE 4 SÄULEN DES ON-PREMISE AI-AUDITS                               |
|                                                                                                    |
|  [ SÄULE 1: INFRASTRUKTUR ]       [ SÄULE 2: DATEN-READINESS ]                                     |
|  * Elektrische Dauerlast & Phasen  * Dokumenten-Parsing & semantische Qualität                     |
|  * Kühlkapazität & Delta-T         * RBAC-Spiegelung & Berechtigungsfilter                         |
|  * PCIe-Topologie & Bus-Bandbreite * Metadaten-Architektur & Chunking                              |
|  * Low-Latency LAN-Infrastruktur   * Data-Hygiene & PII-Vorbereitung                               |
|                                                                                                    |
|  [ SÄULE 3: GOVERNANCE & BETRIEB ] [ SÄULE 4: USE-CASE & ROI ]                                     |
|  * Lokales Logging & SIEM          * Token-Volumen vs. Grenzkosten-Break-Even                      |
|  * Rollen- & API-Key-Management   * SLA- & Latenz-Anforderungen (TTFT/TPS)                         |
|  * Model-Lifecycle & Patching      * Deterministische Fehlertoleranz                               |
|  * Juristische Compliance          * Integrationsaufwand (MCP/REST/SQL)                            |
+----------------------------------------------------------------------------------------------------+
Säule 1: Infrastruktur- & Hardware-Readiness
-
[ ] 1.1 Stromversorgung und Dauerlast-Absicherung
- Ist am Aufstellungsort eine kontinuierliche Leistungsaufnahme von mindestens $1.5\text{ kW}$ pro 4-GPU-Knoten (bzw. $3.5\text{ kW}$ für 8-GPU-Racks) auf einer dedizierten, abgesicherten Phase (16A CEE oder redundante USV-Stränge) gewährleistet?
- Existiert eine Online-USV (VFI-Klasse), die Lastspitzen beim Übergang vom Idle- in den Prefill-Zustand (Transienten bis zu $600\text{ W}$ innerhalb von $5\text{ ms}$) ohne Spannungseinbruch abfängt?
-
[ ] 1.2 Thermisches Management und Kühlleistung
- Verfügt der Serverraum über eine klimatisierte Abfuhrkapazität von mindestens $5.000\text{ BTU/h}$ pro GPU-Node bei kontinuierlichem Volllastbetrieb?
- Bei Workstation-Einsatz: Sind Blower-Style-Kühler verbaut oder ist der axiale Airflow im Gehäuse so konzipiert, dass die Abwärme der primären GPU nicht die darüberliegende Karte thermisch drosselt (Thermal Throttling $> 83^\circ\text{C}$)?
-
[ ] 1.3 PCIe-Topologie und Interconnect-Bandbreiten
- Unterstützt das Mainboard mindestens PCIe 4.0 oder 5.0 mit echten x16/x16-Lanes (ohne Switch-Downgrade auf x8/x4 bei Multi-GPU-Bestückung), um Tensor-Parallel-All-Reduce-Operationen nicht zu blockieren?
- Wurde sichergestellt, dass bei heterogenem Offloading (CPU+GPU) die Bus-Latenz nicht den Inferenzdurchsatz unter die Mindestanforderung drückt?
-
[ ] 1.4 Netzwerk- und Speicheranbindung
- Sind die Inferenz-Server mit mindestens 10 GbE (besser 25/100 GbE RoCE/InfiniBand) an die internen Vektordatenbanken und Quellsysteme angebunden?
- Liegen die Modellgewichte (
.gguf,.safetensors) auf lokalem NVMe-Speicher (PCIe 4.0 x4, sequentielles Lesen $\ge 5000\text{ MB/s}$), um Kaltstartzeiten unter 10 Sekunden zu halten?
Säule 2: Daten- & Retrieval-Readiness
-
[ ] 2.1 Dokumentenqualität und Parsing-Pipeline
- Werden unstrukturierte Dokumente (PDF, DOCX, Scans) über deterministische OCR- und Layout-Parser (z.B. unstructured, Docling) verarbeitet, anstatt Roh-Text ohne Tabellen- und Überschriftenhierarchien zu extrahieren?
- Ist die semantische Chunking-Strategie an die Ziel-Kontextfenster und Embedding-Dimensionen angepasst (z.B. 512 Tokens mit 10% Overlap)?
-
[ ] 2.2 Berechtigungs- und Identitäts-Spiegelung (RBAC)
- Werden Berechtigungsstrukturen aus Active Directory, LDAP oder SharePoint direkt auf Chunk-Ebene in der Vektordatenbank als Metadaten-Filter abgebildet?
- Ist sichergestellt, dass der Retriever ausschließlich Dokumente zurückliefert, für die der anfragende Benutzer im Quellsystem leseberechtigt ist (Pre-Retrieval Filtering)?
-
[ ] 2.3 Metadaten-Architektur und Hybrid-Search
- Unterstützt die Vektordatenbank hybride Abfragen (Kombination aus Dense Vector Search und Sparse BM25-Volltextsuche) mit anschließendem Reciprocal Rank Fusion (RRF) oder Cross-Encoder Re-Ranking?
- Werden Zeitstempel, Versionsnummern und Dokumentenstatus (z.B. "gültig", "archiviert") als feste Payload-Attribute mitgeführt und vor dem RAG-Inferenzschritt validiert?
-
[ ] 2.4 Daten-Hygiene und PII-Sanitizing
- Werden sensible Kundendaten oder Authentifizierungs-Token (Passwörter, API-Keys) vor dem Embedding-Prozess durch lokale NLP-Filter (z.B. Microsoft Presidio) maskiert oder pseudonymisiert?
Säule 3: Governance-, Betriebs- & Kompetenz-Readiness
-
[ ] 3.1 Betriebskompetenz und Deployment-Automatisierung
- Verfügt das interne IT-Team über fundierte Kenntnisse in Containerisierung (Docker, Podman, Kubernetes/K3s), NVIDIA-Container-Toolkit und Inferenz-Engines (vLLM, Ollama, llama.cpp, TGI)?
- Sind System-Metriken (GPU VRAM Allocation, GPU Core Utilization, TTFT, TPS, Queue Depth) über Prometheus und Grafana an das zentrale Firmen-Monitoring angebunden?
-
[ ] 3.2 API-Management und Rollenbasierter Zugriff (RBAC)
- Ist der Inferenz-Cluster durch ein API-Gateway (z.B. LiteLLM Proxy, Kong) geschützt, das Token-Ratenbegrenzungen (Rate Limiting), Quotas pro Abteilung und OpenAI-kompatible Authentifizierung erzwingt?
- Werden Zugriffe lückenlos auditiert, ohne dass Klartext-Prompts gegen Datenschutzrichtlinien verstoßen?
-
[ ] 3.3 Lifecycle-Management und Modell-Governance
- Existiert ein definierter Freigabeprozess für neue Modellversionen (Regressionstests auf internen Benchmark-Datensätzen für Genauigkeit, JSON-Syntax-Treue und Halluzinationsrate vor Rollout)?
- Werden quantisierte Modellgewichte aus verifizierten Quellen (GPG-signierte HuggingFace-Repos) bezogen und vor dem Produktiv-Laden per SHA256-Prüfsumme validiert?
-
[ ] 3.4 Rechtliche Compliance und Betriebsvereinbarungen
- Liegt eine Freigabe des Datenschutzbeauftragten (DSB) und ggf. des Betriebsrats für den lokalen Betrieb vor (unter Berücksichtigung des EU AI Acts für interne Klassifizierungen)?
- Ist vertraglich und technisch dokumentiert, dass lokale Modelle keine Telemetriedaten an Dritte übertragen (Air-Gapped- oder Firewall-Blockade ausgehender Verbindungen)?
Säule 4: Use-Case-Validierung & ROI-Kalkulation
-
[ ] 4.1 Grenzkosten- und Break-Even-Analyse
- Übersteigt das prognostizierte monatliche Token-Volumen die Amortisationsschwelle gegenüber Cloud-APIs (typischerweise ab ca. 30–50 Millionen verarbeiteten Tokens pro Monat bei einem 70B-System)?
- Wurden Total Cost of Ownership (TCO) inklusive Stromkosten ($0.30\text{ EUR/kWh} \times 24 \times 365 \times 0.6\text{ kW} \approx 1.576\text{ EUR/Jahr}$), Kühlung, Abschreibung und Wartung eingerechnet?
-
[ ] 4.2 Latenz- vs. Genauigkeits-Profilierung
- Wurde für jeden Anwendungsfall geprüft, ob ein kleineres Modell (8B bis 32B) mit Fine-Tuning oder strukturiertem RAG ausreicht, anstatt unnötig Hardwarekapazitäten mit 70B+ Modellen zu blockieren?
- Erfordert der Use Case strikte Latenzgarantien (z.B. Kundenservice-Voicebot mit TTFT $< 300\text{ ms}$), die durch Cloud-APIs nicht stabil erbracht werden können?
-
[ ] 4.3 Fehlertoleranz und Fallback-Strategie
- Ist die Anwendung so konzipiert, dass Parsing-Fehler oder Modell-Halluzinationen durch Output-Validatoren (z.B. Pydantic, Instructor, Outlines mit Grammars) deterministisch abgefangen werden?
- Existiert ein Fallback-Mechanismus (z.B. automatische Weiterleitung an ein alternatives lokales Modell oder einen gesicherten Cloud-Endpunkt bei Hardware-Überlastung)?
-
[ ] 4.4 Standardisierte Systemintegration
- Werden externe Werkzeuge und Datenquellen über offene Standards wie das Model Context Protocol (MCP) oder standardisierte OpenAPI-Schemas angebunden, um Vendor-Lock-in zu vermeiden?
Enterprise Readiness Scorecard (Auswertung)
+------------------------------------------------------------------------------------+
| Erfüllte Prüfpunkte       | Status                  | Empfohlene Maßnahme          |
+------------------------------------------------------------------------------------+
| 14 - 16 Punkte (88-100%)  | Produktionsreif         | Freigabe für Pilotbetrieb    |
| 10 - 13 Punkte (62-81%)   | Bedingt bereit          | Nachbesserung Säulen 1 & 2   |
| < 10 Punkte (< 60%)       | Nicht produktionsreif   | PoC in isolierter Sandbox    |
+------------------------------------------------------------------------------------+
Kapitelinhalt: technische Herleitung und redaktionelle Einordnung; zeitabhängige Werte vor Einsatz prüfen.